從一人 AI 工作流到團隊工程系統
會議重點
本議程以講者豪在一人專案與 Side Project 的實踐為起點,說明如何讓需求、設計、規則與驗證機制成為 AI 可讀取、執行及接受回饋的工程環境。核心是將程式碼產出轉化為可維護的交付成果,再透過共享、分發與治理累積團隊工程資產;團隊導入仍在推動與驗證中。
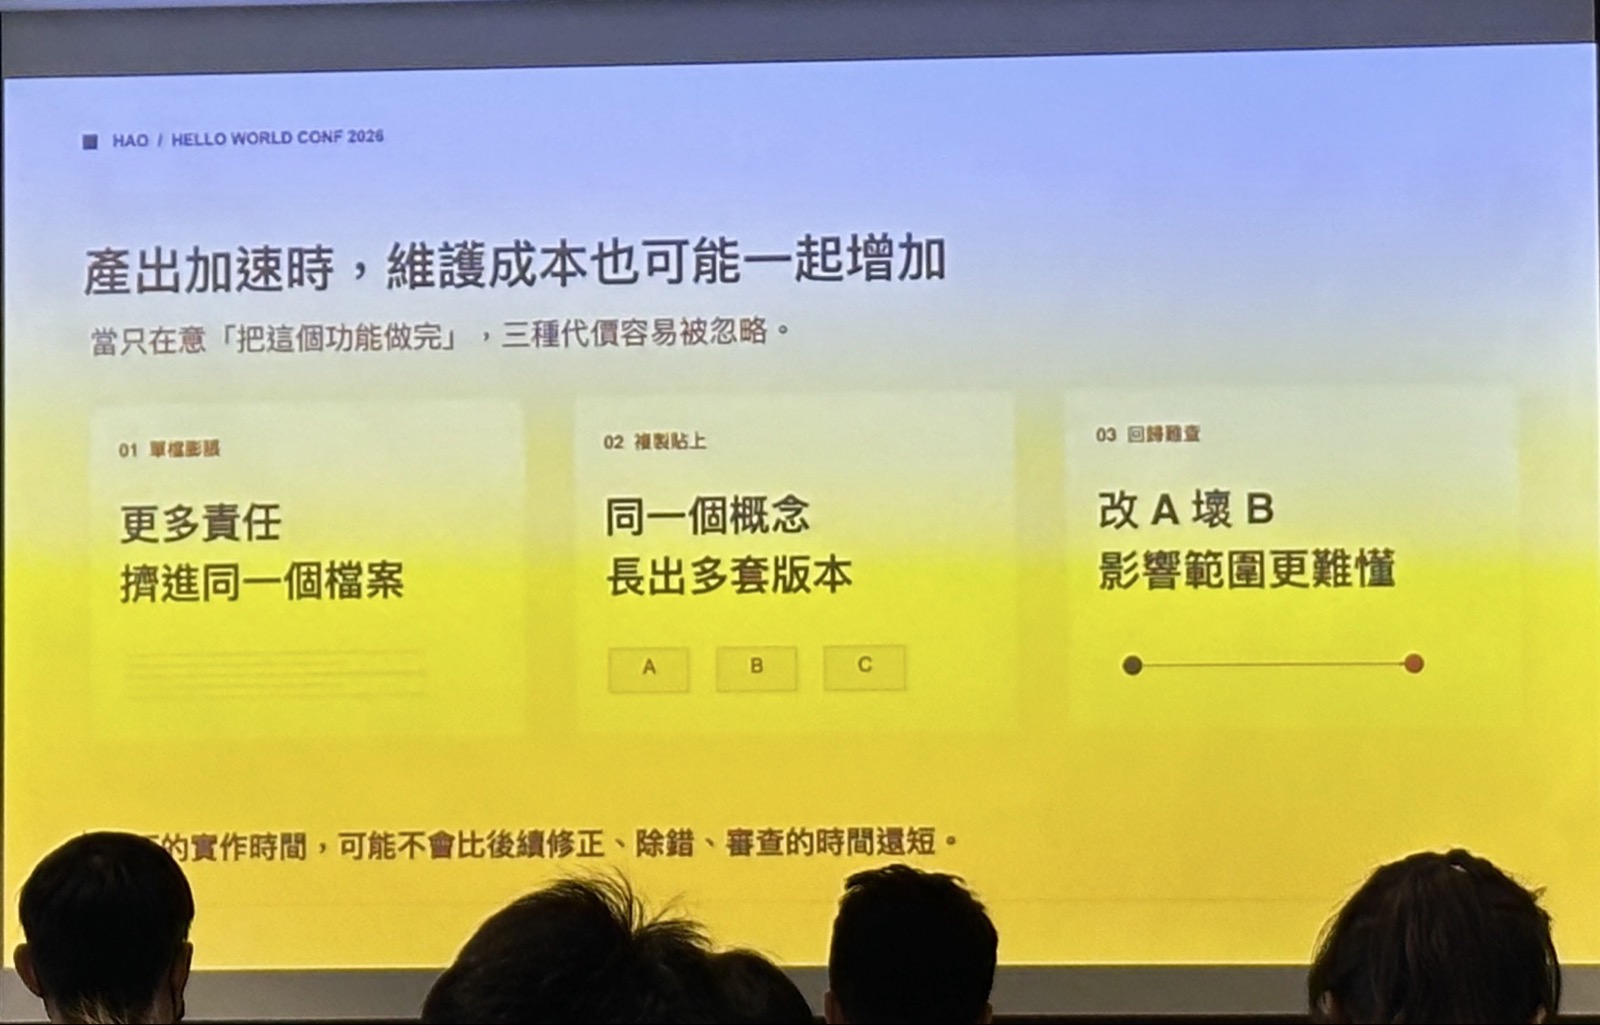
- 產出速度不等於交付速度;重複實作與模組耦合可能抵銷 AI 節省的實作時間。
- 先對齊需求與驗收條件,再以文件、policy、測試及工具建立明確邊界。
- 確定性規則交由工具檢查,需要工程判斷的問題由 review agent 與人共同審查,最終責任仍在人。
- 從最痛的問題逐步補強;個人流程驗證有效後,再評估共享價值與團隊治理。
待辦追蹤
- 與團隊討論測試、核心 domain 及重要腳本的版控與同步範圍,釐清一次性內容與值得共同維護的工程資產。
討論摘錄
AI 加速產出背後的維護風險
AI 加快程式碼產出,不代表交付也會加快。講者豪指出,若未明確提供目標、規則與回饋機制,快速生成的程式碼可能累積重複實作與耦合,讓後續修正、除錯及 review 的成本超過省下的實作時間。
- 大型檔案:AI 持續將程式碼塞入同一個檔案,可能累積至上千行甚至上萬行。
- 重複實作:為求方便使用 Copy Paste,違反 DRY 原則,使相同邏輯散落各處。
- 影響範圍不明:大量耦合與重複實作增加「改A壞B」的風險,新增或修改功能時難以掌握變更的爆炸半徑。
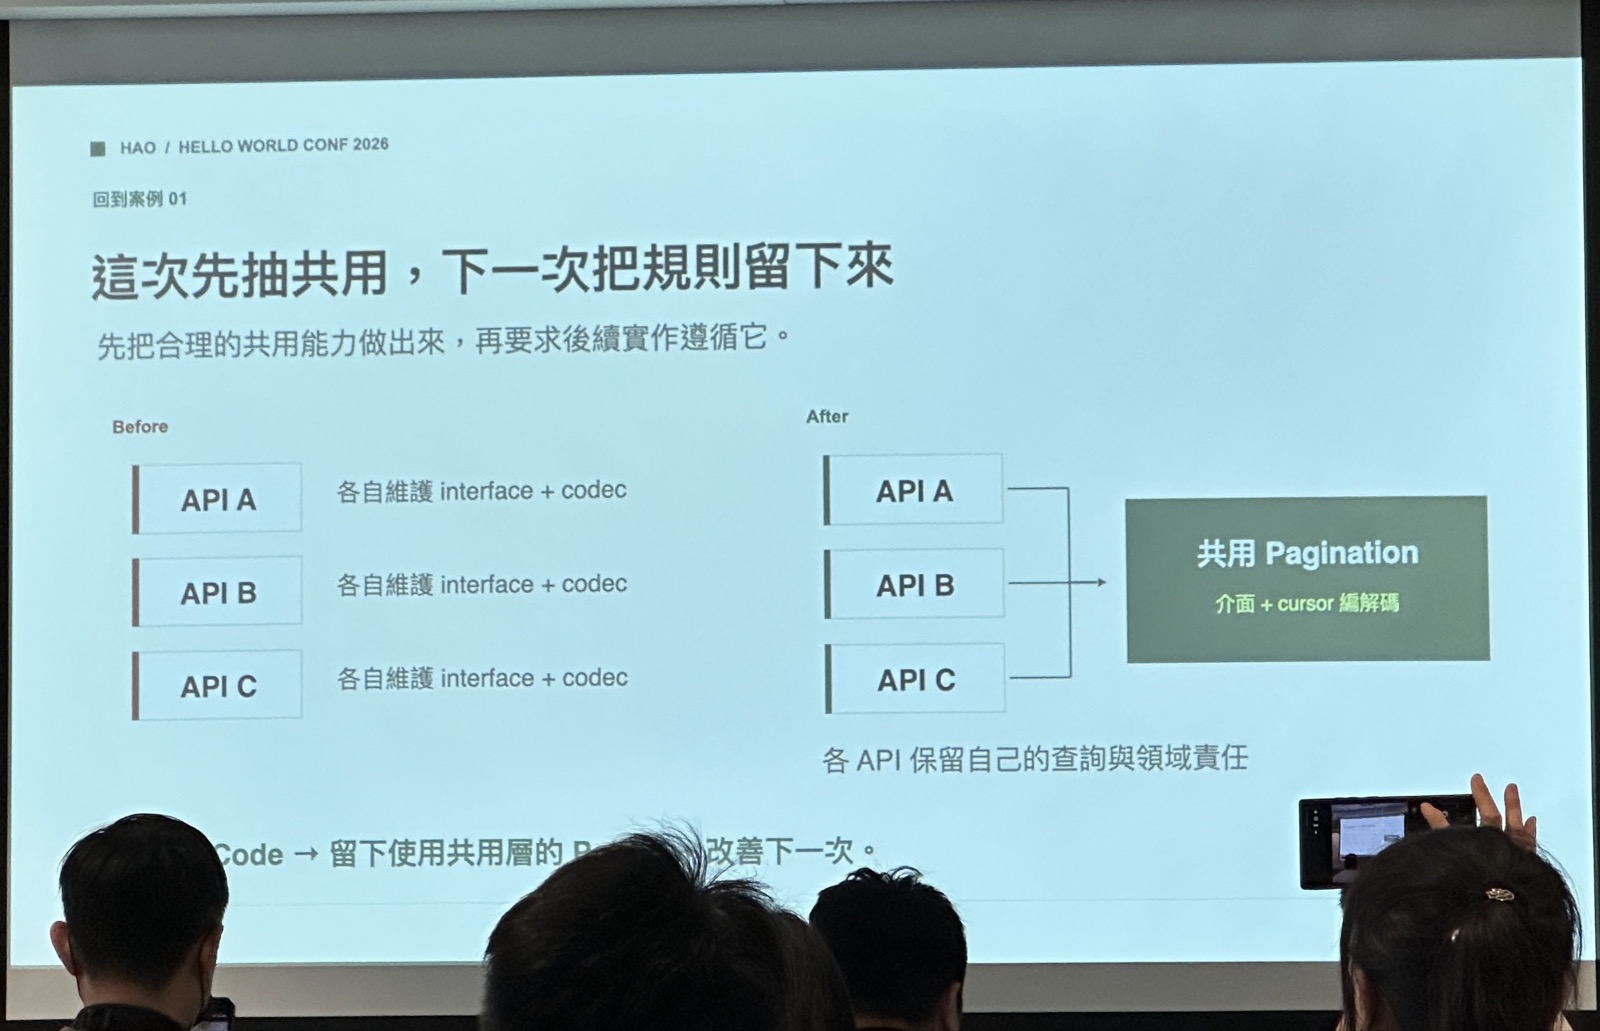
Cursor-Based Pagination API 是具體案例。既有 Codebase 已有至少五支相似 API,interface 與 encode、decode 邏輯大致相同,卻各自實作,未整理共用層。新增 API 時,AI 再複製一份既有程式碼;這次改動範圍雖小,也不會破壞其他 API,但未來若要統一調整 Pagination 的 interface 或實作方式,就必須修改多個位置。
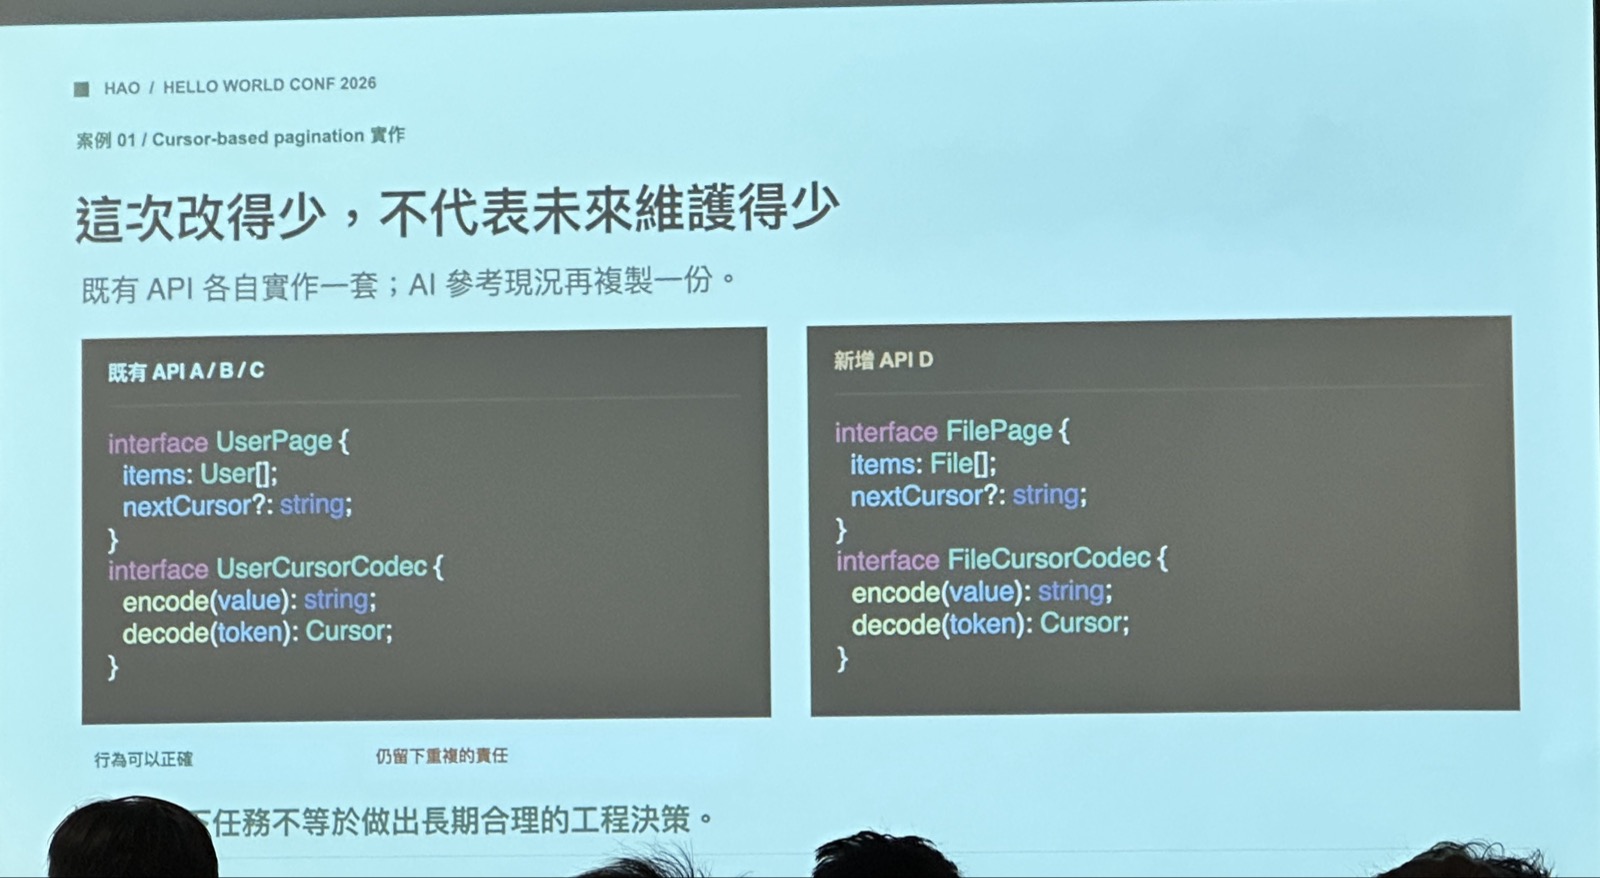
豪強調,這類問題在 AI 出現前就已存在,只是產出速度提升後,累積得更快。落差不在於 AI 無法完成任務,而在於它選擇的完成方式,未必符合工程師對長期維護的期待;若期待只留在工程師腦中,AI 並不知道應如何取捨。
模組依賴也有相同風險。在 Controller、Service、Repository 的分層架構中,豪不希望 Repository 反向依賴 Service,也不希望 Service 反向依賴 Controller。然而,這些規則既未告知 AI,也沒有工具檢查。AI 為重用 Controller 中的常數,直接在 Service 中 import Controller;程式雖然編譯通過,預期的模組邊界卻已被打破。
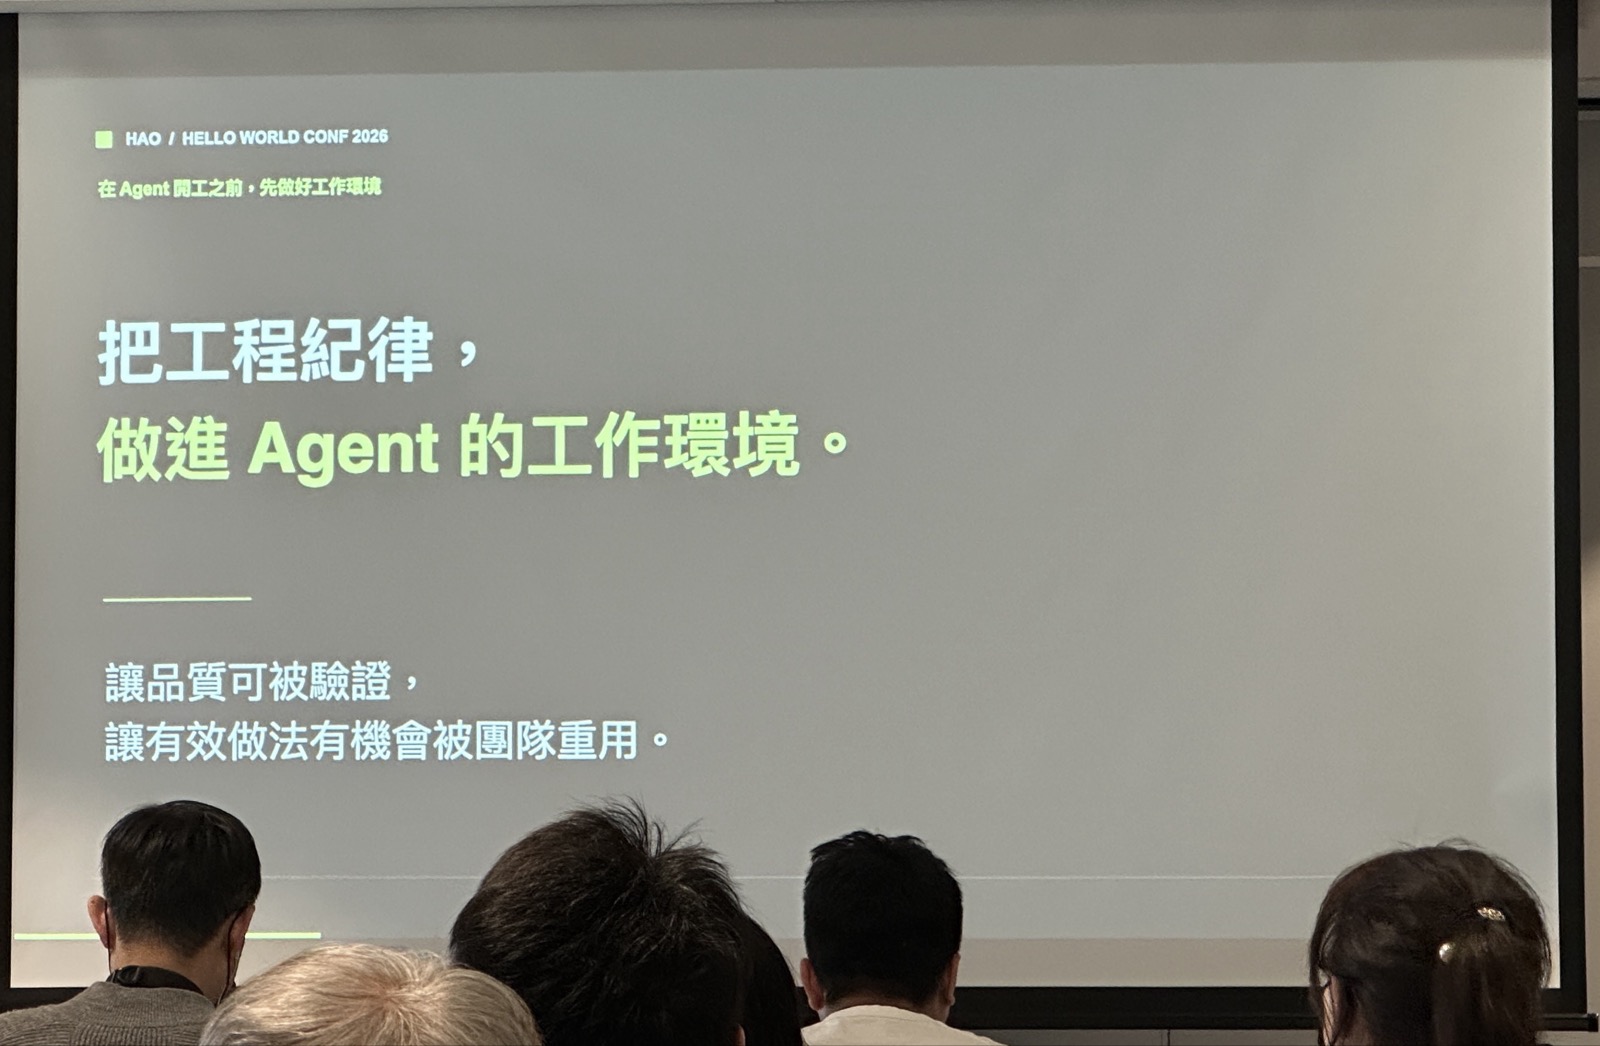
豪將工程師的責任定位為打造工程紀律與工作環境,而非只要求 AI 更快生成程式碼。當有效做法能被重用、共同維護,才有機會將個人的效率提升延伸至團隊,並避免把省下的實作時間轉化為更重的維護負擔。
需求共識與可執行的拆單流程
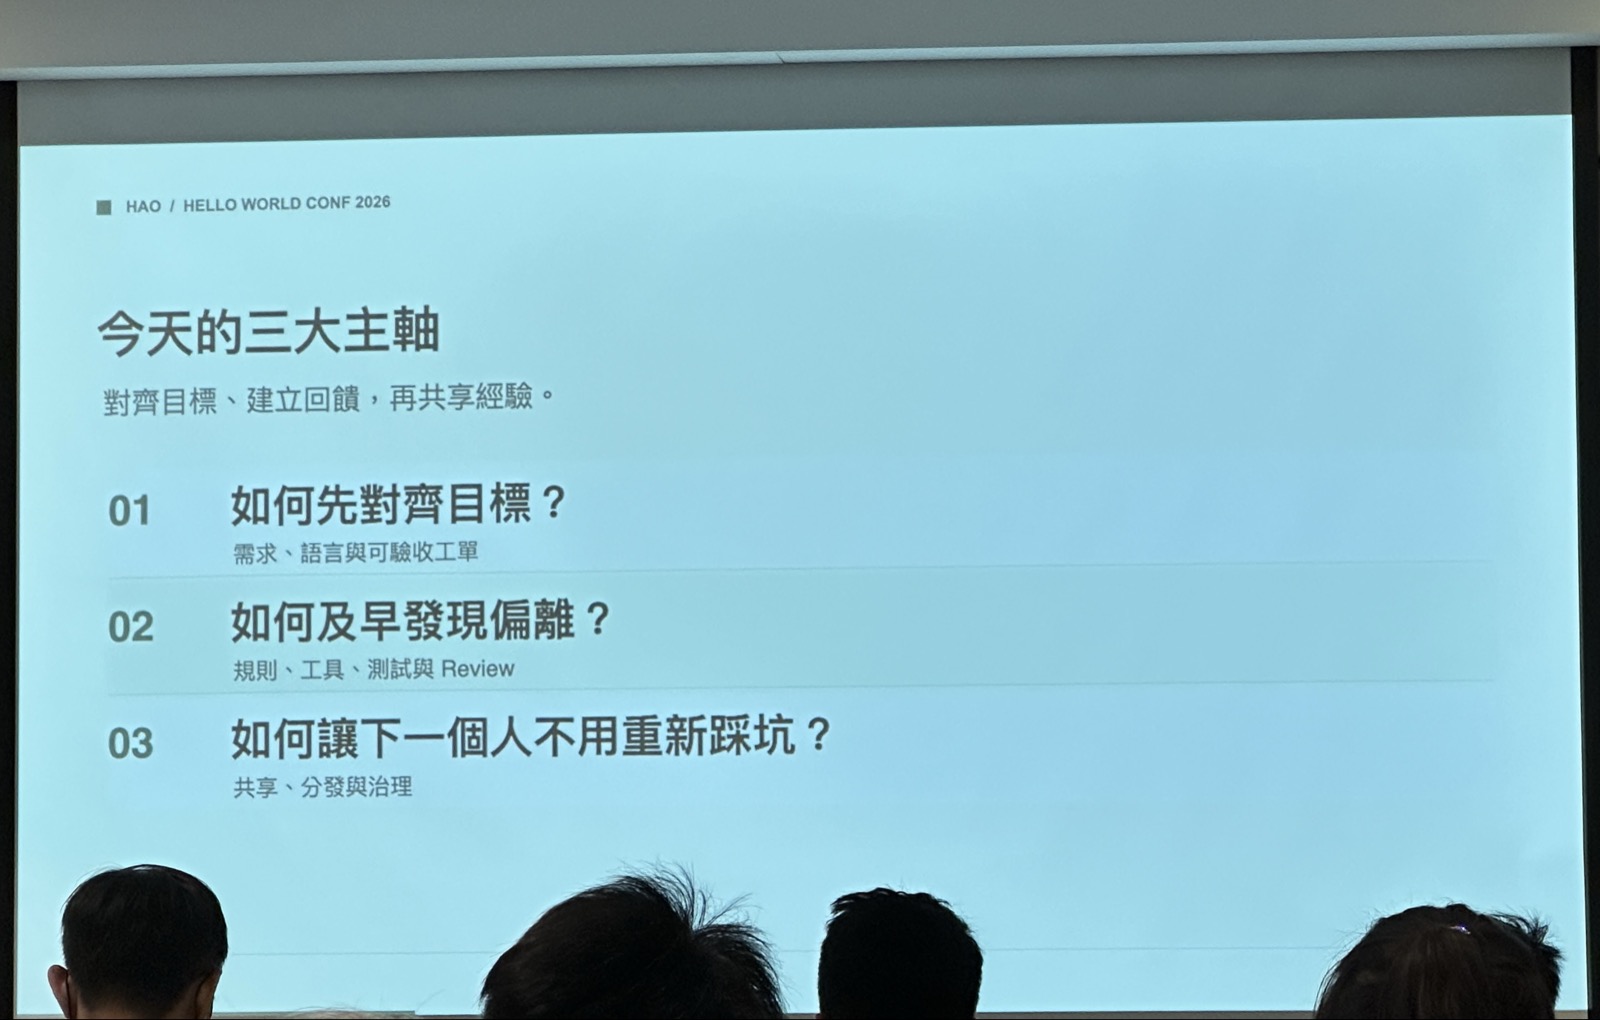
需求流程的核心,是先與 AI 取得共識,再將共識轉成可執行、可驗證的工作。講者豪以三個問題作為流程設計的起點:開發前如何對齊需求、實作偏離時如何及早發現,以及有效做法如何讓下一個人或下一個專案不必重新踩坑。
收到 PM 的功能需求後,講者不再直接要求 AI 修改程式,而是先使用自行打造的 Idea-discussion Skill,討論目標、限制、要做與不做的範圍,以及需求如何落地到既有專案。重點不是立即產出程式碼,而是確認雙方對工作內容有一致理解。
取得共識後,再透過 to-tickets Skill,依特定模板拆成帶有驗收條件的工單。這兩個 Skill 分別承擔需求釐清與工作拆解,目的在於讓討論結果不只停留在對話,而能成為後續可執行、可驗證的工作。
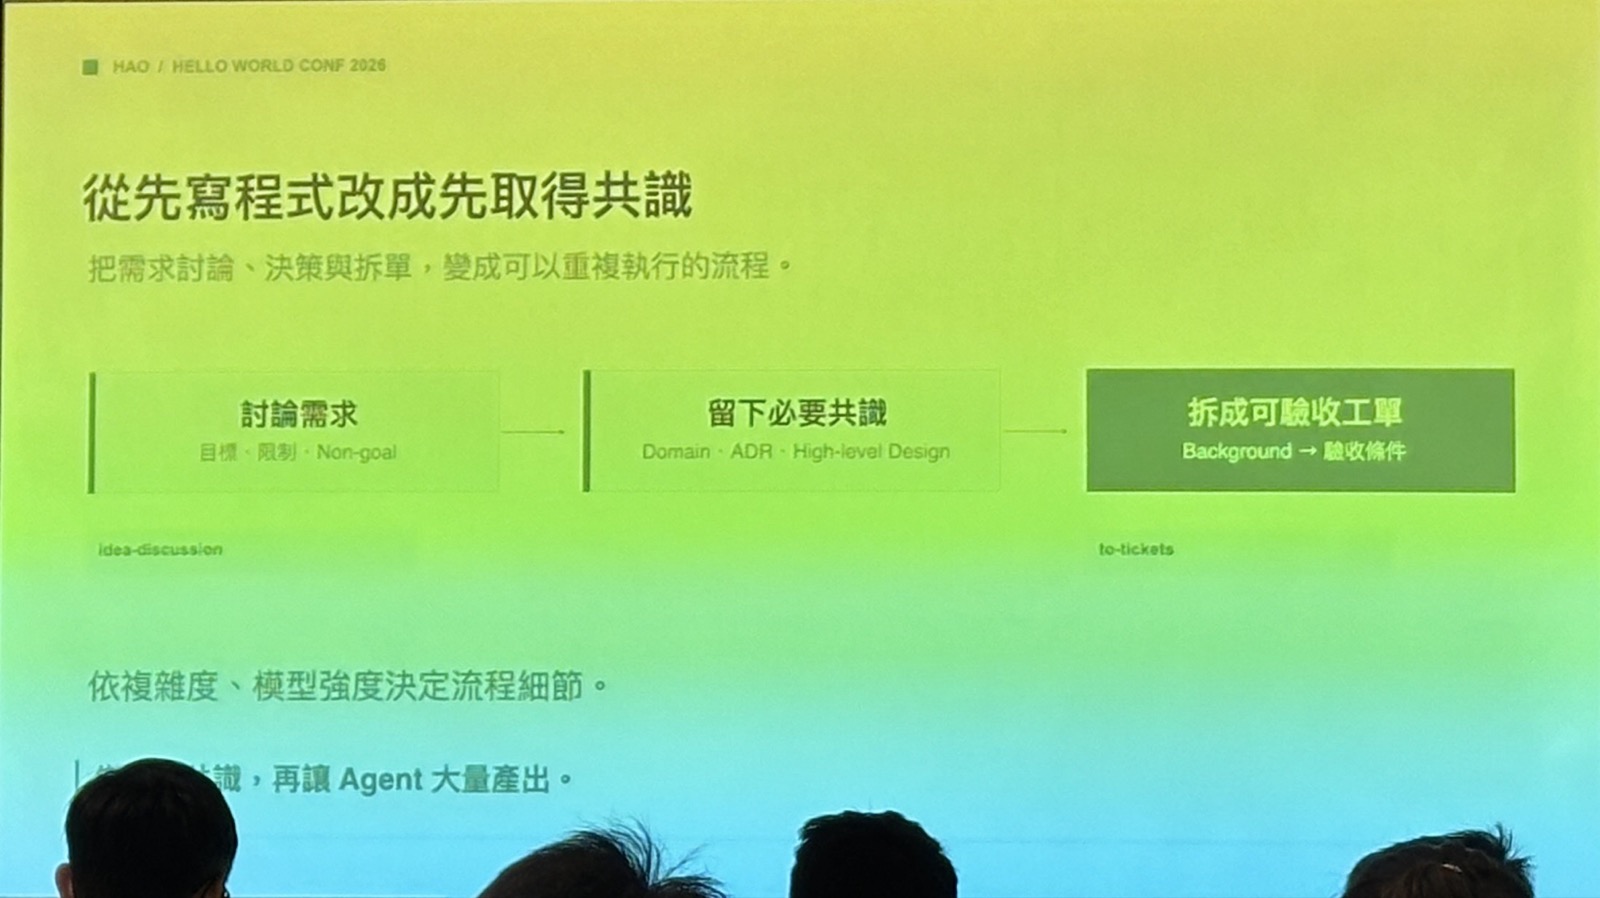
流程不必每次完整套用,應依需求複雜度與可用模型的能力調整。例如,將前端按鈕由藍色改為黃色,目的已十分明確,跑完整流程反而增加不必要的步驟與 token 消耗;但仍應先確認共識,再讓 AI 動手。
「我們在做事情之前,應該要先跟AI取得共識,我們再叫它動手做。」
— 豪
- Totifics:透過 brainstorming 與 AI 討論並取得共識,再用 writing plans 將結果寫成 Implementation Plan。
- Matt Pocock:先以 grill-with-docs 討論共識,再透過 to-spec、to-tickets 推進需求與拆單。
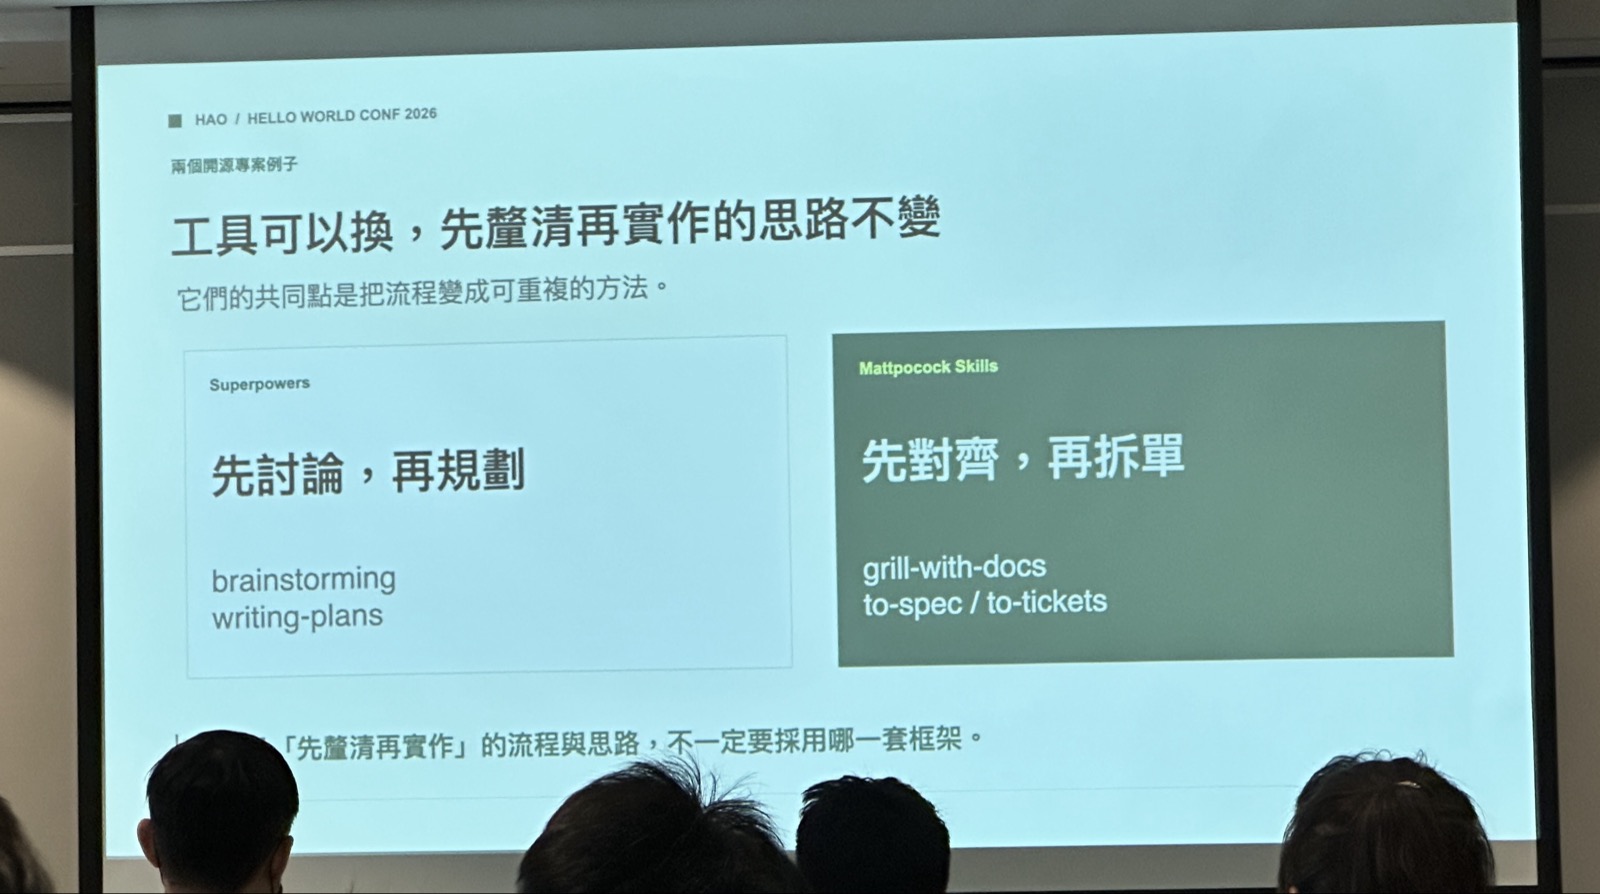
Skill 可以自行打造、採用開源版本,或依工作習慣重新組合。流程與工具名稱可以改變,不變的是先釐清共識,再形成可執行且能驗證的工作,而非把需求直接交給 AI 猜測。
專案知識與驗收條件的文件化
需求討論中的 domain language 與 context 應留在專案內,作為人與 AI 共同維護的知識。若每次對話都以不同方式描述同一術語,AI 可能產生不同理解;將用語明確記錄,並讓工單文件與程式命名一致,才能降低理解偏差。
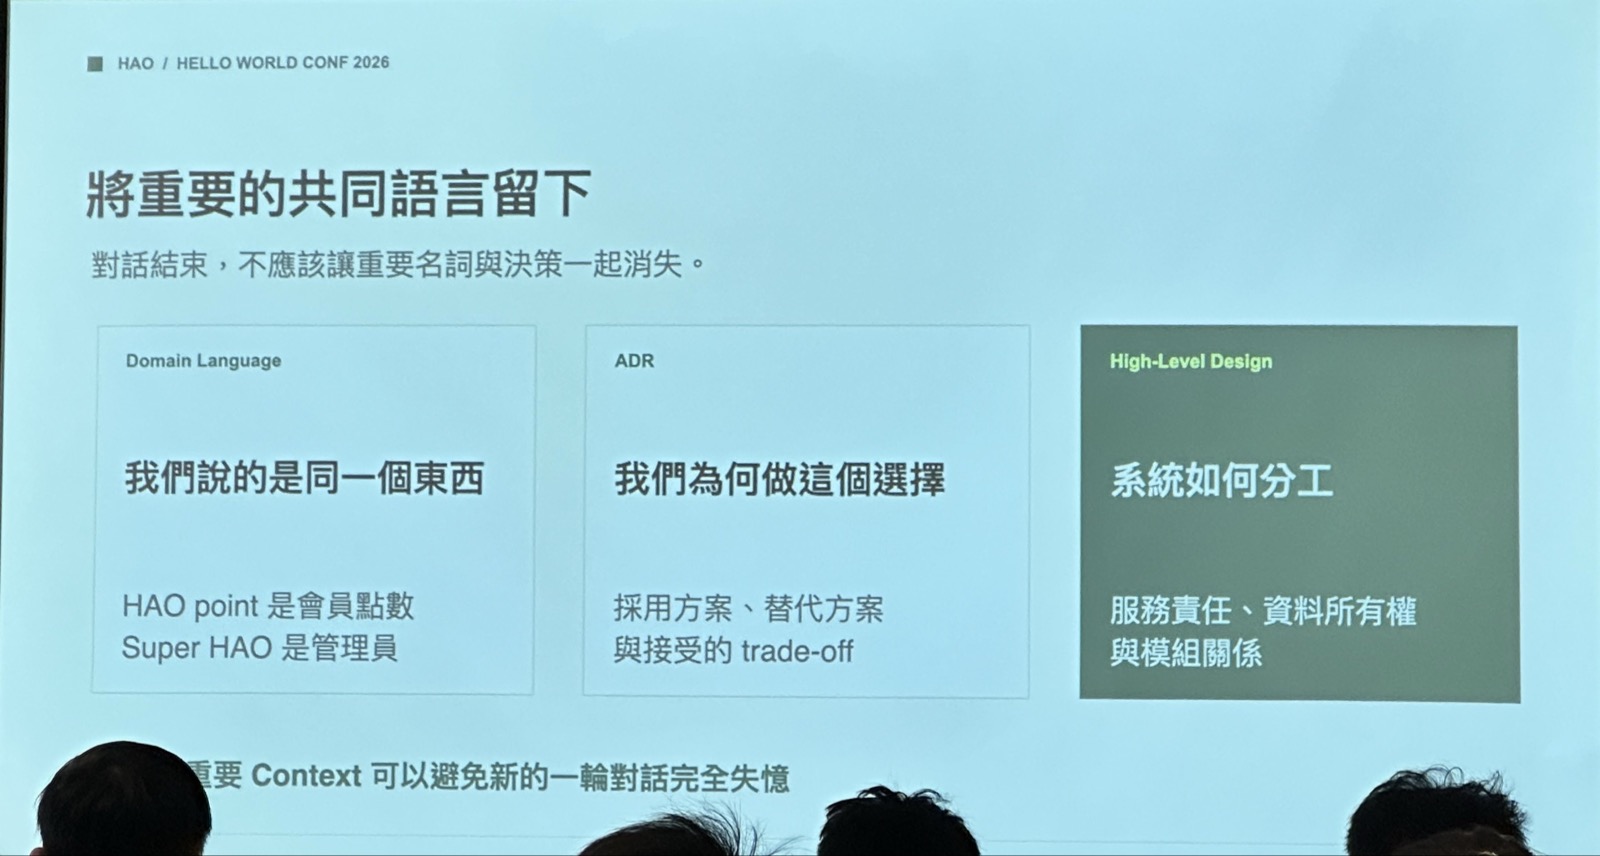
- domain language:記錄專案特有術語及其定義,讓 AI 不必依賴每次對話中的臨時描述。
- ADR:保留重要取捨,說明當時為何做出決定,以及後續應避免的事項。
- high level design:呈現系統的大架構與運作方式,協助人與 AI 快速理解系統,也讓維護者能回看設計脈絡。
工單也需要承載完整的背景與邊界,而不只是把討論結果拆成多張單。講者使用的模板包含四項資訊,讓 AI 在實作時能讀到變動原因、明確目標、不應處理的範圍,以及可驗收的預期行為。
- Background:說明為什麼需要這次變動。
- Goal:列出需要完成的明確事項。
- Non Goal:記錄討論中已確認不要做的事情,避免 AI 額外擴張實作範圍。
- 驗收條件:以 Given When Then 描述預期行為,讓人與 AI 先取得共識,並提供後續測試的依據。
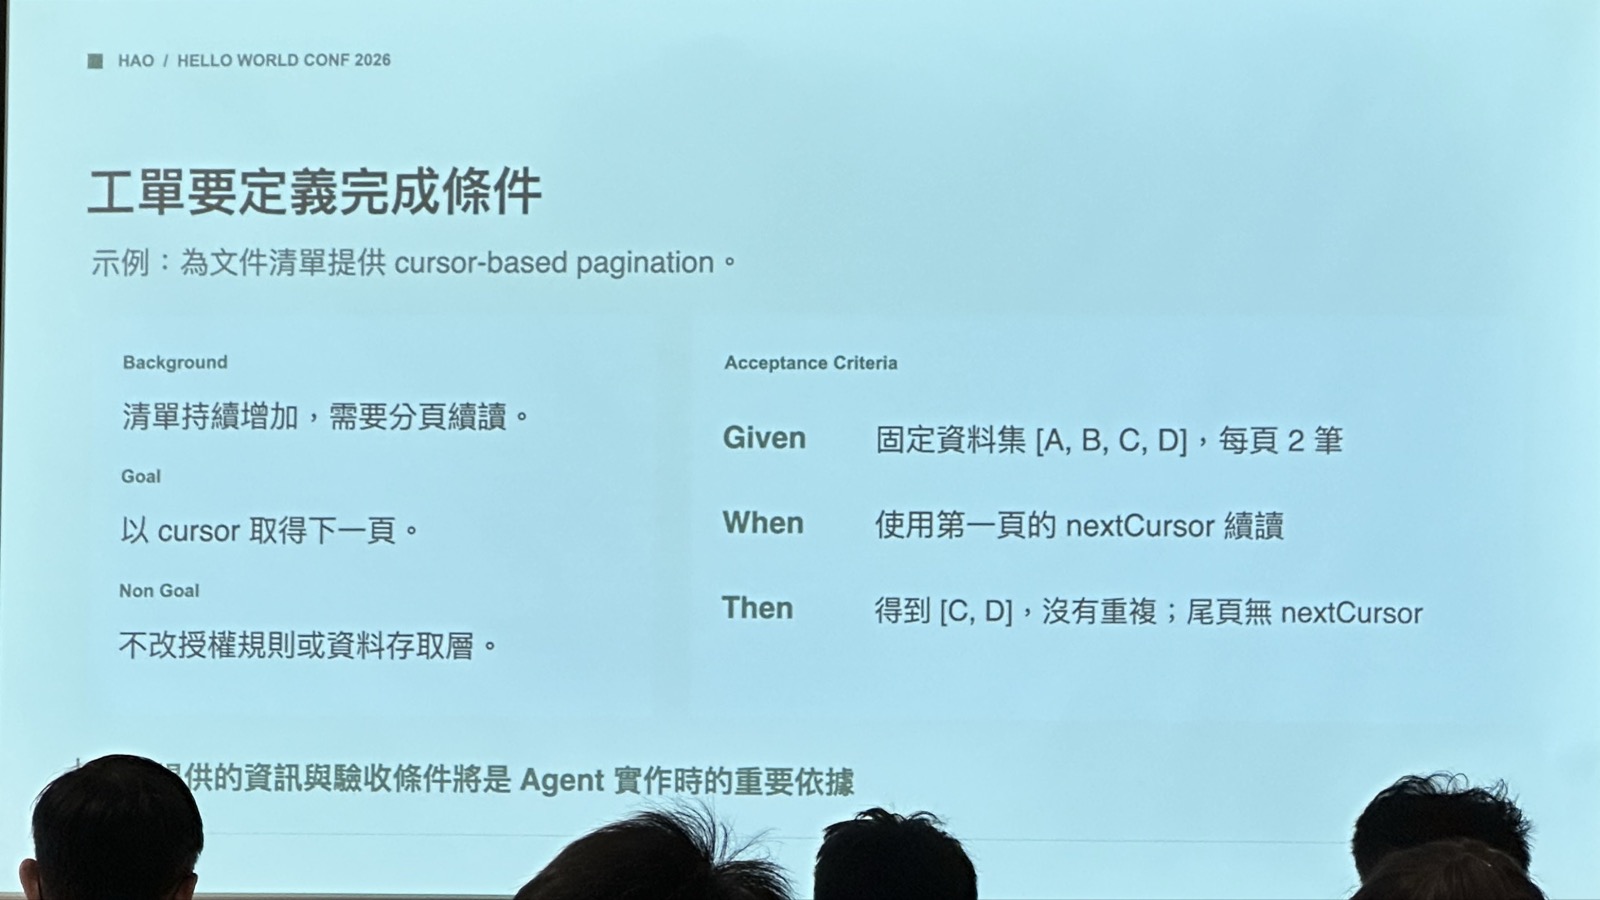
這套工單格式可納入 Totifics 這類 Skill,讓拆單時每張工單都保留關鍵資訊、工作邊界與驗收條件。重點不是增加工單數量,而是讓討論共識轉成實作時可讀取、完成後可驗證的內容。
精簡 policy 與既有技術債重構
工單定義要做什麼,policy 則補充專案內必須遵守的工程規則。講者將重要規則寫進專案,讓 AI 能讀取共用層的使用要求、模組依賴方向,以及不同職責檔案的配置位置。
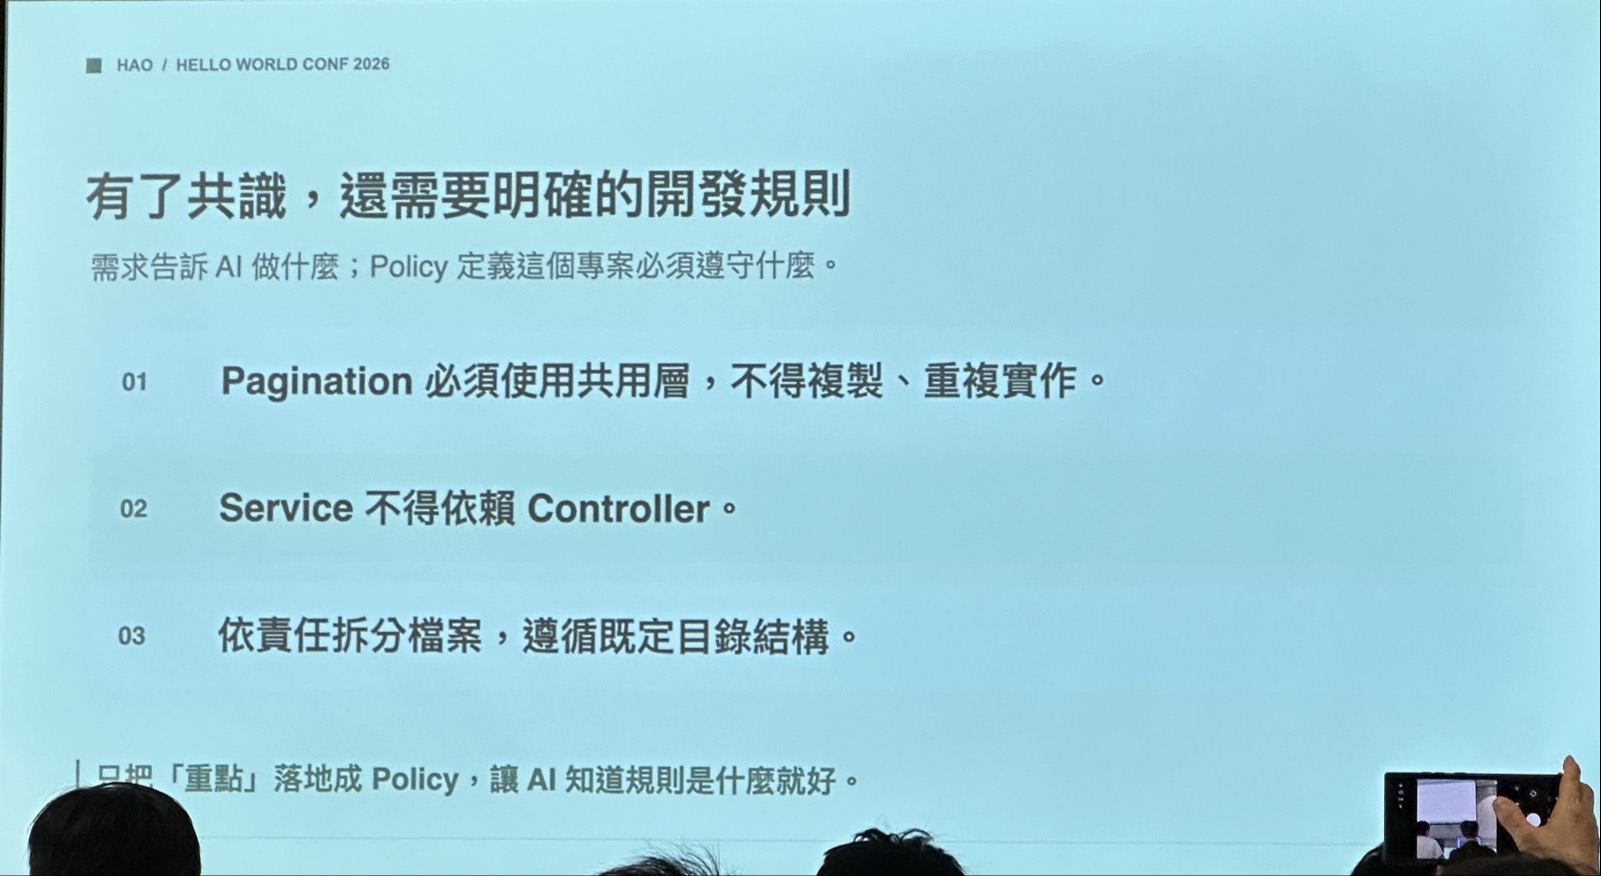
policy 應聚焦專案特有且重要的限制,而非蒐集所有開發知識。以 React 為例,講者認為模型已具備相關知識,只需提醒遵守 React best practice,不必逐條重寫。過度龐大的規則文件會在對話中反覆帶入,增加 token 負擔。
對既有技術債,應先完成合理重構,再留下後續可遵守的條件。Pagination 案例採取兩個步驟,先建立可用的共用層,再以 policy 防止重複實作。
- 先請 AI 整理可共用的部分,抽成共用層,並讓每個 API 改用該共用層。
- 共用層建立後,再寫下新的 Pagination 必須使用共用層、不得重複造輪子的規則,將重構經驗轉為後續工作的限制。
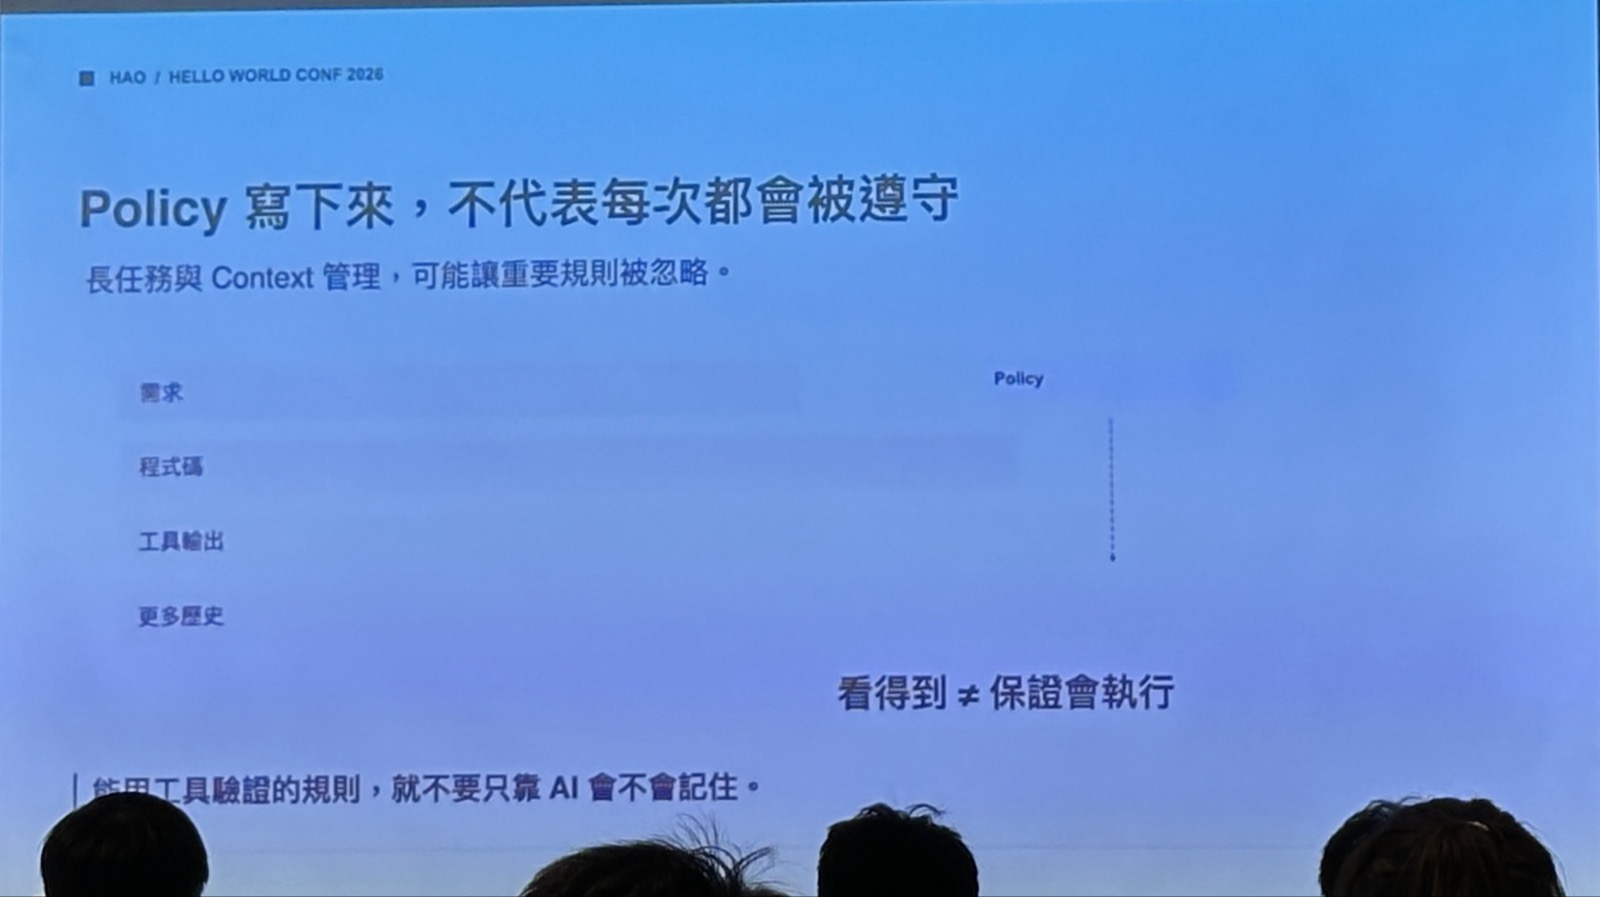
寫下 policy 並不代表 AI 一定遵守。講者觀察到,任務變複雜、context 拉長並經過多輪上下文壓縮後,AI 可能忘記使用共用層的要求,再次自行實作。文字規則無法保證完全符合預期,仍須補上驗證,透過可檢查的規則降低偏移可能性。
工具檢查與可修正的品質回饋
模組依賴等明確規則,應交由程式穩定檢查,不必全部依賴 AI 判斷。透過工具分析依賴關係、辨識不合法引用,比單純提醒 AI 記住分層規則,更能有效約束開發行為。
- TypeScript 專案可使用 ESLint 約束 coding style。
- Monorepo 工具 NX 提供模組邊界檢查機制,可用於防範違反依賴規則的變更。
- 講者也因自身需求打造模組依賴分析工具,讓 AI 開發時能取得穩定的違規回報。
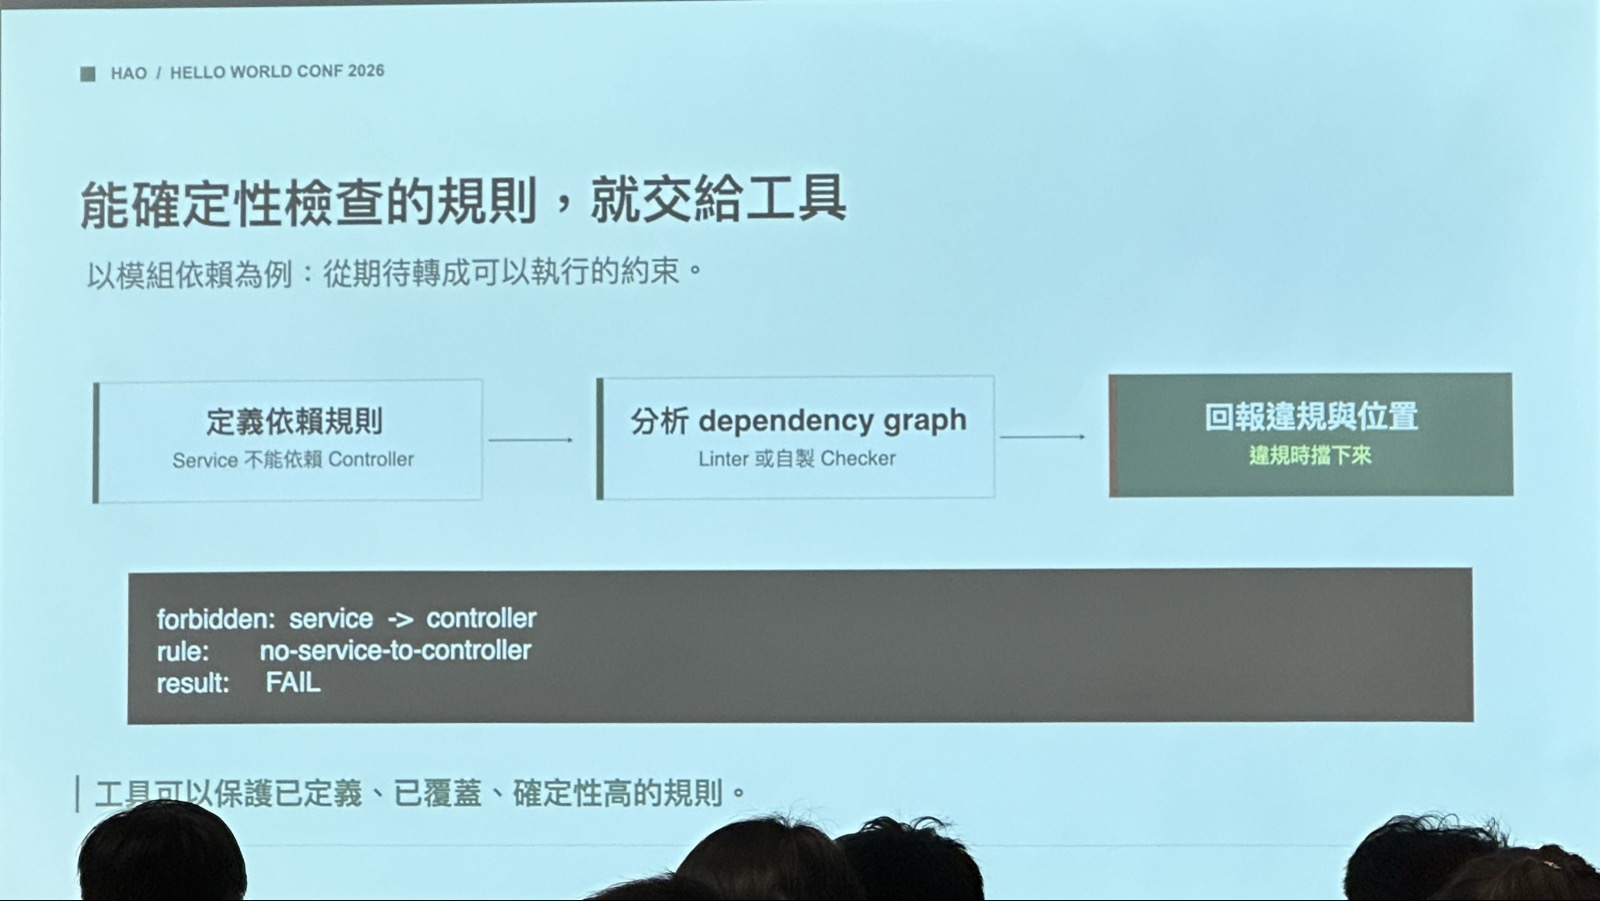
工具必須納入工作流,不能只期待 AI 自行執行。講者以 Git Hook 在 commit 時觸發依賴檢查;若發現 Service import Controller 裡的內容,就會攔截該次 commit,讓違規在提交時被發現。
攔截之外,錯誤訊息也必須提供具體原因與修正線索。若只回報 error 或 fail,AI 就得猜測問題所在,增加無效嘗試與 token 消耗。良好的品質回饋應讓 AI 知道哪裡違規,以及如何著手修正,而不只是告知檢查失敗。
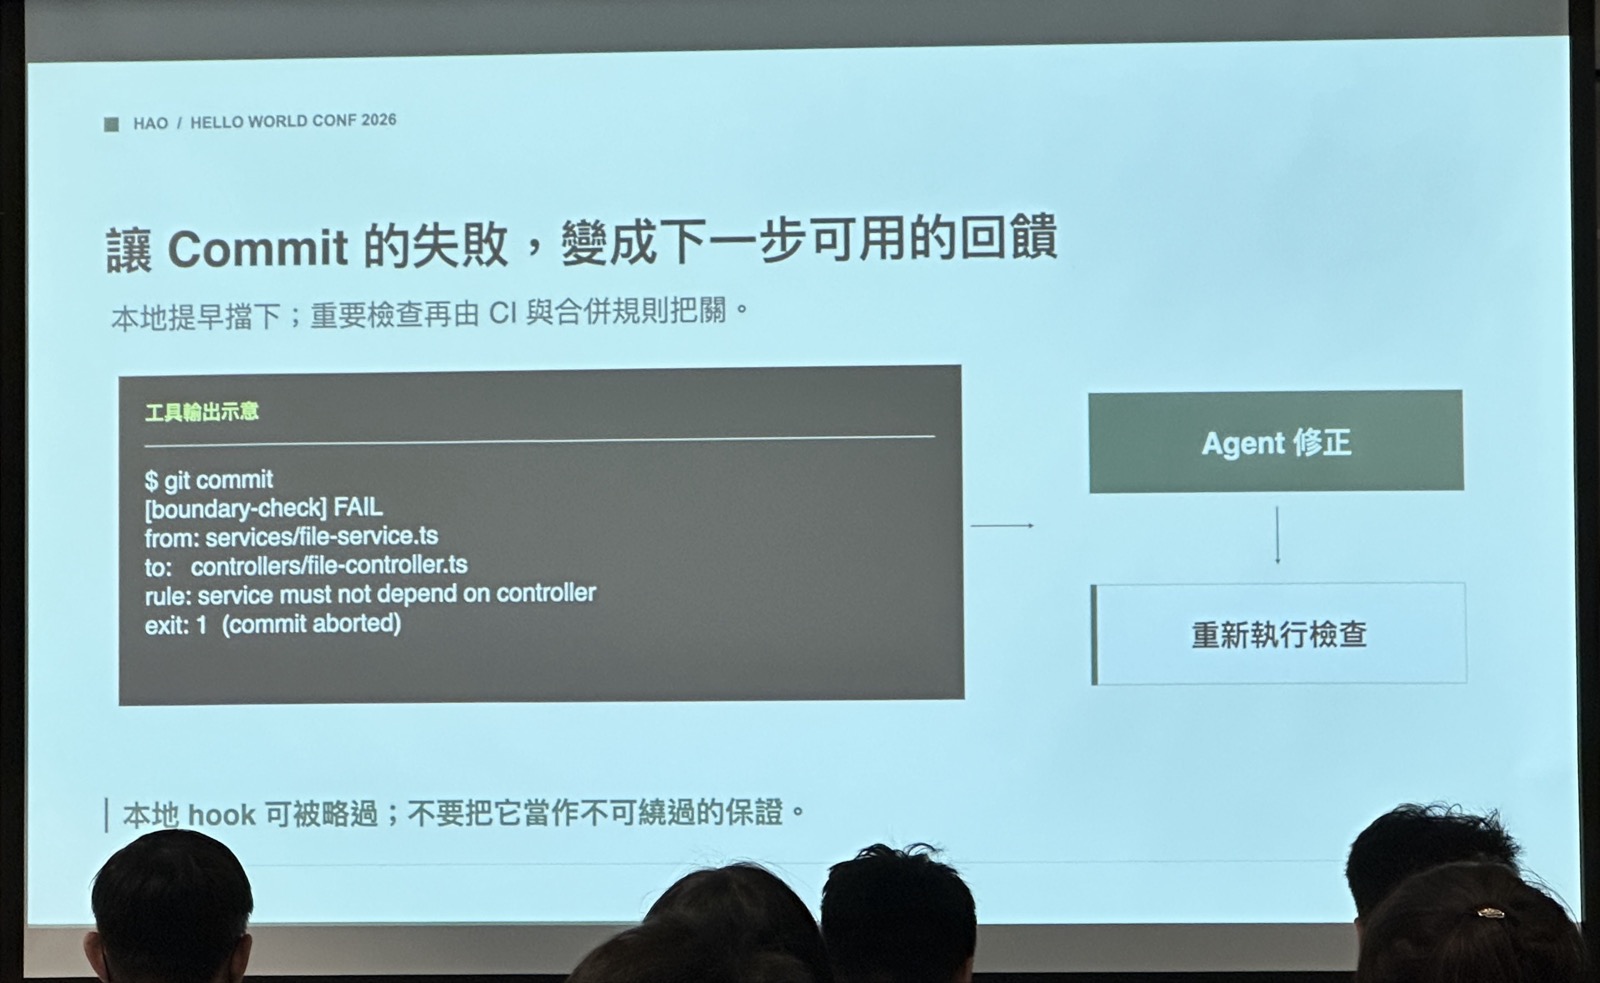
Git Hook 在本地端執行,不能作為唯一的品質防線。所有重要檢查仍須在 CI 再跑一次,補上工作流中的驗證。
review agent 的分工與人工責任
是否值得抽出共用邏輯,需要工程判斷,不能只靠工具檢查。以 Pagination 為例,重點不只是辨識重複程式碼,還要判斷當下抽共用是否有價值。豪因此將 review 方法寫成 Skill,交由獨立的 review agent 執行,以乾淨的 context window 專注檢查,降低實作過程中多次上下文壓縮、遺忘規則的影響。
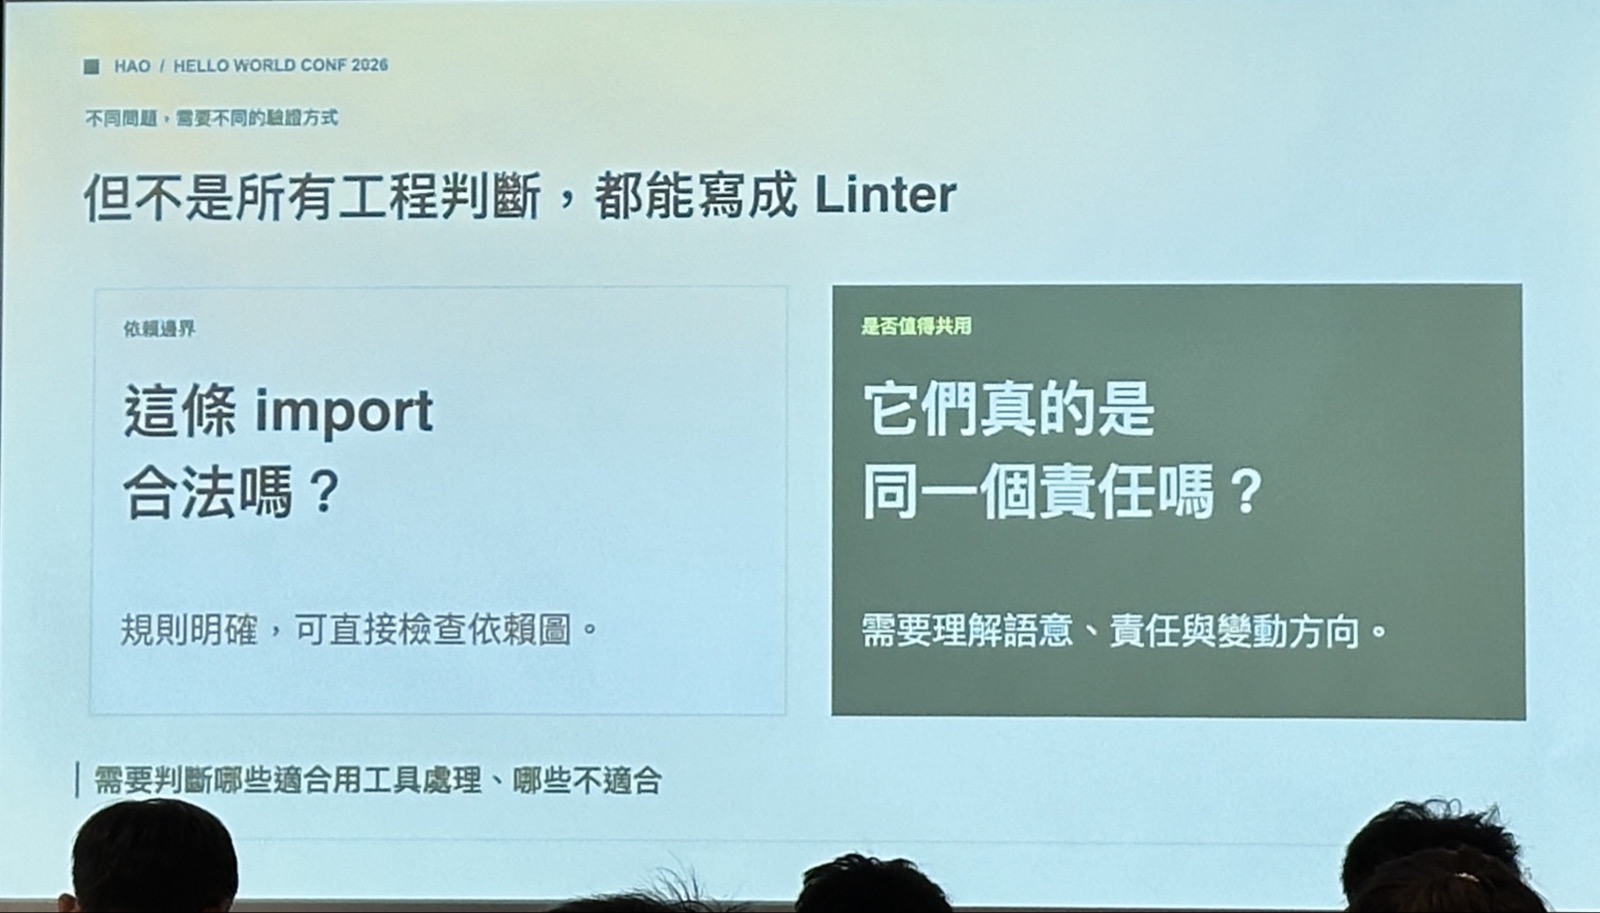
- 檢查依據:review agent 讀取專案 policy 與相關程式,依 Code Review Skill 檢查違規並提出建議。
- 檢查案例:新增 Pagination API 若再次重複實作,reviewer 可回報其違反 policy,並提供改善建議。
- 職責邊界:reviewer 採唯讀設計,只負責檢查與回報,不自行修改程式。
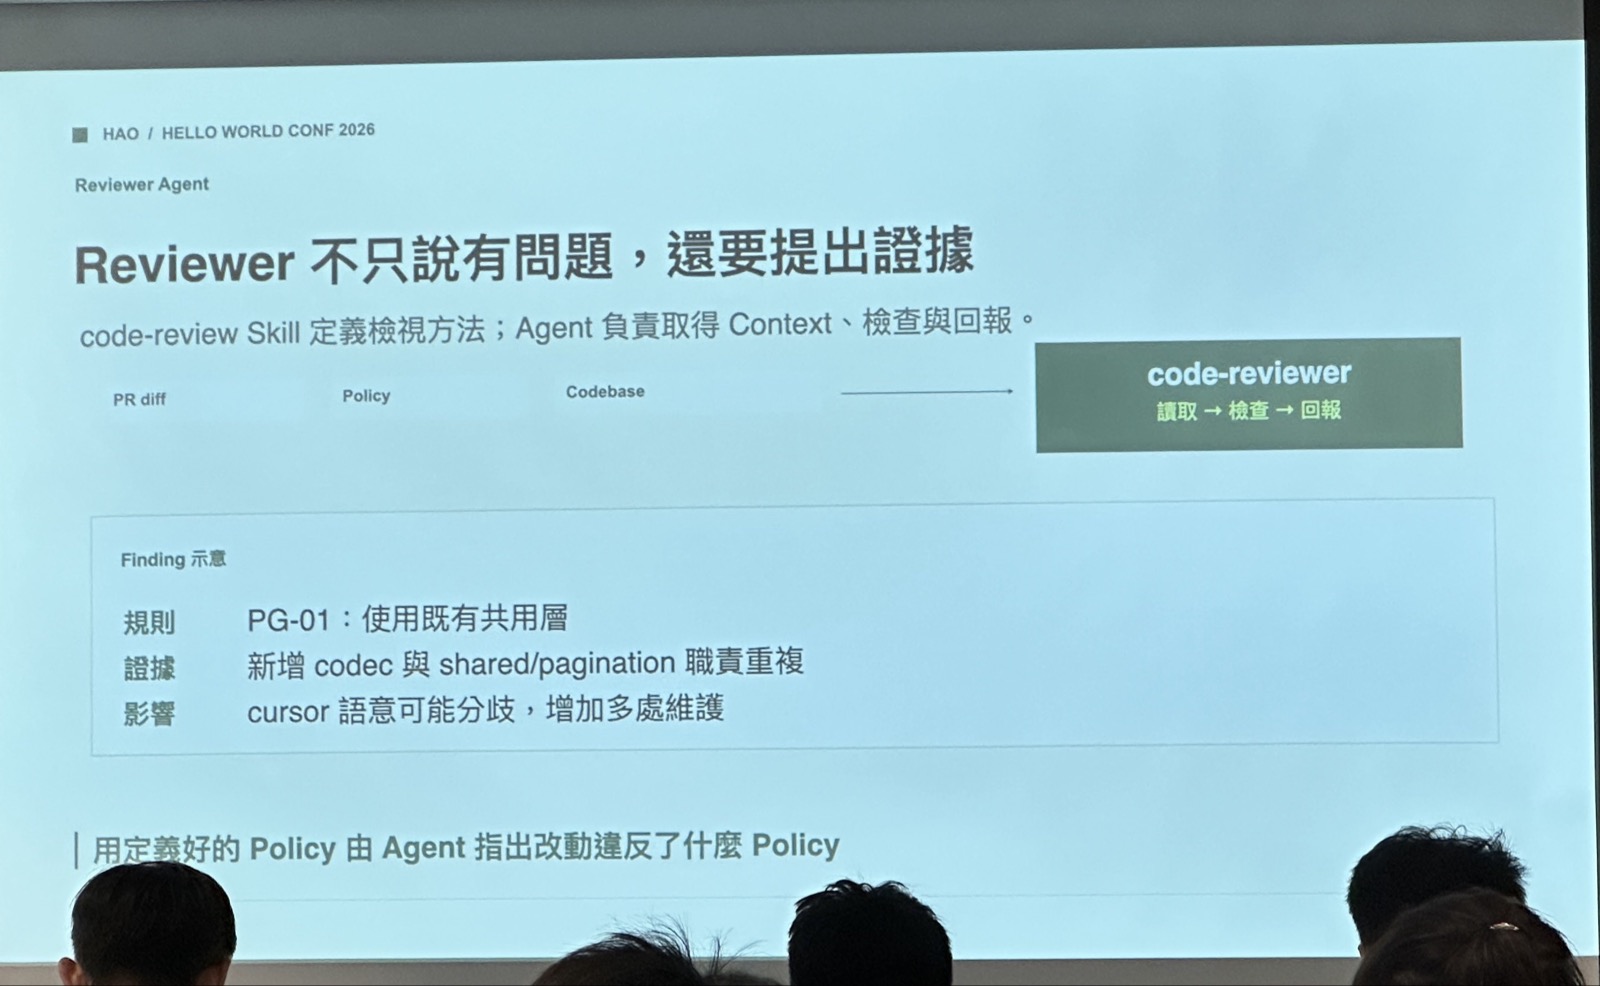
獨立 AI review 並非百分之百的品質保證。review agent 仍可能漏判,也可能與實作 agent 具有相似盲點。其作用是協助找出 policy 定義的技術問題、檢查交付條件是否達成,讓人將注意力集中在需求合理性、商業邏輯、架構取捨與風險決策。
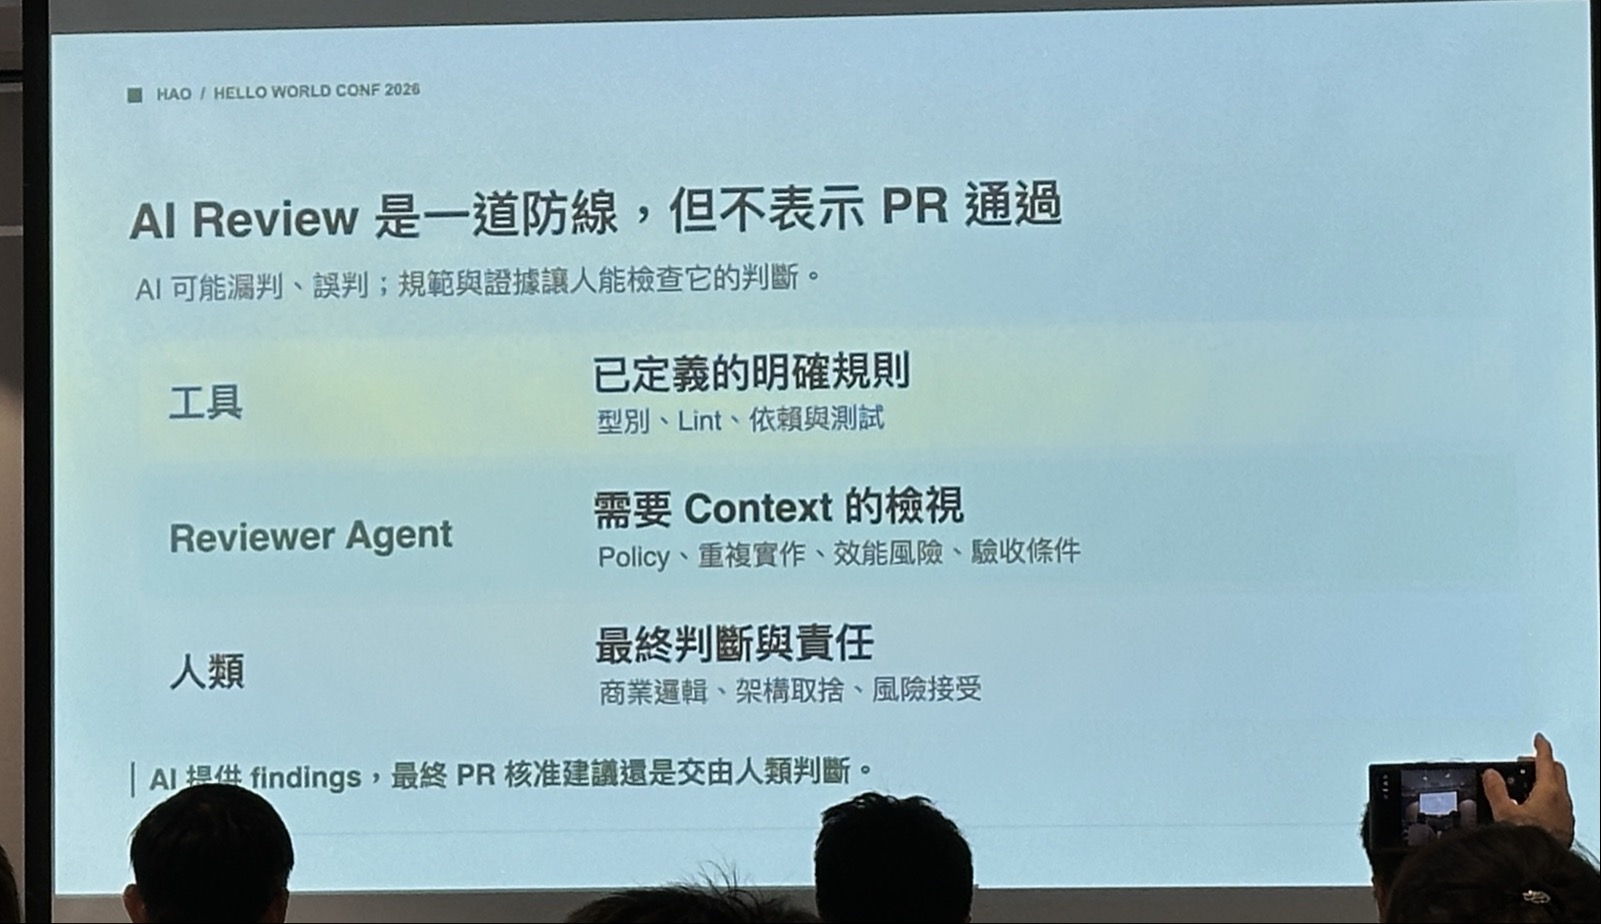
「那這個agent呢,他就只是我們review的合作夥伴」
— 豪
最終審查決策仍由人負責,不應因 agent 回報 OK 就直接 approve。豪目前會先請 AI 協助審查,再親自查看測試與核心邏輯,並驗證最終結果;他也強調,這是目前採用、供參考的做法,而非唯一正確的審查方式。
以 TDD 保護行為而非鏡像實作
TDD 的重點是先鎖定預期行為,而不是等程式碼完成後才檢查。工單中的驗收條件可作為測試案例的依據:先整理測試情境、預期結果與必要邊界,再透過測試約束 AI 的實作結果。
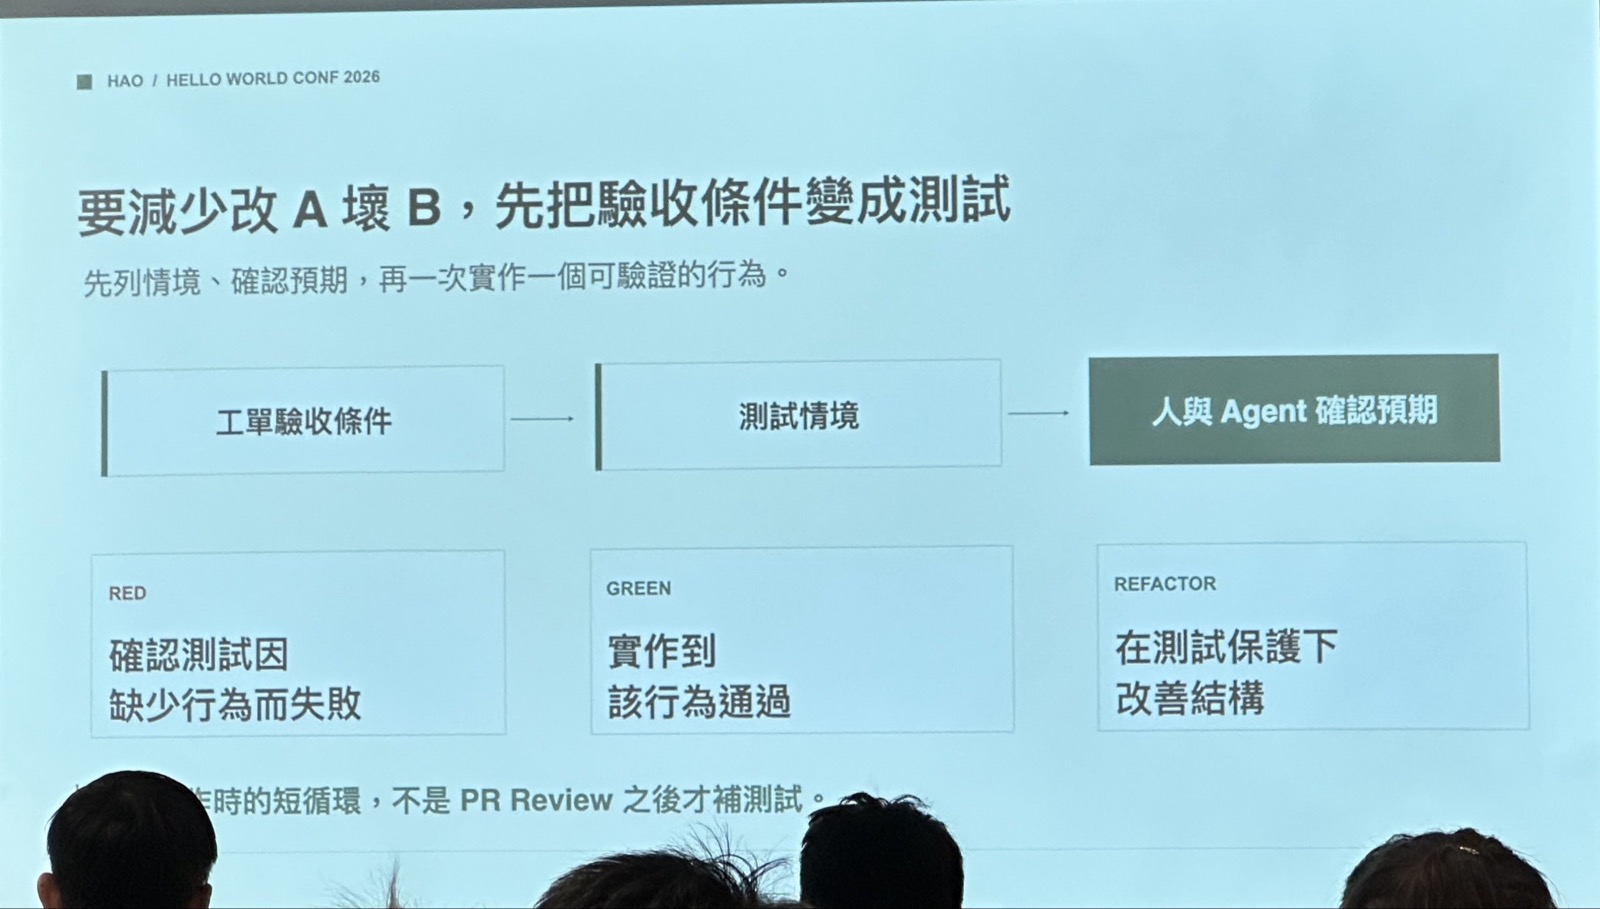
講者的實務經驗顯示,測試能擋下許多「改 A 壞 B」的情況,但 AI 產出的測試是否合格,仍須另外審查。測試應保護需求所描述的行為,而非只確認程式碼目前的寫法。
- 跨頁資料:檢查第二頁是否出現與第一頁重複的資料。
- 最後一頁:確認 Cursor 的有無符合預期。
- 重構相容性:確認重構不會破壞既有 API 的行為。
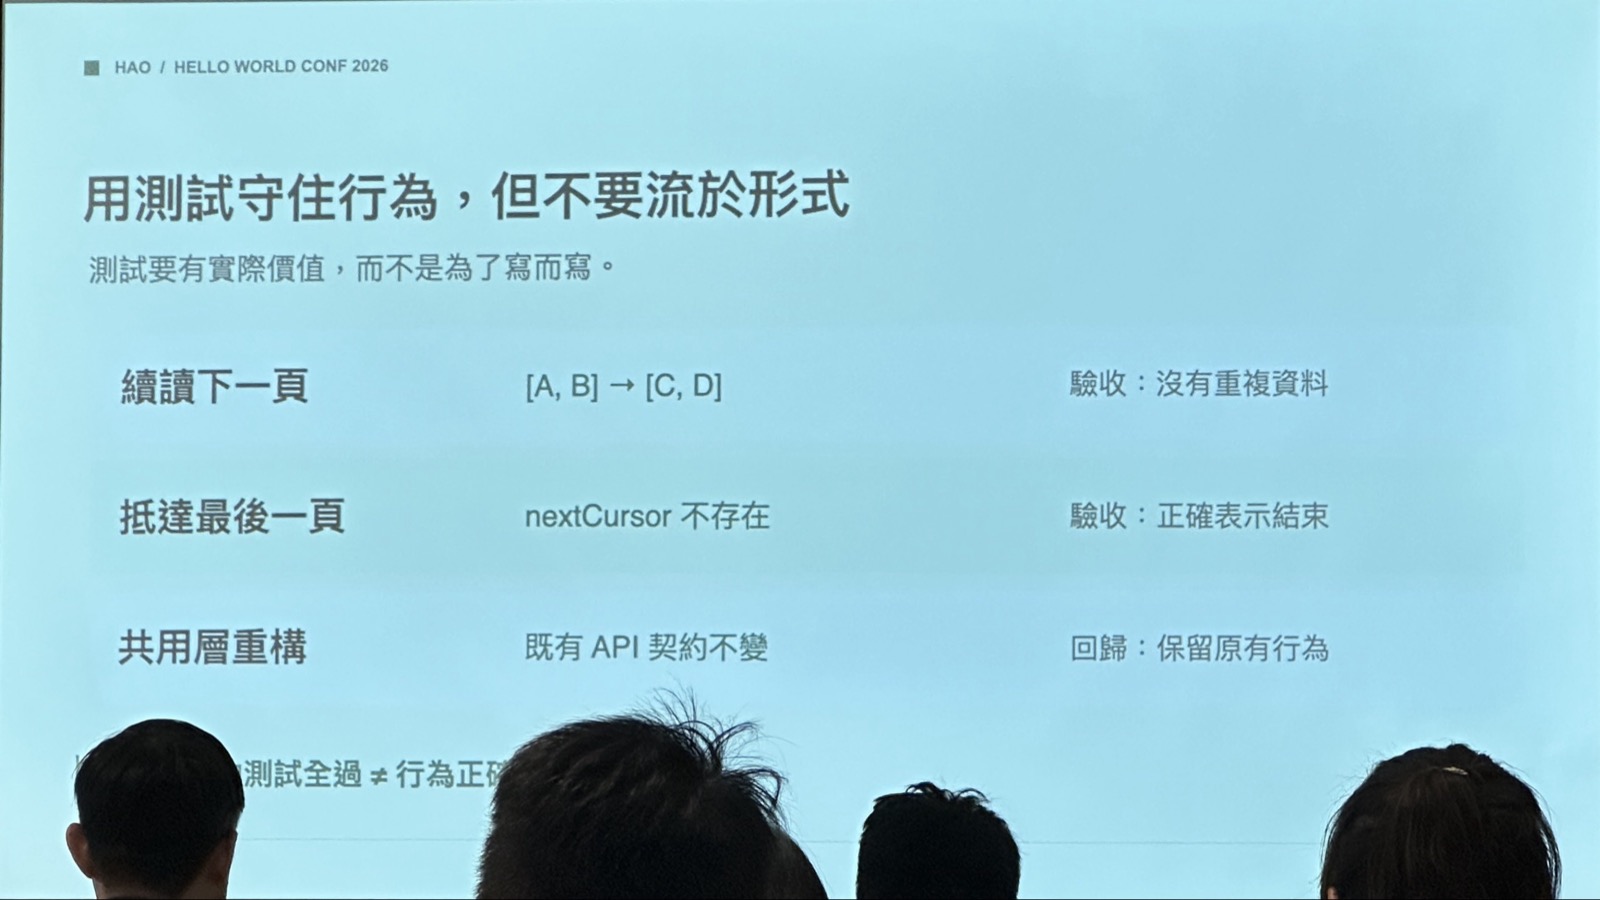
例如,只檢查模組中的某個常數是否等於 300,屬於「鏡像實作」的測試,與實作高度耦合,容易變成為了寫測試而寫測試。即使這類測試全部通過,也無法保證行為正確;審查時應確認案例是否真正對應驗收條件與預期行為,而非只看通過結果。
atomic implementation loop 與 context 控制
atomic implementation loop 將工單、專案 context、policy、測試、工具檢查與人工審查串成開發循環:AI 在明確條件下實作,以測試保護既有行為、以工具檢查明確規則,再由 agent 與人共同審查;遇到失敗,就回到適當步驟修正與驗證。這些機制並非 AI 時代才出現,關鍵是讓既有工程紀律成為 AI 能遵守、也能取得回饋的工作環境。
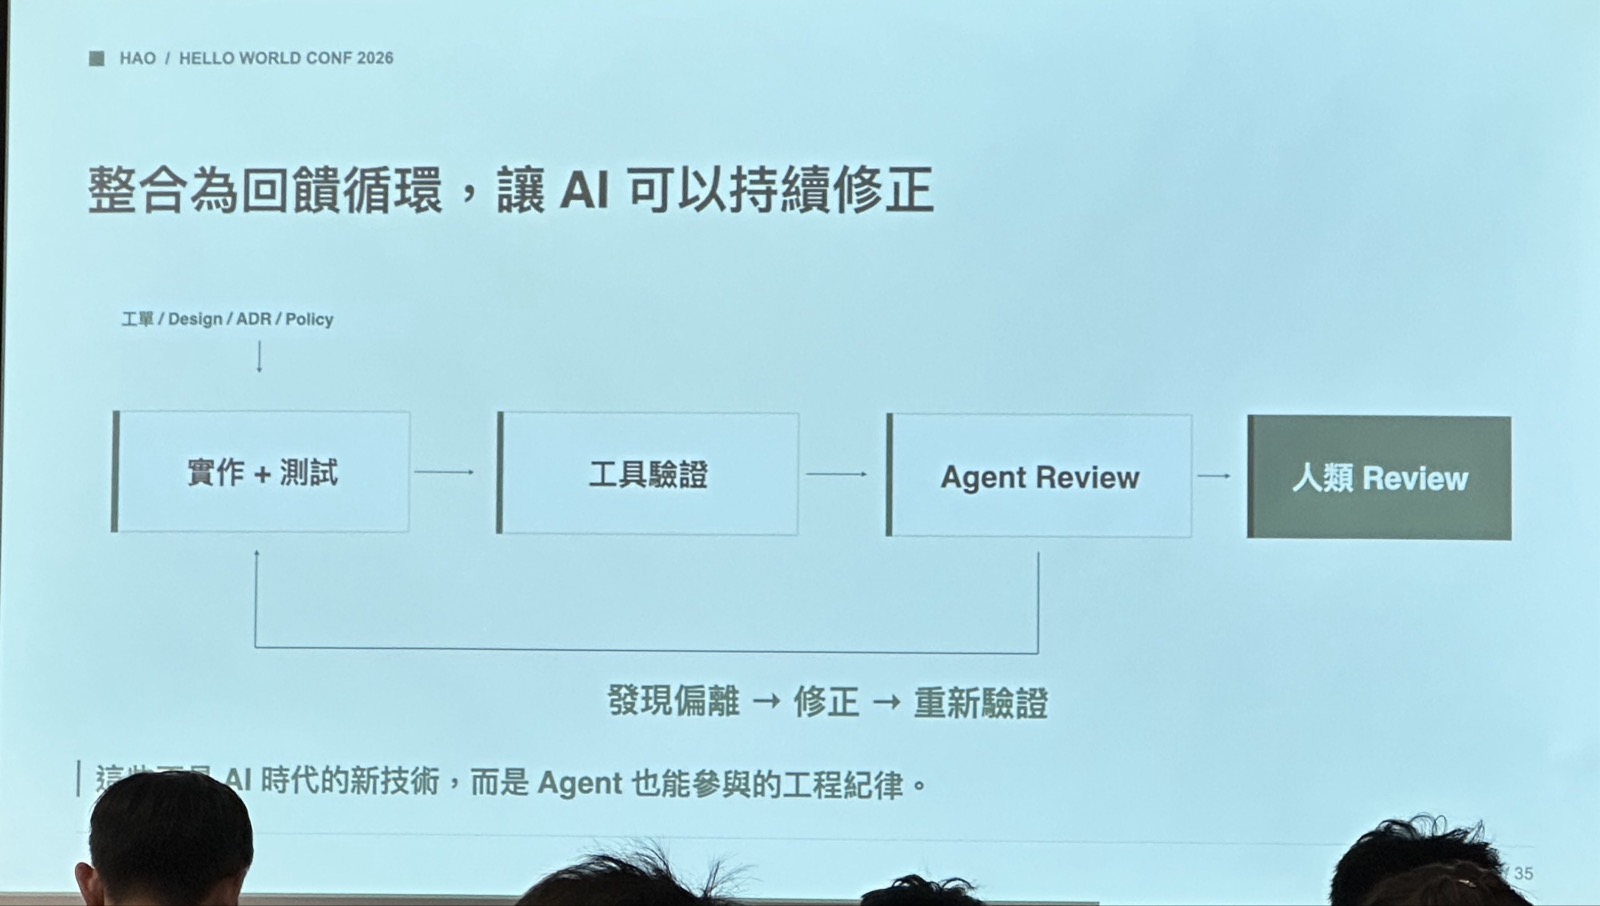
取得需求共識並備妥工單、驗收條件及專案 context 後,主 agent 只負責一個明確目標,並以 atomic commit 的思維規劃 incremental。實作、驗證與提交逐步推進,而不是完成所有改動後才一次提交。
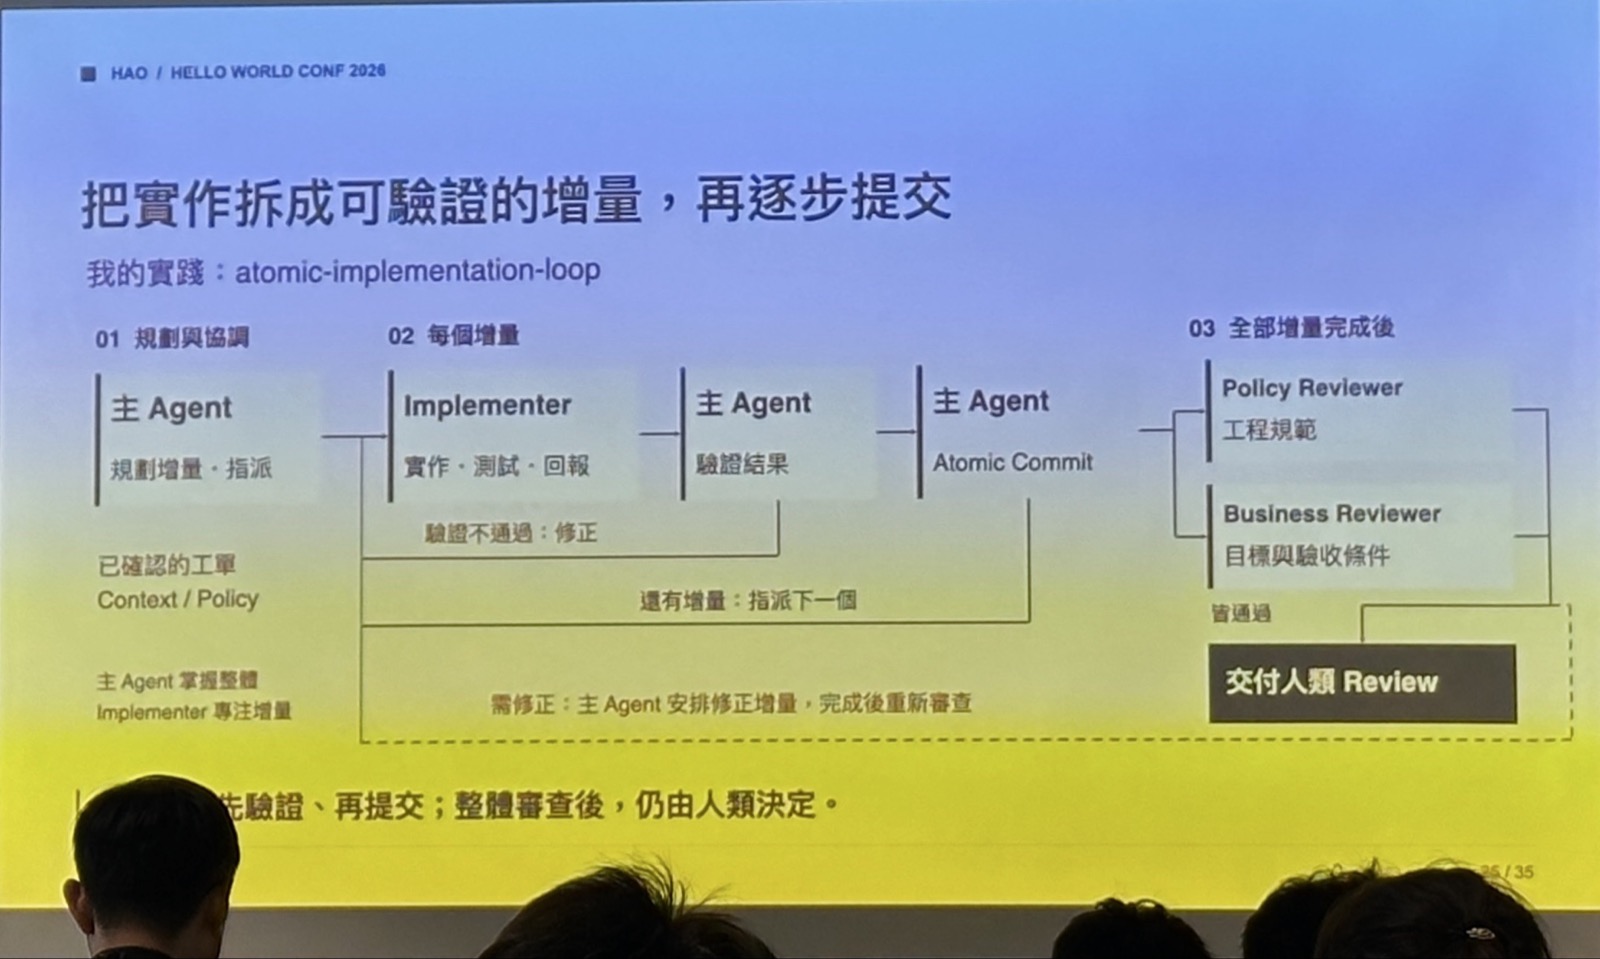
- 分派實作:主 agent 將 incremental 交給 subagent;每個 subagent 一次只專注一個 incremental,執行實作與測試,再回報變更及結果。
- 驗證後提交:主 agent 確認結果是否符合預期;未通過就請 subagent 修正,通過才做一次 atomic commit,再推進下一個 incremental。
- 雙軌審查:所有 incremental 完成後,policy reviewer 檢查改動是否違反專案 policy,business reviewer 則依原始工單的預期結果驗收。
- 修正再審:審查發現的問題轉成修正 incremental,經驗證及 commit 後重新 review;兩個 reviewer 都通過,才完成這次開發流程。
atomic commit 的目的,是讓每次提交都有清楚的變更目的,並在繼續前先確認當下結果。人也能透過 commit message 追查 AI 處理工作的脈絡,避免所有改動被包成單一 commit,增加審查難度。
循環也需要停止條件。講者舉例,可設定連續三輪 review 未通過就先停止並回報,而非無限制修正。依其使用觀察,這套流程能明顯提升品質,但也會消耗更多 token。
QA 關注主 agent 累積過多 context 後,compact 可能遺漏資訊的風險。講者的回應是從拆單控制工作量:取得共識後,每張工單的顆粒度應夠小,避免單一 scope 過大。他以每單可能消耗不超過 30 萬 token 作為個人的控制例子,而非通用上限;核心仍是縮小每次任務範圍,降低 context 膨脹與壓縮造成資訊流失的機會。
工作環境診斷與漸進補強
AI 出現不符預期的行為時,應先診斷工作環境的缺口,而不是只追加 Prompt,期待它猜對指令。講者提出 context、constraint、feedback 三個檢查角度,分別確認需求理解、規則約束與錯誤回饋是否到位。
- context:AI 是否取得需求,理解要做什麼、系統的大方向與必要名詞。
- constraint:AI 是否知道哪些規則必須遵守。
- feedback:AI 完成工作後,是否有機制能指出它做錯了什麼。
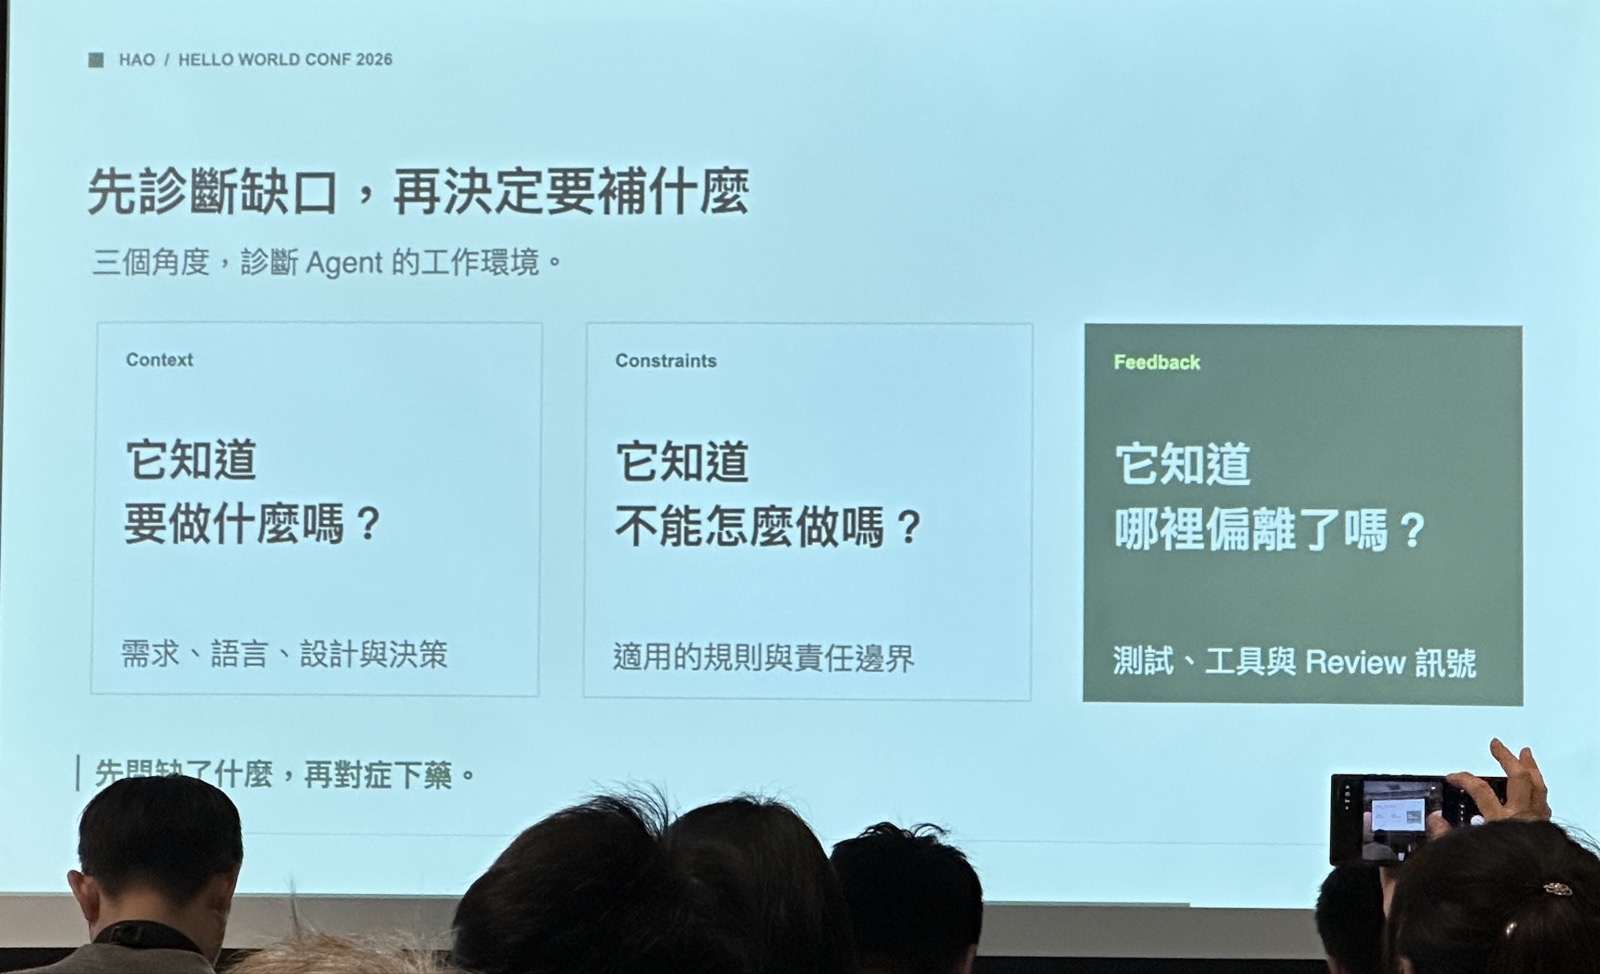
診斷後,再依缺口選擇最簡單、最適合的機制。policy、Skill、tool 與 agent 各有用途,也可以組合使用,不必把所有問題都交給單一機制處理。
- policy:放置必須遵守的規則,例如要求使用共用層。
- Skill:保存可重複使用的方法,讓 AI 依循既有流程工作。
- tool:處理確定性的檢查或執行,例如檢查模組相依關係。
- agent:承擔有明確邊界的職責,例如 Code Review。
以模組邊界為例,可以同時建立 policy 與檢查工具,再透過 hook 整合進工作流程;Code Review 則可由 agent 執行,搭配 Skill 中的方法與流程,並以 Policy 作為判斷依據。重點是讓各機制互補,而非為了導入工具而增加流程。
建立 AI 工作流不必等到所有 Skill 與工具都準備齊全。講者建議先處理最痛的問題,再依三個診斷角度選擇補強方案,讓機制從真實需求中逐步長出來。
- 新專案:優先建立 Linter 與 Git Hooks,再補上 Policy。相較於可能被遺忘的文字規範,確定性檢查更能穩定約束可檢查的行為。
- 既有專案:先將現成的檢查機制整合進工作流;若尚未具備,就安排時間補建,再從最近一次具有代表性的問題逐步改善。
工程環境應持續累積有價值的 context、工程規則,以及驗證與回饋機制。透過人的判斷吸收每次問題帶來的教訓,再迭代補強,才能逐步提高對 AI 產出程式碼的信心。
共享能力與專案特有規則的邊界
講者目前已在個人與一人專案中實踐這套流程,觀察到交付速度提升,也兼顧軟體品質。將流程導入團隊、驗證整體交付效率與品質效益,仍是後續希望驗證的目標,尚不能視為已確認的團隊成果。
共享的重點是抽出可重用的規則與能力,而不是集中所有 Policy,再要求所有團隊一律採納。是否共享,應區分跨專案適用的工程紀律,以及只服務特定專案的局部需求。
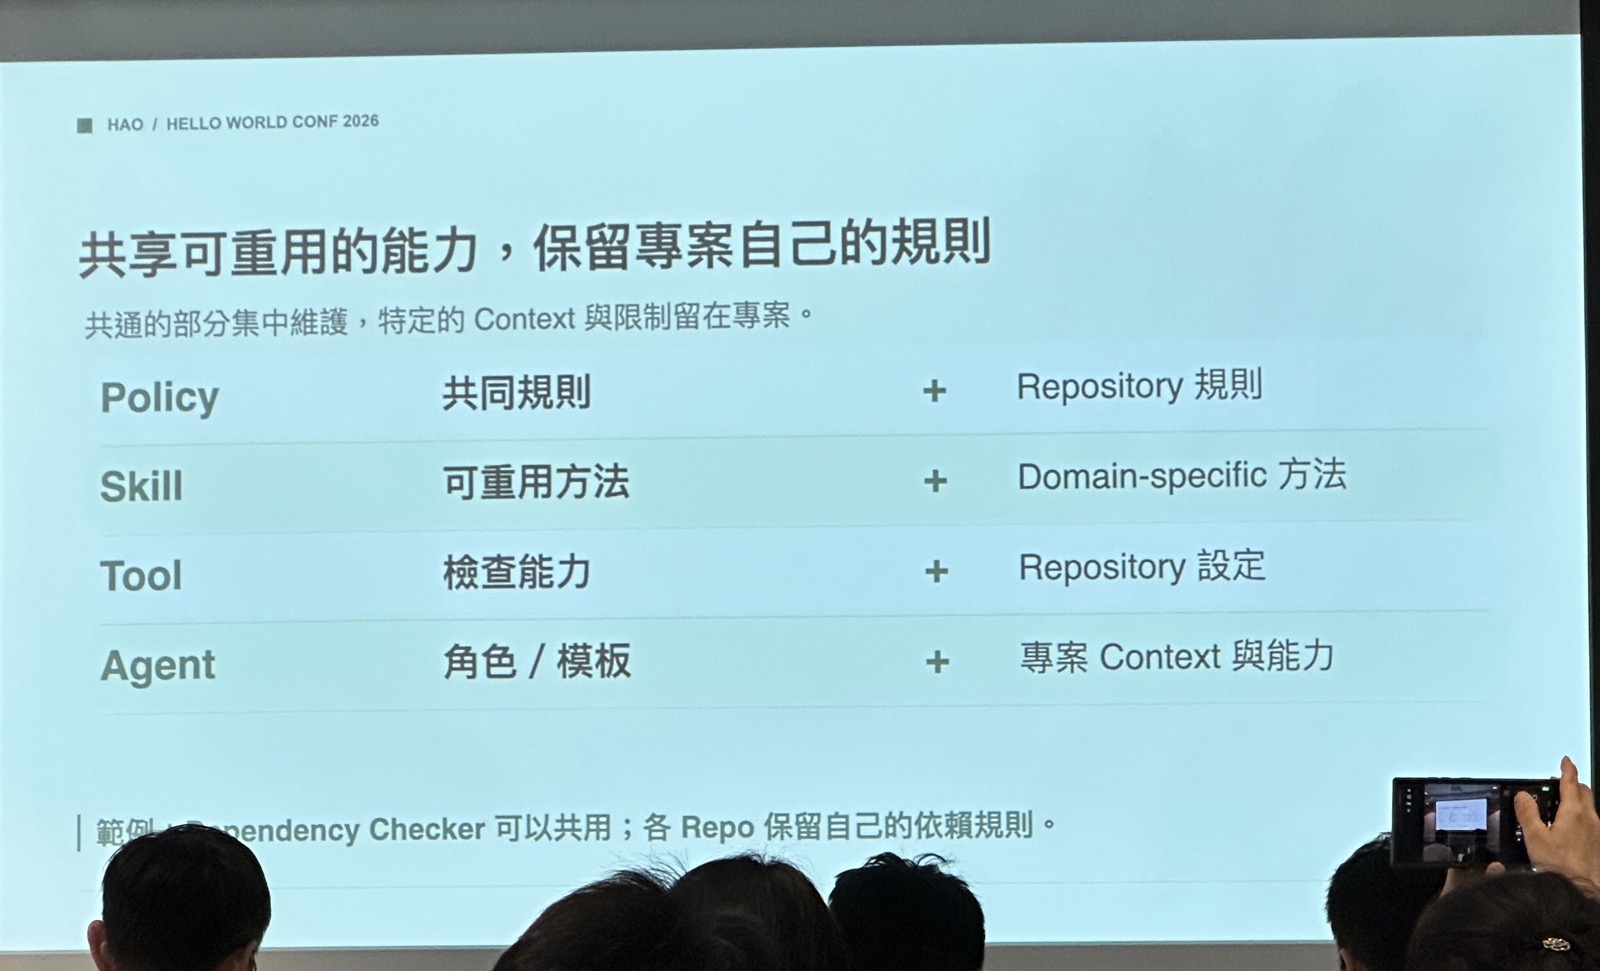
- Policy:發 PR 前必須通過測試與 Lint,適合成為共享規則;檔案配置等會隨團隊或專案改變的要求,保留在原專案即可。
- Skill:可重用的工作循環可供其他團隊使用;若用途是在特定前端專案的資料夾結構下產生特定內容,則不必提升為全團隊共用能力。
- Agent:Code Review Agent 適合評估為團隊共享的 Agent,讓其他專案採用相同的審查機制。
- 工具:檢查依賴關係的工具具有重用價值,可供其他團隊或專案使用。
共享範圍與採用強度仍須依公司性質及專案情境判斷。先評估機制是否具有跨專案價值,再決定分享給哪些團隊,以及是否需要強制或部分強制採用,不應將所有局部需求一律升級為共同標準。
資產分發、共同維護與組織共識
共享資產需要可落地的分發方式,也需要明確的治理責任。工具可透過 Package 提供;Skill 則可使用 Vercel Skills CLI,從共同維護的 Skill Library 選取並安裝至特定專案,安裝後的內容也能納入版控。
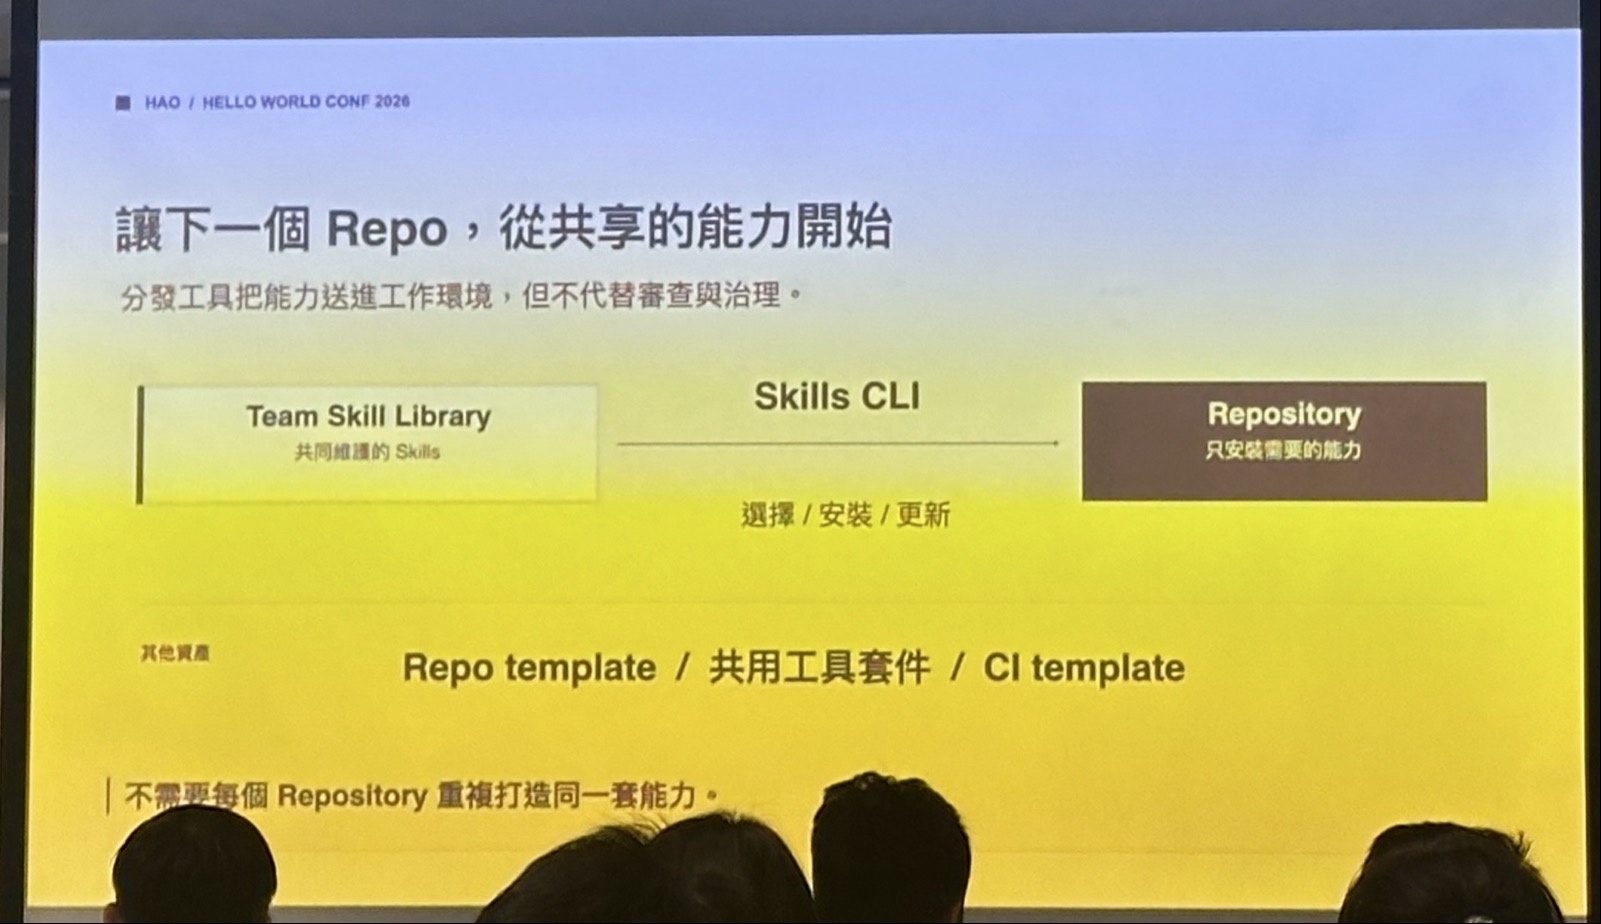
Agent、Policy 等資產也可透過適合的工具或團隊自建 CLI 分發。重點不只是集中存放,而是讓各專案能實際取得並使用共享內容。不過,有了分發機制,不代表已具備治理;團隊仍須決定誰可以修改規則、改動是否經過 Review,以及由誰持續維護。
- 先在個別專案驗證做法能否解決問題、提升效率,再評估是否具有跨專案使用的價值。
- 共享資產須有人負責 Review 與維護;新加入的 Skill 或 Policy 不會自動成為所有專案的標準,也不代表每個人都必須採用相同的 AI 開發流程。
- 治理的目的是減少重複造輪子與重複踩坑,萃取真正有價值的做法,讓團隊直接使用已驗證的機制。
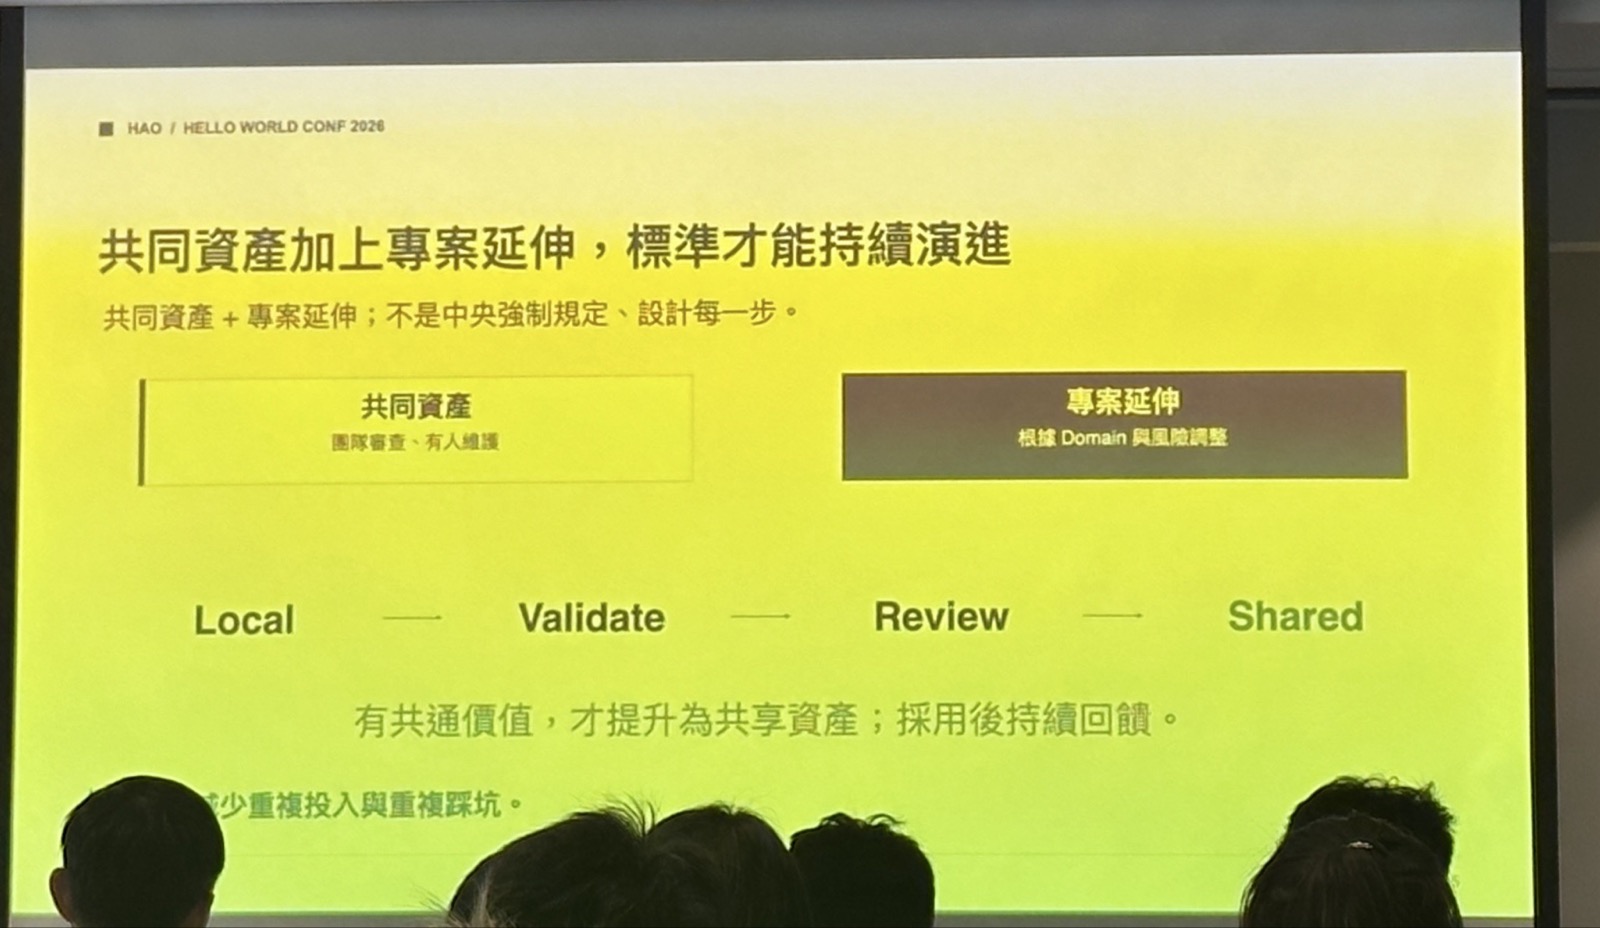
QA 中,與會者追問團隊是否真的出現多個 Skill 處理同一問題的情況,以及如何取得共識。講者確認確有重複,現階段正以共用 repo 推動共同維護,但導入仍在進行中,需要整個組織形成共識,不能只靠一人推動。
資產同步的範圍仍需與團隊討論,尤其應關注測試、核心 domain 與重要腳本的版控;一次性內容是否值得共享,也需另外評估,優先同步真正重要的內容。
整體結論是:軟體品質不能只靠更換 AI model,而要讓既有工程紀律可被 AI 讀取、遵守與驗證。從需求共識、設計、規則、測試到 Linter、Git Hooks 與 CI,先解決真實痛點,再把有效經驗沉澱為可審查、可維護的共享資產,才有機會從個人工作流走向團隊工程系統。
工程紀律domain languageADRpolicyTDDGit HooksCIatomic implementation loopcontextconstraintfeedback共享資產治理