AI在企業的應用與挑戰之路
會議重點
Edward Kuo 以企業AI策略管理者、架構師與開發者的實務經驗,說明AI落地的核心不在追逐模型或採購工具,而在找對業務問題、整理可信資料,並建立成本與風險治理。分享涵蓋自動化、AI Agent、RAG、Vibe Coding及雲地混合部署的取捨。
- 以節省工作時間、降低整體成本及提升業務價值衡量AI效益,不能將使用ChatGPT直接視為企業落地。
- 先釐清問題並標準化資料與流程;固定規則優先採用自動化,必要時才加入AI。
- Agent數量不代表效益,協作設計須同時考量分工、權限、Policy與Token消耗。
- RAG是否適用取決於資料品質及業務容錯程度,不宜直接承擔薪資計算等低容錯工作。
- Vibe Coding加快程式產出,不等於縮短交付週期;維護、驗證與工程治理仍是關鍵。
- 雲端與地端應依機密性、資源利用率及總成本配置,並透過持續學習建立可信任的AI應用。
討論摘錄
企業落地以業務價值為起點
企業導入AI應以業務價值為起點,而非以工具使用率或投入規模判斷成效。Edward Kuo從開發者、架構師與主管三種角色出發,指出同一項AI應用,在使用便利、上線風險與支出管理上,會面臨不同的評估標準。
- 開發者:樂於使用AI寫程式,關注工具能否協助完成開發工作。
- 架構師:關注AI產出上線後的風險,擔心系統出現問題。
- 主管:除了應用效果,也須管理使用支出,避免成本持續增加。
Vibe Coding已在議程、社群與學習場合被廣泛討論,各種使用技巧也持續出現;但離開IT部門與開發者場景後,AI是否真正融入企業工作,仍有明顯落差。講者強調,員工使用ChatGPT提問,不等於企業已完成AI落地,關鍵在於這些使用是否實際幫助業務。
Edward Kuo分享,公司自GPT-3.5時期便成立AI策略部門,投入將近三年後,觀察到的主要改變仍是IT使用AI寫程式,其他部門的工作方式並未出現相應轉變。這項經驗顯示,成立專責組織與持續投入,不能直接視為導入成效;仍須回到各部門的實際問題,確認AI創造了什麼價值。
- 替誰解決問題:明確辨識服務對象,尤其是開發者以外的部門及其工作需求。
- 是否真正改善工作:確認問題是否被解決,以及是否縮短工作時間,而不只是增加一項可使用的工具。
- 整體成本是否下降:不能只看局部工作成本的節省,還須檢視導入後的整體支出是否確實降低。
生成式AI不是所有需求的答案
生成式AI只是AI領域的一部分,不應成為所有需求的預設答案。Edward Kuo指出,從3.5、4.0到Gemini、Claude,模型持續演進,但準確度提升不代表幻覺已消除;企業不能只憑模型較新或準確度有所增加,就認定適合導入。
ChatGPT普及後,部分非IT部門將AI直接等同於生成式AI。當需求是否包含AI成為KPI,提需求的單位便容易替各類系統加上「請用AI」的條件,甚至將原本不同性質的工作,一律改成透過聊天介面處理。這種由技術標籤驅動的做法,容易忽略需求本身是否適合。
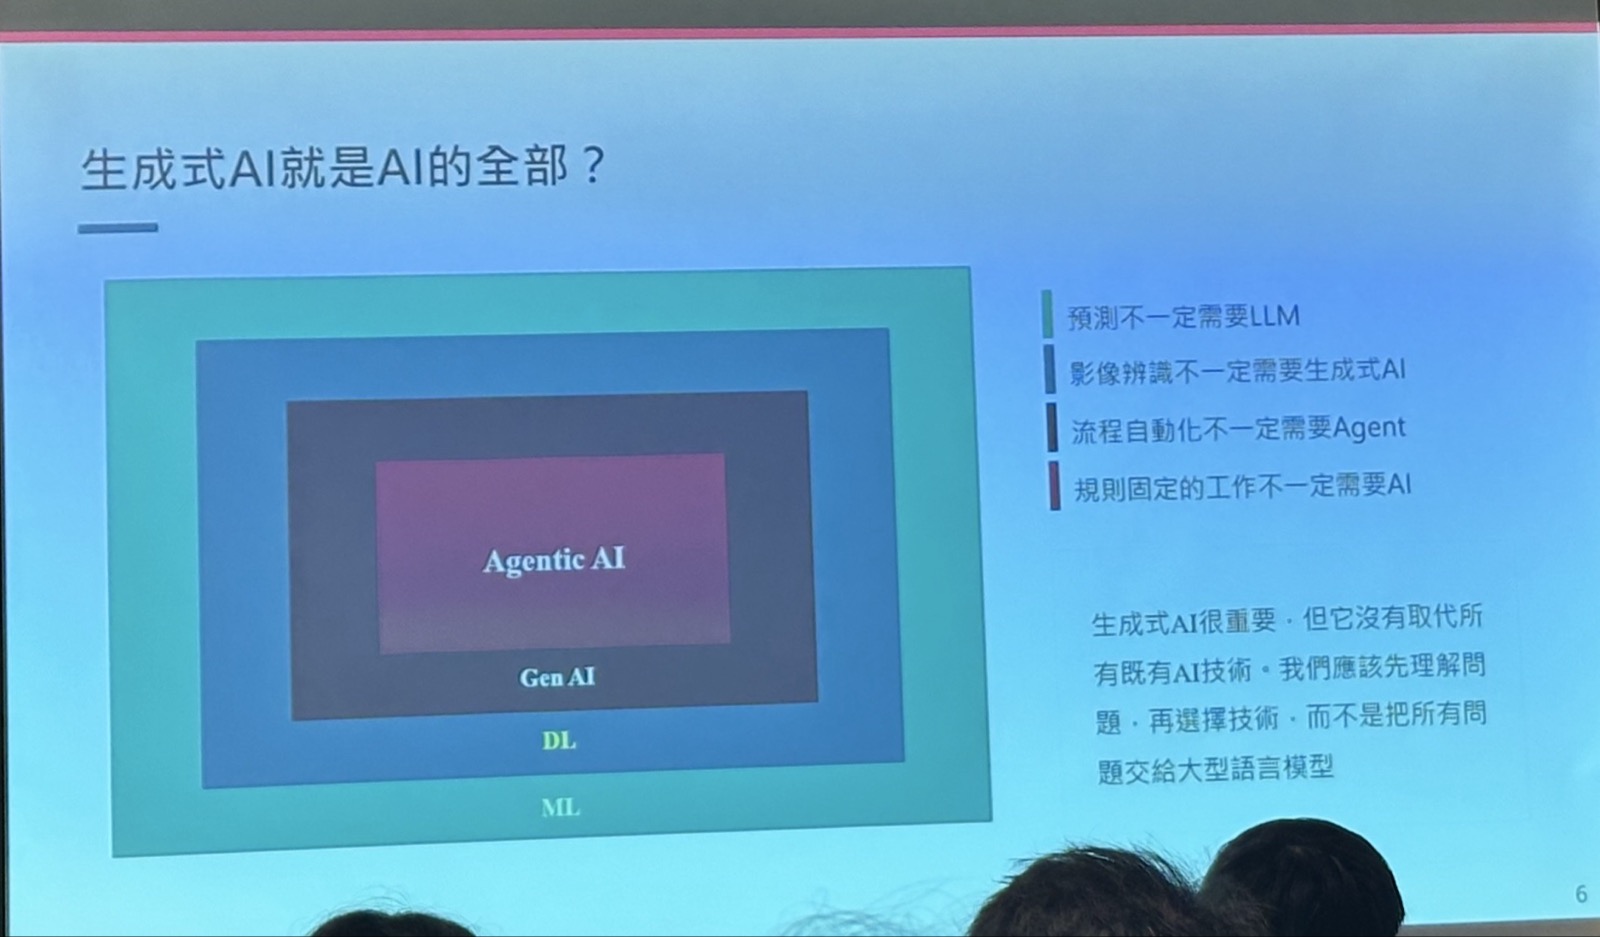
- AI技術不只有生成式AI,也包含machine learning與deep learning。選擇方法時,應先辨識問題性質,而非將生成式AI視為AI的全部。
- 影像辨識不一定適合使用生成式AI;講者指出,針對特定任務採用deep learning、machine learning及訓練方法,可能得到更有效、更準確的結果。
- 固定規則與可流程化的工作,可能透過既有規則或流程設計即可處理,不必為了讓系統具有AI標籤,額外加入生成式AI或聊天功能。
資料品質、流程定義與權限治理
企業導入AI,不能只關注模型能力,更須建立可靠的data、明確的process與資料治理。Edward Kuo指出,語言模型本身可能產生幻覺,若再輸入品質不佳的資料,回答錯誤會加劇,也更難追查問題來源。
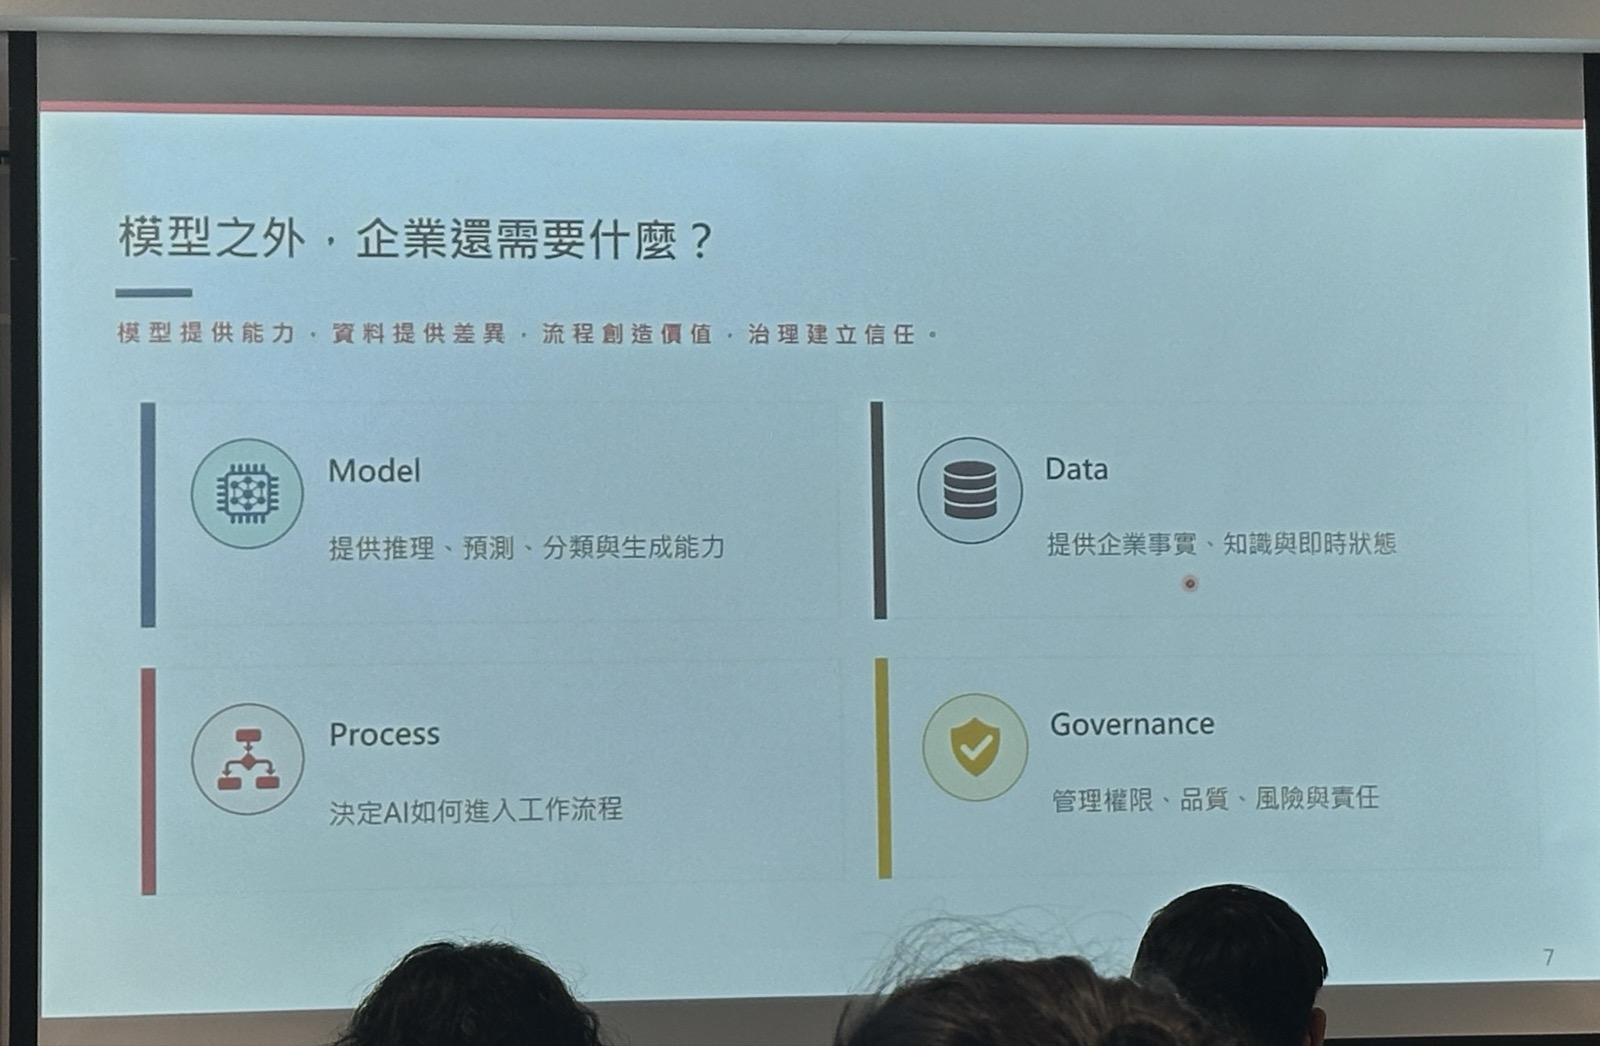
- 流程定義:既有作業若未清楚定義,就必須先補齊SOP,不能期待AI自行理解模糊的工作方式。講者指出,導入過程往往因此需要投入大量時間釐清流程。
- 權限治理:資料匯入後,不代表所有員工都應能透過AI取得。若HR詢問時,AI回答了只有財務可看的資訊,即形成跨部門洩密風險;資料存取邊界須納入治理。
- 語意對齊:同樣稱為Costing的資料,在不同部門可能分別指成本或花費。名稱相同不代表意義一致,必須對齊欄位、格式與語意,並持續治理及監督。
資料治理也須延伸至資料產生方式。供RAG使用的外部文件若由人工撰寫,內容未必正確,也可能被修改,進而使LLM依據錯誤資料作答。講者希望透過系統化產生、整理資料及自動化,減少人工介入造成的錯誤與失真,而非只在模型端尋找改善方法。
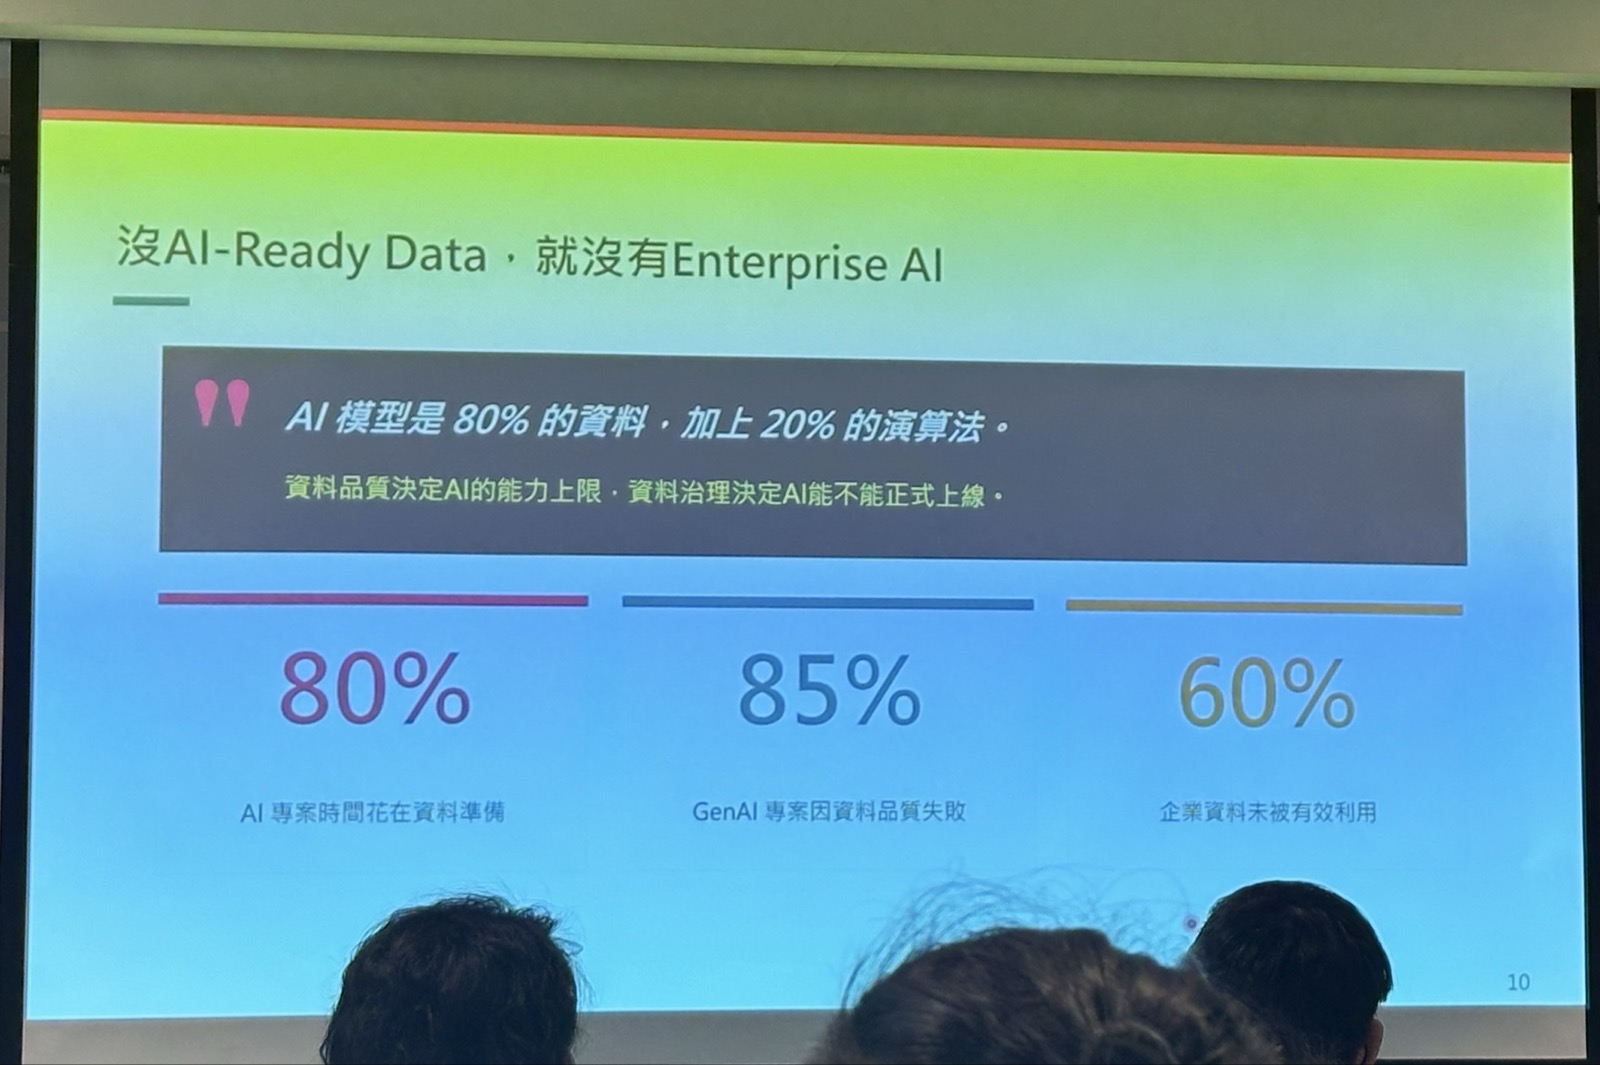
Edward Kuo分享,實際導入案例中,即使資料量不大,仍約有80%的時間用於整理資料及驗證正確性,之後才進行AI相關工作。另一項障礙是部分知識根本不在資料庫中,而只存在個人記憶裡,難以直接供AI使用。這些經驗顯示,資料是否完整、可信且可被理解,往往比持續調整模型更直接影響企業應用成效。
先自動化,再評估AI的必要性
企業應先釐清問題,再比較RPA、一般系統與AI,選擇能滿足需求的最簡單技術。將人工工作轉為自動化,不代表必須導入AI;若固定規則與流程已能透過系統完成,就不必增加AI帶來的不確定性。
Edward Kuo分享,AI上線後若回答時對時錯,使用者會將其視為系統缺陷,並要求修正。即使解釋錯誤來自AI幻覺,也無法消除使用者對穩定性的期待。因此,技術選型不能只看能否產出結果,也須考量交付後能否可靠運作。
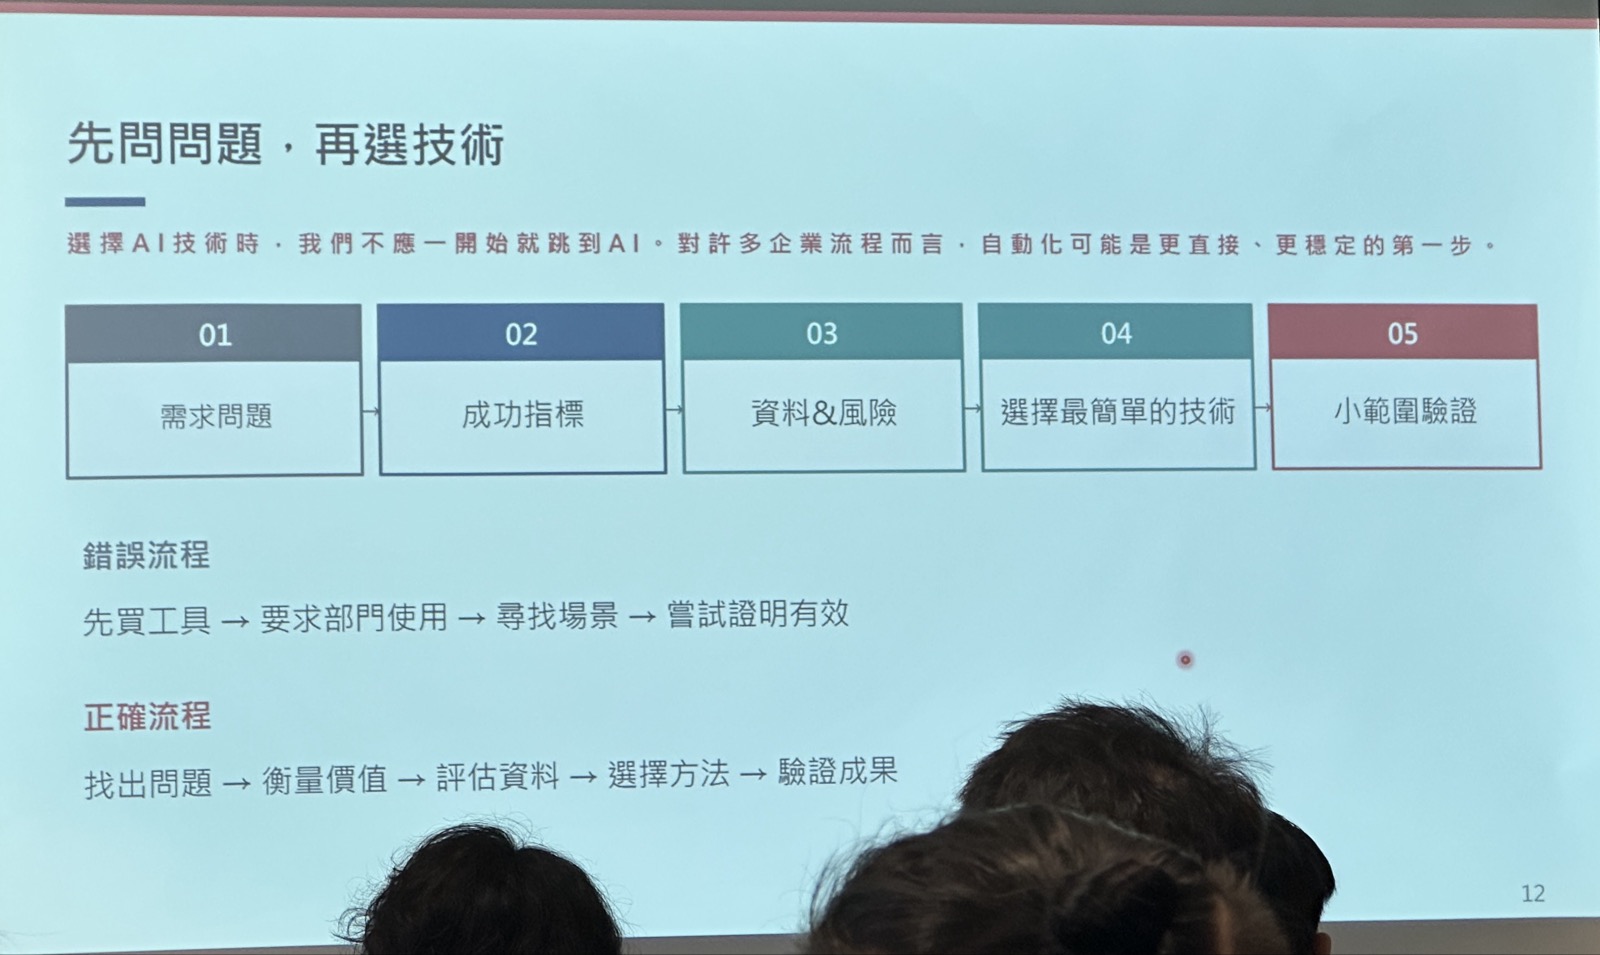
講者回顧早期試錯經驗:先購買大量AI工具、投入預算,再尋找應用場景,最後可能發現工具並不適合需求。後來改為由部門問題出發,先判斷自動化或AI是否合適,再評估資料、選擇方法並驗證效果,避免讓既有採購反過來主導技術選擇。
- 找出問題:確認部門實際遇到的困難,而非先指定使用AI。
- 評估資料:確認資料是否適合支援預期的AI應用。
- 選擇方法:比較自動化與AI,優先採用足以解決問題的技術。
- 驗證效果:確認所選方法能否滿足需求,再推進導入。
流程與資料標準化是導入前提。若作業方式今天、明天各不相同,缺乏一致規則,連自動化都難以完成,更不能期待AI自行配合任意變動。先建立可重複執行的流程與一致資料,才能讓後續技術有明確的運作基礎。
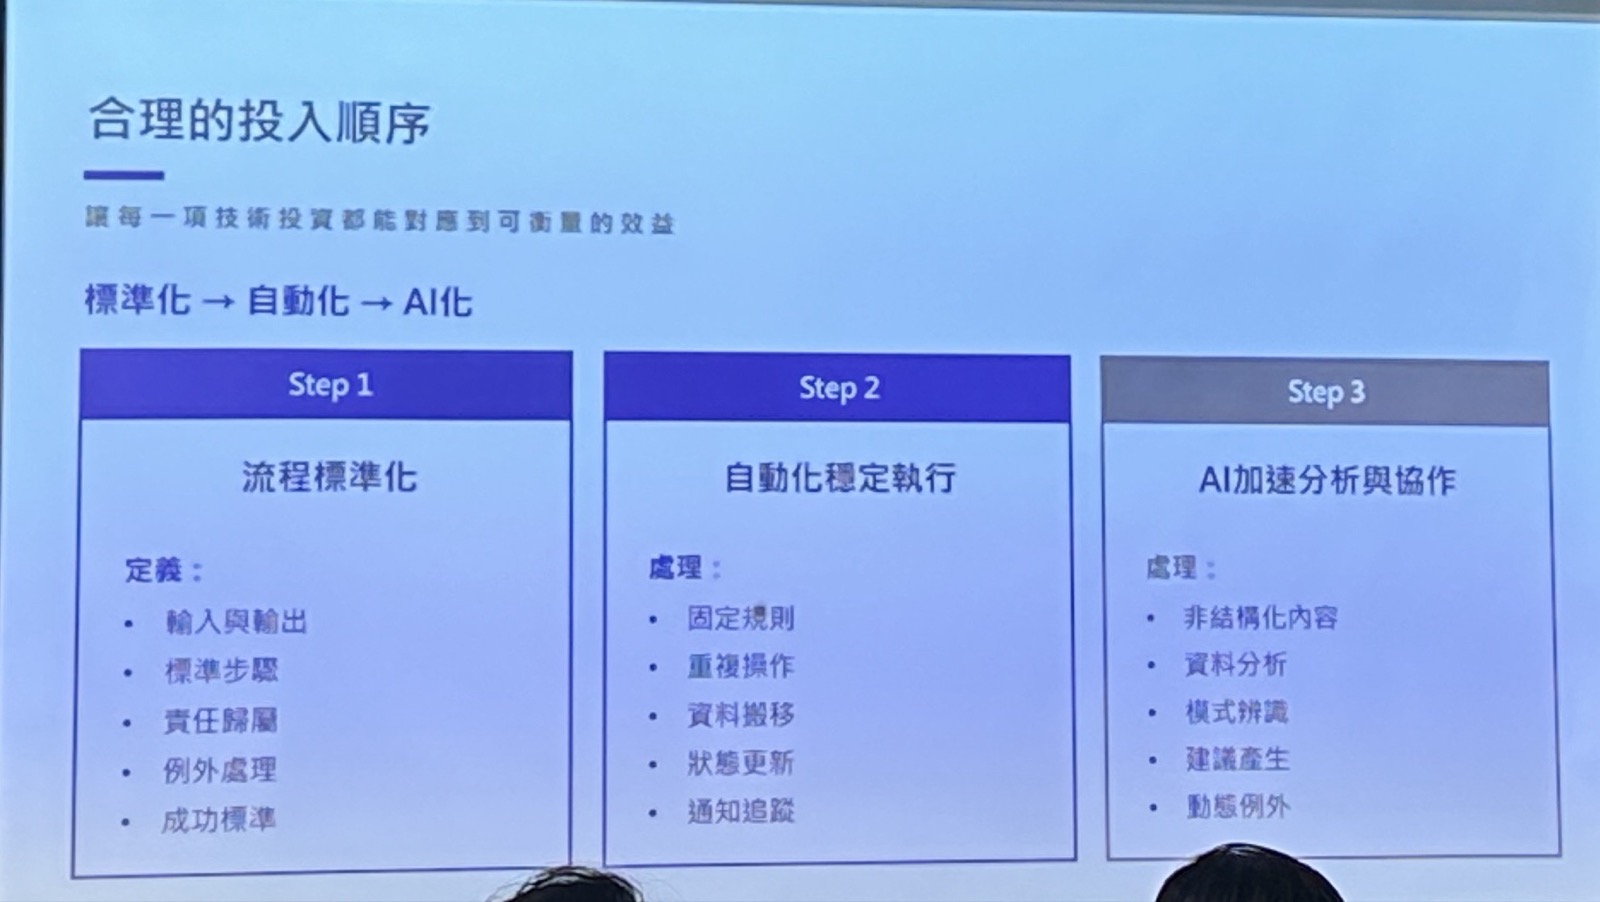
在一項固定流程需求的比較中,RPA約一至兩天即可完成,AI Agent也能達成相同效果,卻另須準備資料與系統,並在AI系統外增加RPA、Skill或Policy等防錯機制。當結果相同、投入卻更高時,講者不會選擇以AI取代既有自動化方式。
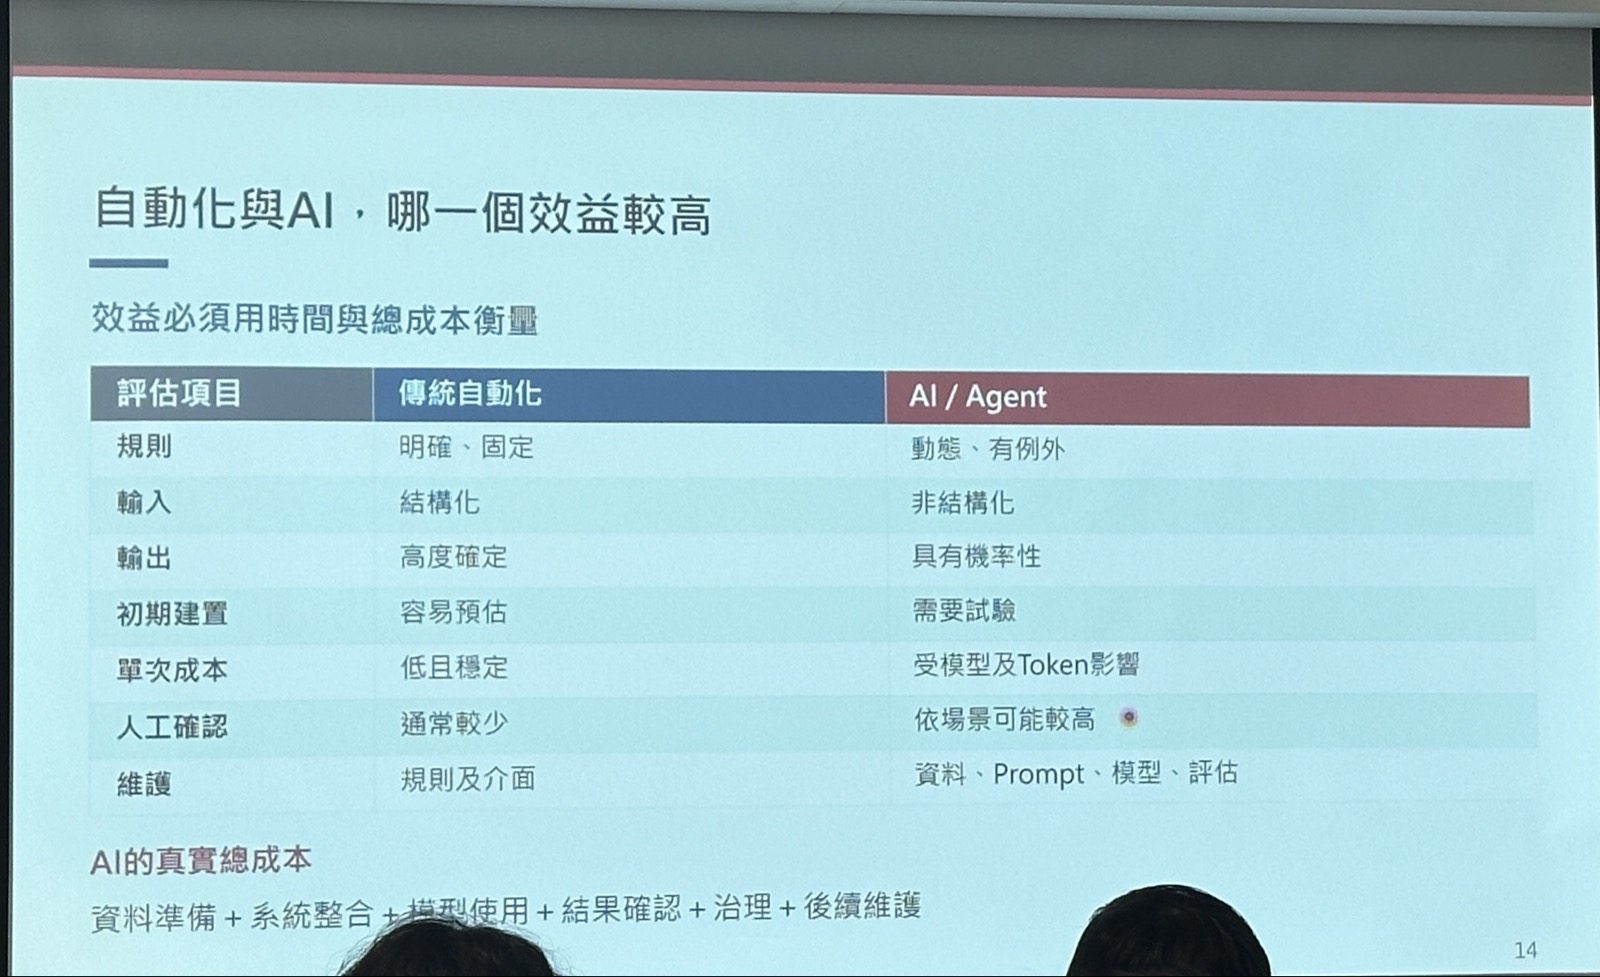
整體效益評估須納入開發、維運及模型使用的Token成本,而非只看工作是否能由AI完成。講者採取分階段導入:先以自動化完成明確規則,再針對RPA無法處理的部分評估AI,且導入後仍須設定清楚的運作邊界。
AI Agent的應用與協作架構
AI Agent讓應用從Chatbot的對話互動,逐步走向自主規劃、呼叫工具與執行任務,但能力擴充不代表企業導入已經成熟。Edward Kuo指出,Agent確實增加了導入上的幫助,但技術變化快速,實際成效仍須依場景驗證。以他的觀察,程式開發是目前企業應用中較成功的方向;智慧客服則早已有Bot基礎,AI主要是在既有功能上進一步強化。
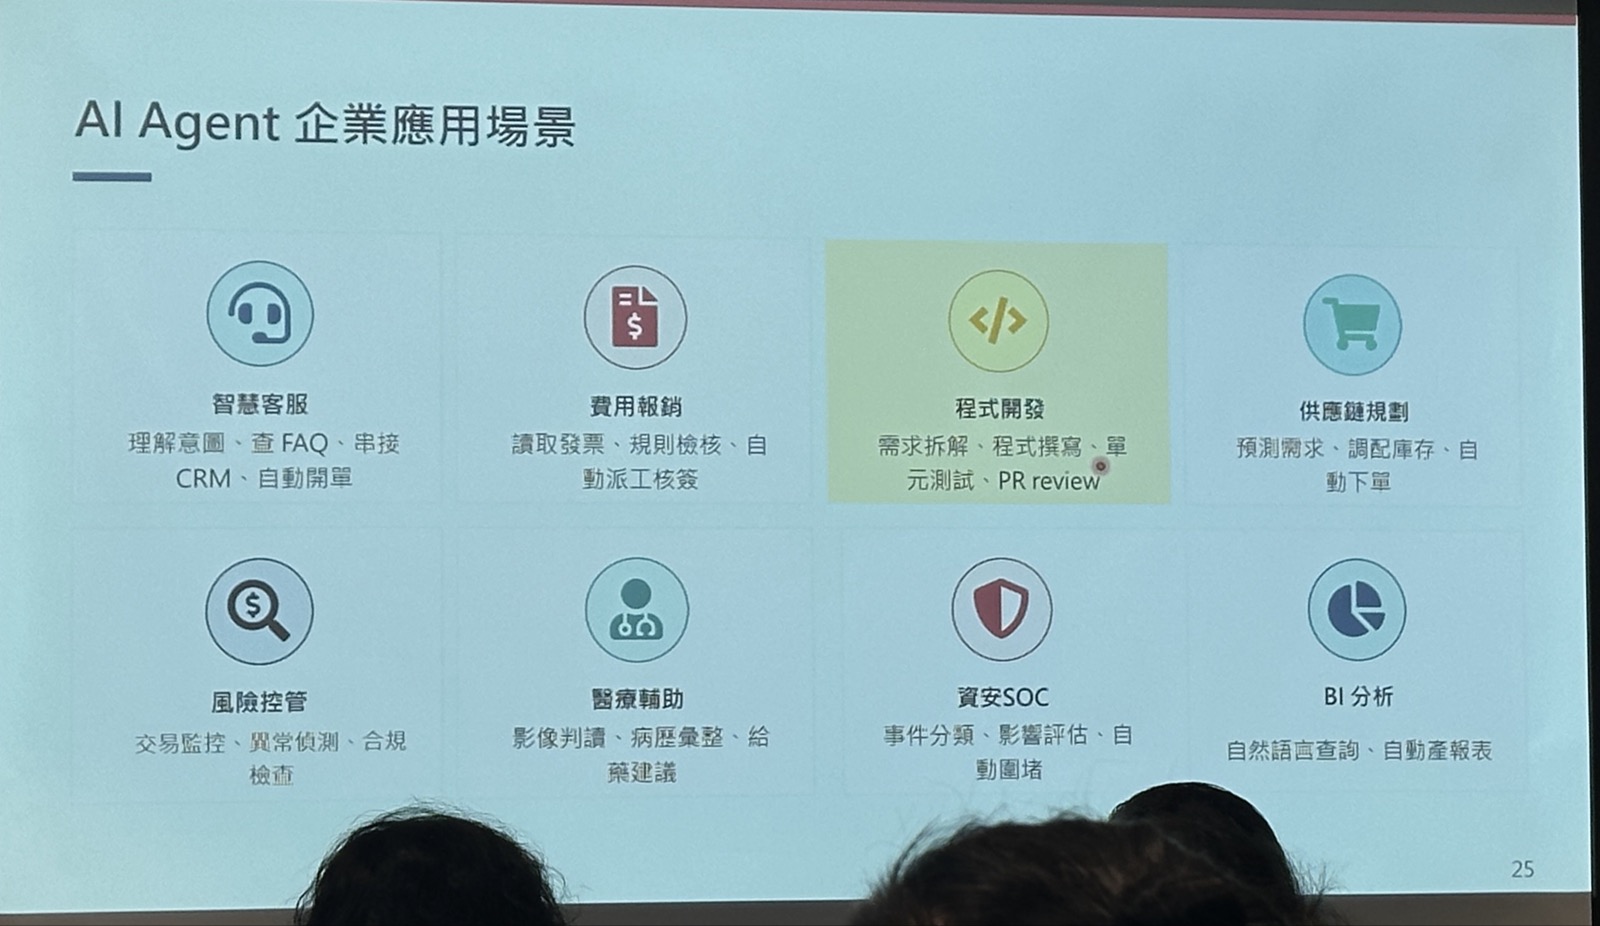
AI Agent也不必然依賴生成式AI。講者以企業報帳及費用申請為例,人工辨識與輸入發票號碼相當耗力,因此團隊結合視覺辨識與自行開發的Agent,協助處理發票辨識工作。這類應用的關鍵是辨識能力與任務執行的整合,而不是一定要採用生成式AI。
從單一Agent擴展到Multi-Agent時,應先選擇符合工作流程的協作架構。講者介紹的方式包含依序執行、同時執行、主管分派與多角色協作;團隊較常採用主管分派方式,由前端Agent接收需求,再將工作分派給其他Agent處理。
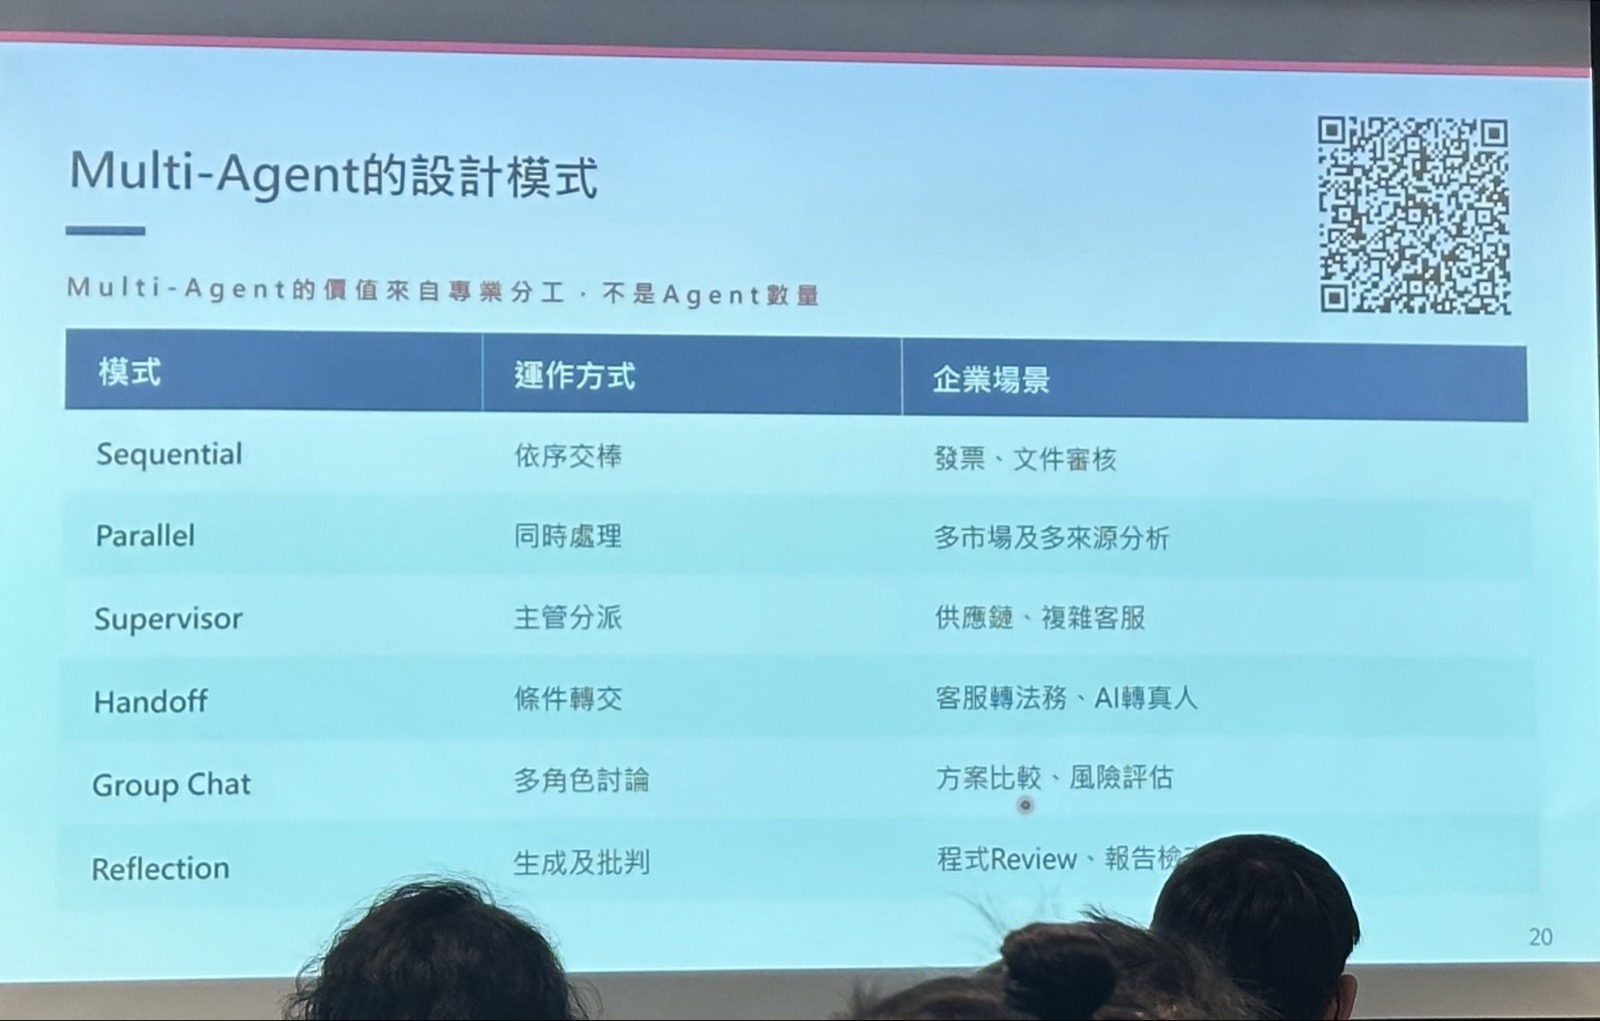
Agent並非越多越好。講者將多Agent協作比喻為團隊擴大:單人工作可以直接處理,參與者增加後,就必須建立協作規範。因此,除了技術架構,還需要更多Governance與Policy,明確約束各Agent的角色與行為,避免彼此衝突或超出職責範圍。
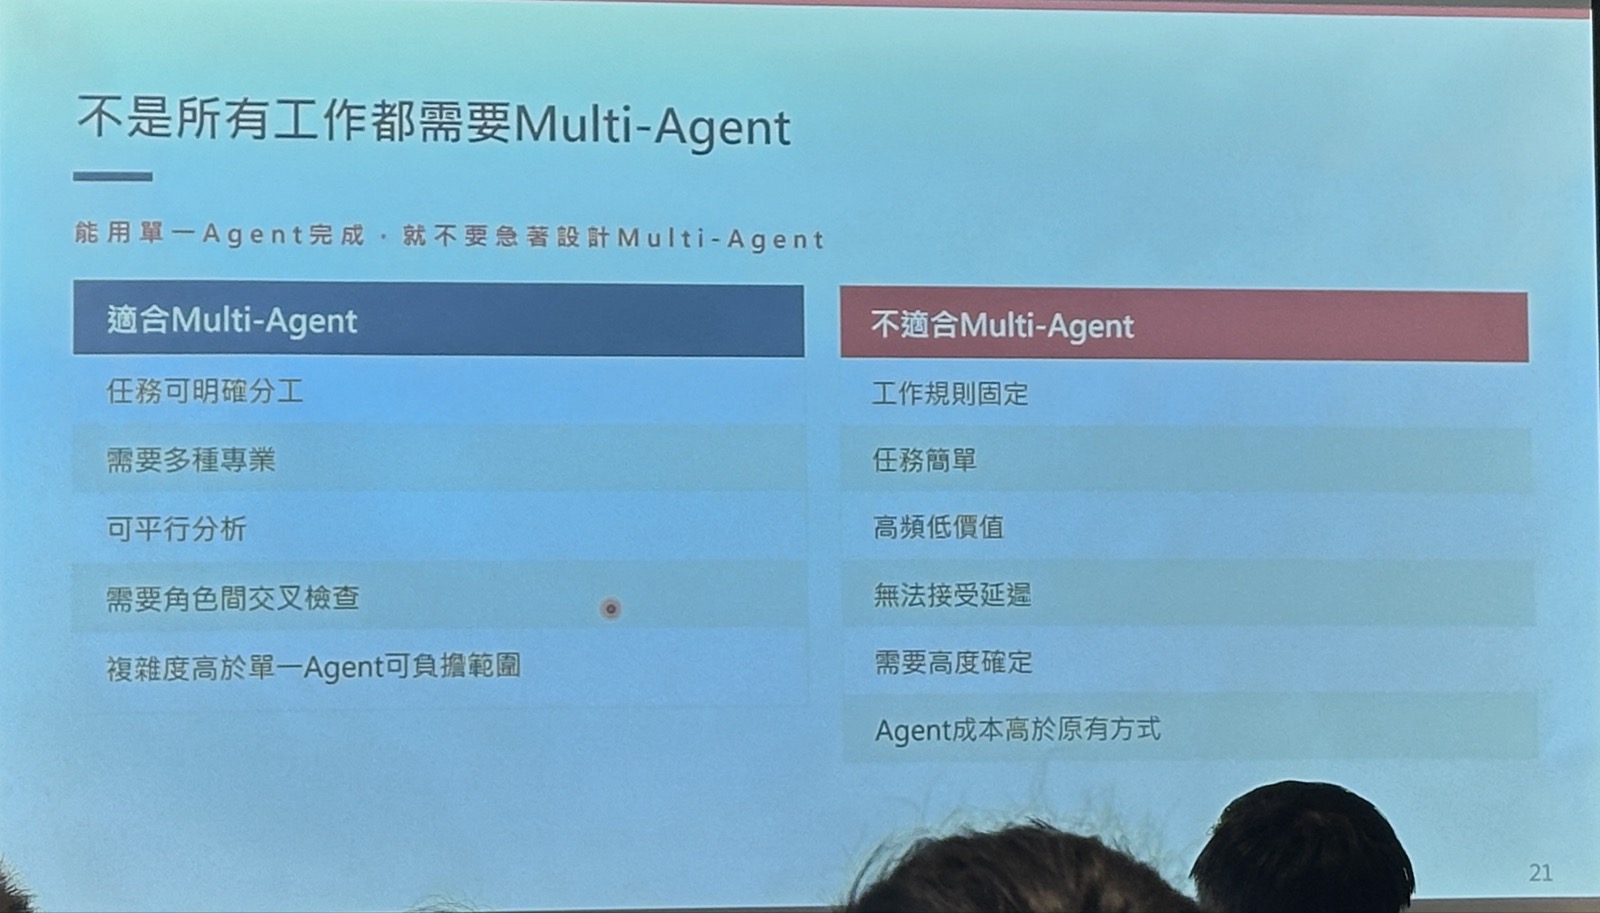
- 單一Agent已能完成需求時,不必為了採用Multi-Agent而增加數量。
- 任務分工明確、Policy與執行路徑已定義,能清楚指定從A到B如何交接時,才適合評估Multi-Agent。
- 存在可平行處理的任務時,可考慮多Agent協作;仍須依實際情境選擇架構,而非將Multi-Agent視為通用解法。
Multi-Agent協作架構參考:https://blog.edwardkuo.dev/multi-agent-%E5%A4%9A%E4%BB%A3%E7%90%86%E5%8D%94%E4%BD%9C%E5%90%84%E7%A8%AE%E9%A1%9E%E5%9E%8B%E7%9A%84%E6%9E%B6%E6%A7%8B-ec10316b1348
Token成本觀測與用量管理
Token支出已從開發工具的使用成本,轉為企業需要持續管理的資源。Edward Kuo以演講當年六月後的計費與成本變化為例,指出GitHub Copilot的費用不再只是固定訂閱金額,Token消耗開始影響支出,也讓主管重新比較使用AI與增聘人力的效益。團隊因此在下半年開始關注Agent的Token管理。
相同問題,直接詢問模型與交由Agent處理,可能產生不同的Token用量。Agent之間的互動會累積更多Context Window,而上下文增加也會帶動Token消耗。因此,成本不能只看使用者輸入的問題長度,還須考量背後的Agent執行流程。
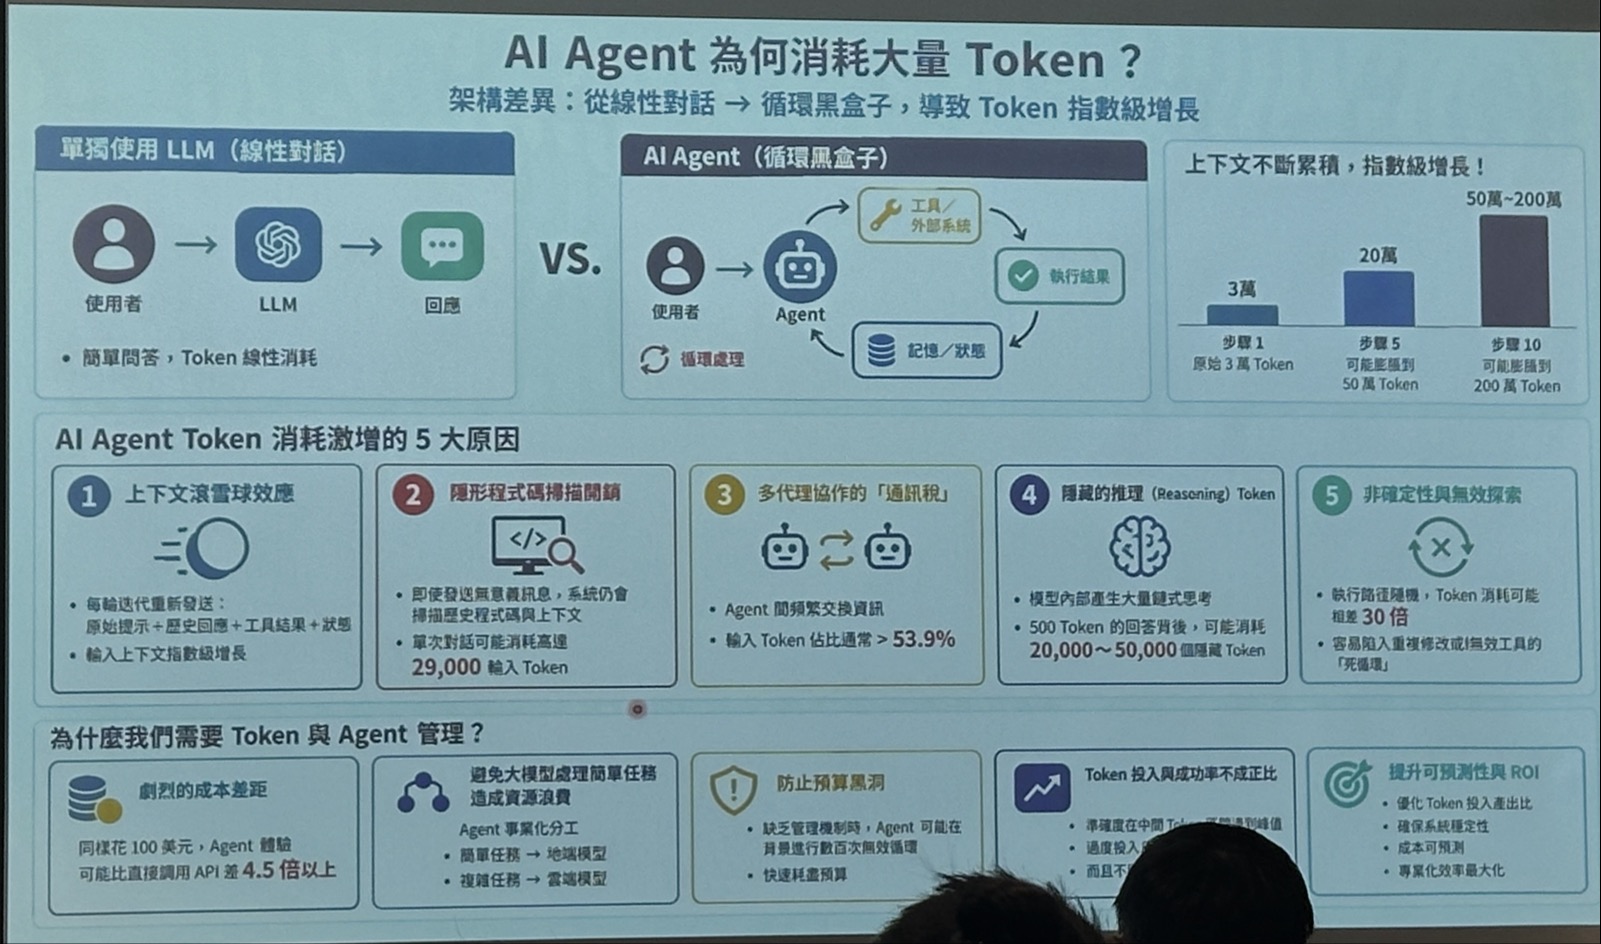
商用工具的推理與Agent流程往往是黑盒子,各家實作不同,使用者難以掌握背後如何分派工作及累積上下文。講者指出,減少Agent介入未必能保有原生工具的效果;自行開發Agent則較有機會控制任務與消耗,但仍須明確界定每個Agent的工作,避免Multi-Agent執行時產生難以控制的支出。
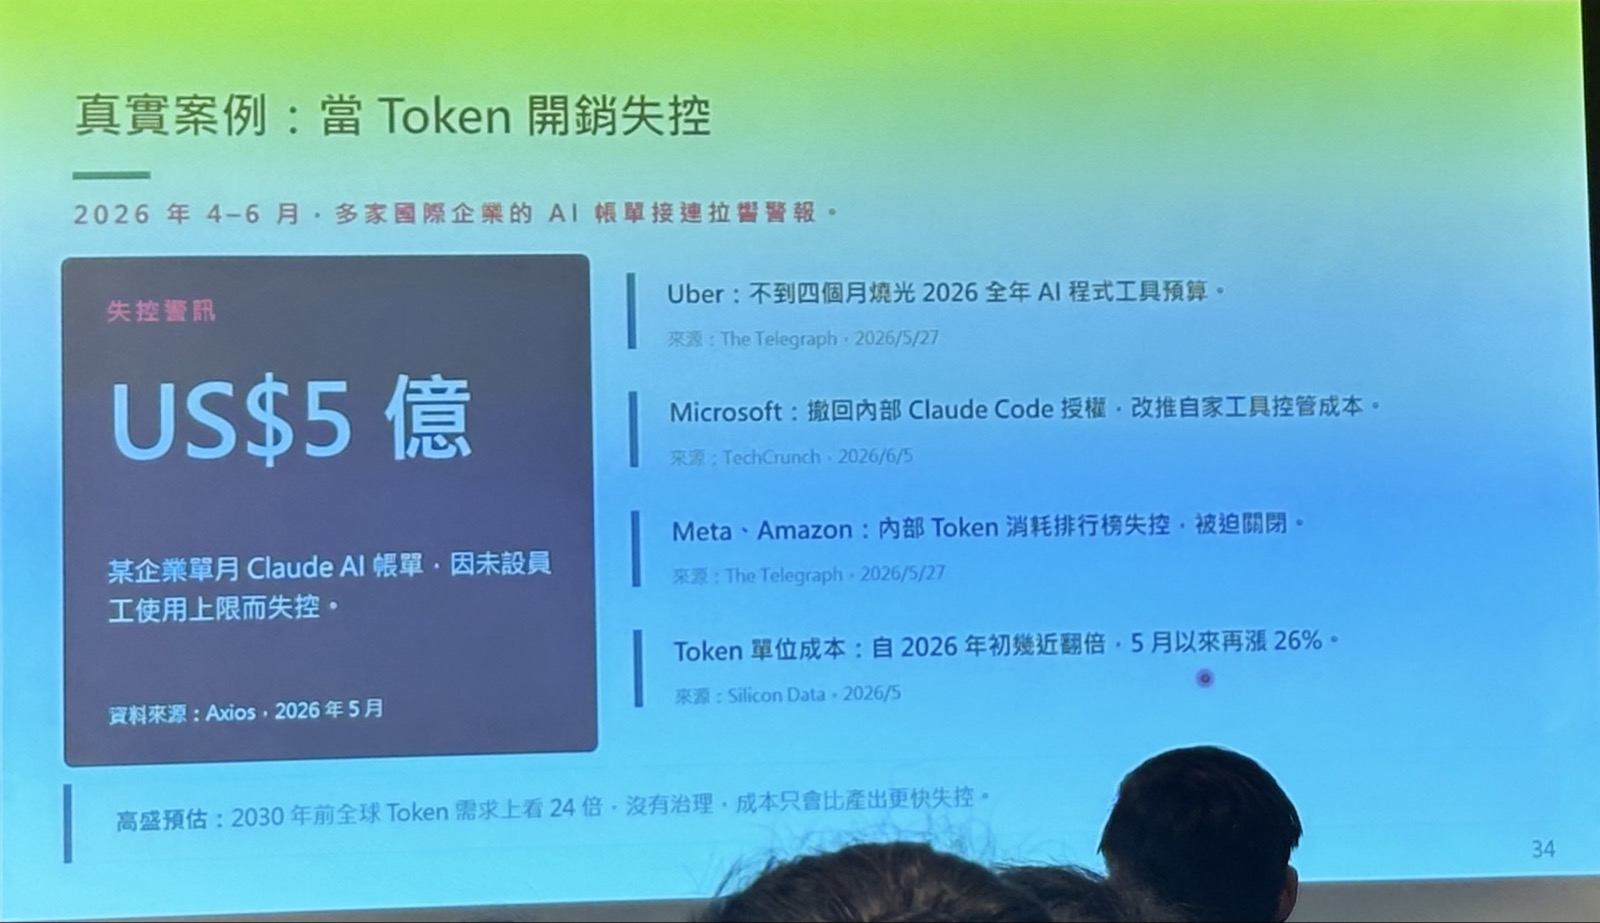
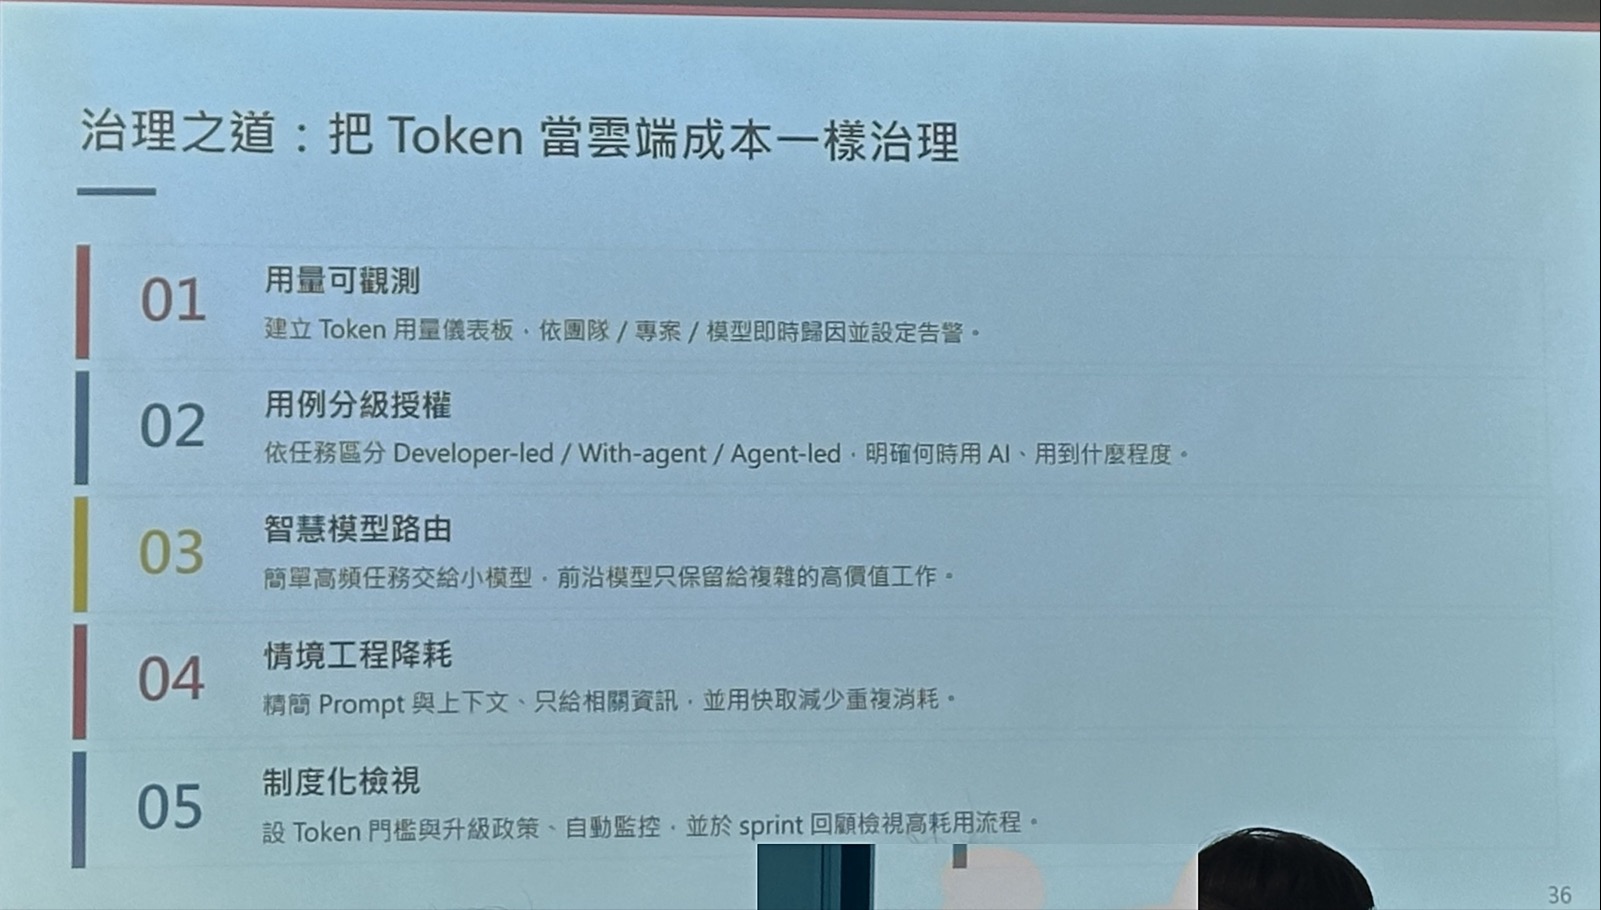
- 建立用量觀測:先掌握實際消耗,讓開發者與使用部門配合管理,而非只關注功能是否可用。
- 依場景選擇模型:判斷哪些模型適合開發工作、哪些適合部門應用,不必一律開放或採用最大、最強的模型。
- 減少送入模型的上下文:透過skill與Prompt要求,在送出前進行Token及context壓縮,以降低消耗。
- 將Token納入制度化管理:比照雲端資源的管理方式,持續觀測與調整用量,而非等到費用增加才處理。
RAG容錯限制與部門小模型
RAG可透過企業文件補充LLM缺乏的內部知識,支援企業搜尋與對話,但有文件依據不代表回答必然正確。Edward Kuo指出,實際效果仍受文件版本、檢索品質、內容語意及語言模型影響;能否導入,應先看業務對錯誤的容忍程度。
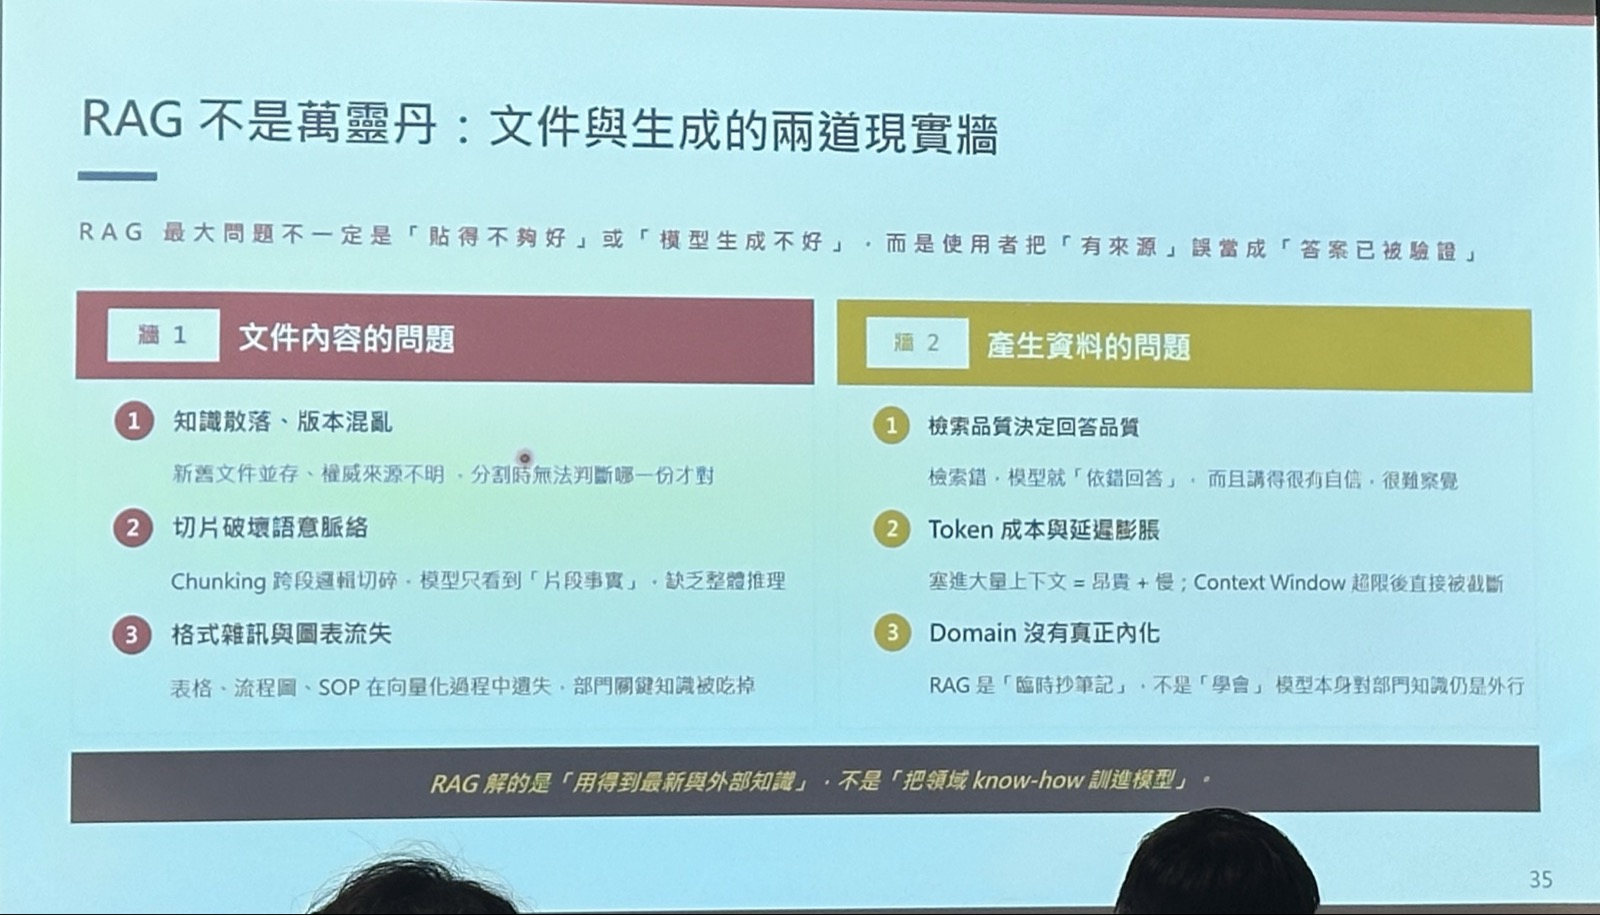
- 版本與檢索:文件由版本1更新至版本2後,也需要更新對應向量。若版本與Index管理不清楚,檢索便可能取得舊內容,而非最新且適用的資料。
- 文件語意:員工撰寫的文件若連人都難以理解,轉成向量也不會自動消除歧義,不能期待AI因此正確理解內容。
- 重寫成本:講者曾嘗試透過LM重新產生文件,再轉為MD檔供後續向量化使用,但這道處理流程也增加模型使用成本。
上線後,使用者曾拿著原始文件質疑回答為何錯誤,促使團隊重新評估容錯要求。薪資計算就是低容錯案例:即使文件已列出薪資公式,也不代表能讓GPT讀取後直接計算並採用結果。若金額算錯,無法只用「AI做錯了」向員工交代。
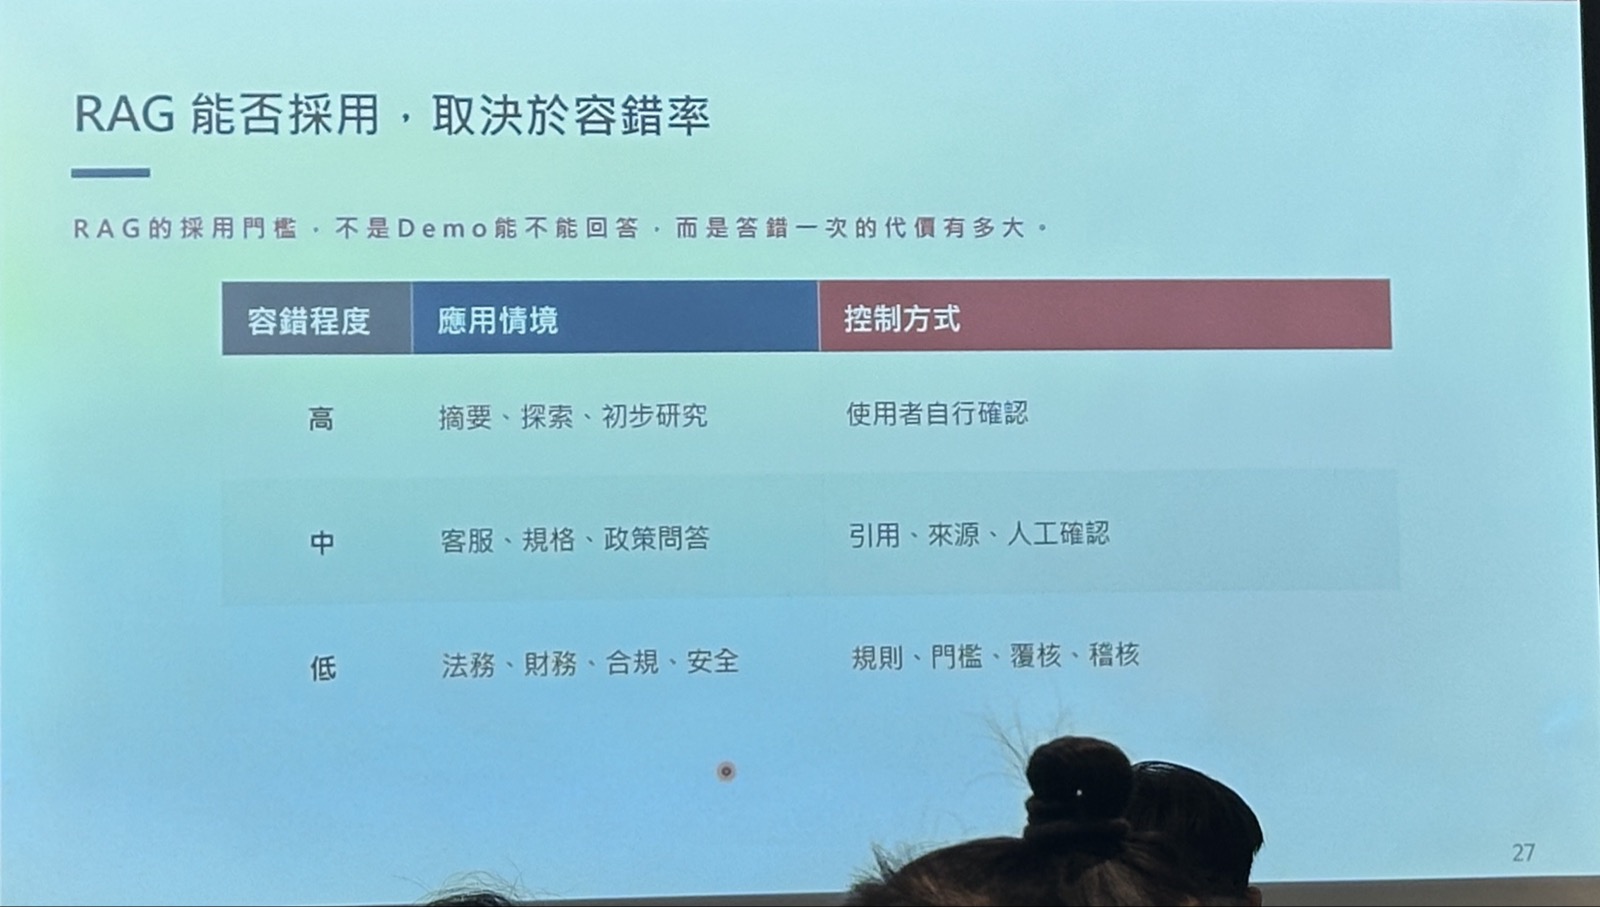
講者團隊內部以可容忍約兩成錯誤,作為是否推動RAG的參考門檻;這是其場景篩選方式,並非RAG的通用準確率標準。若部門連1%的錯誤都無法接受,團隊便不採用RAG。相較之下,摘要、搜尋與建議等錯誤影響較有限的用途,更適合評估;涉及工作流程或影響他人的結果,則採取較審慎的態度。
在RAG實作之後,團隊轉向以SLM內化企業知識。原因不只是大語言模型仍會犯錯,也在於相同術語在不同企業可能有不同定義,通用理解未必符合內部語意。講者嘗試將公司的Domain Know-how與Culture放入小模型,後續又發現HR與其他部門的知識仍有差異,因此進一步朝每個部門配置小模型的方向發展,讓模型更貼近各部門的知識與用語。
Vibe Coding的交付與維護風險
Vibe Coding能加快程式產出,卻不代表企業交付同步加速。Edward Kuo觀察,使用AI後,實際交付週期仍約兩至三週;關鍵落差在於快速寫出程式之外,仍須完成工程治理,才能讓成果進入正式環境或用於商業用途。
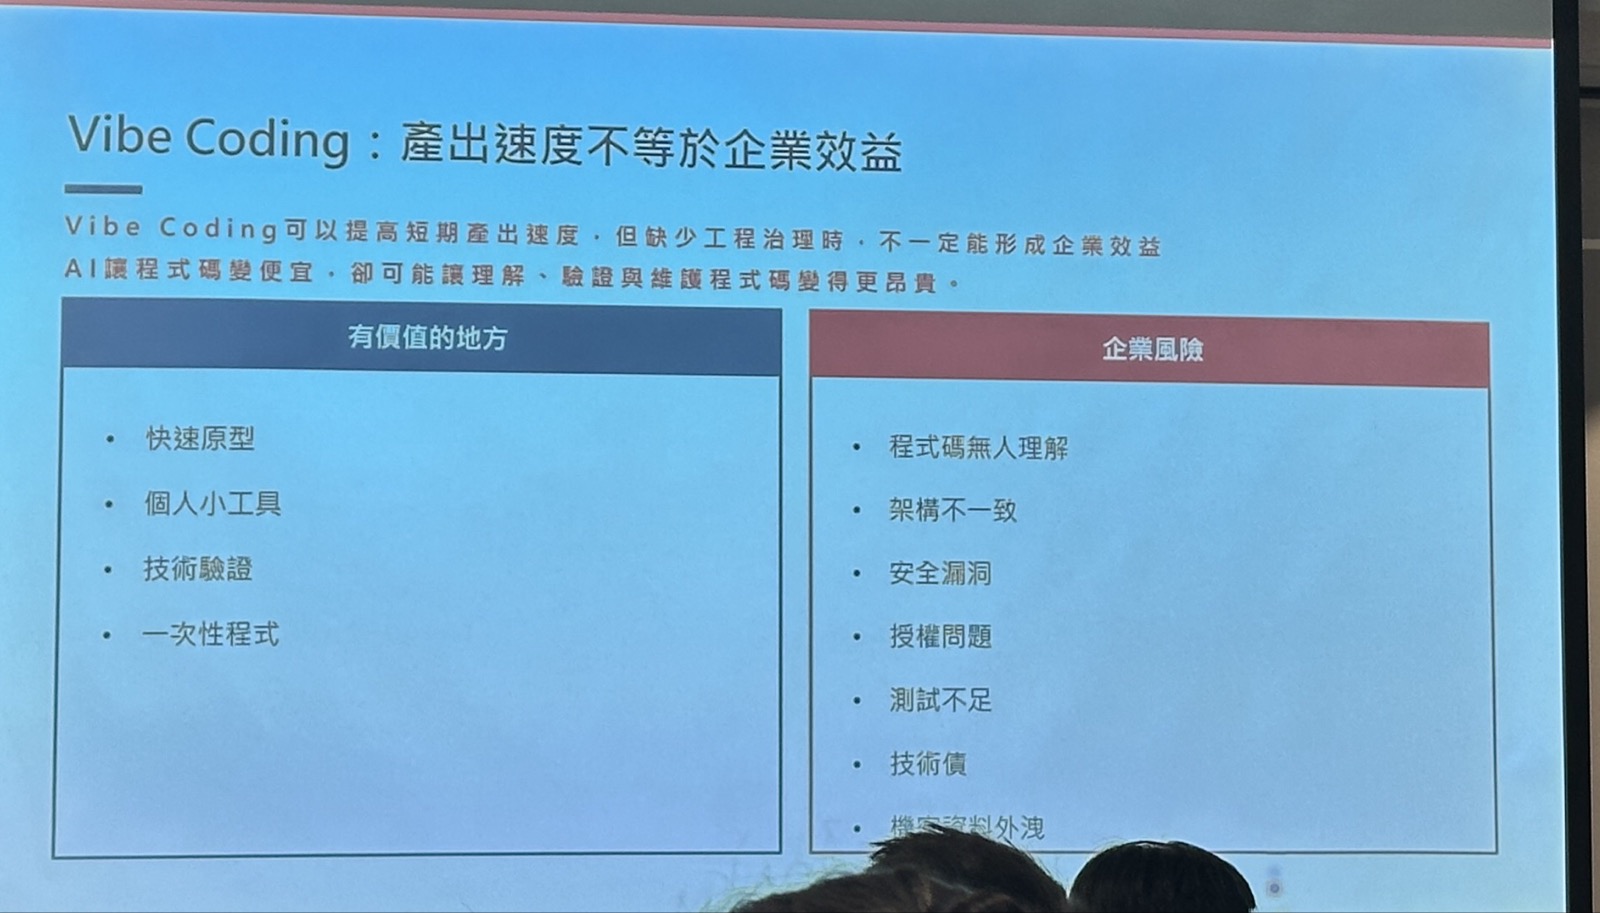
企業系統不能沿用個人實驗或學生作品「出錯也沒關係」的容錯方式。講者指出,企業系統一旦出錯,損失可能達數百萬、上千萬,甚至數億,因此需要平台工程協助治理AI產出,而非將程式寫完視為可以直接上線。
- 交接不一定容易:AI產出的code若無人能接手,原開發者即使請假,仍可能需要隨時接電話處理問題,形成維護負擔。
- 不能假設AI能無縫接手:以AI閱讀另一個AI產出的程式,理論上可行,但不同Prompt、能力與需求理解未必一致;即使使用skills,也不保證能保留原先對需求的理解。
- 簡單需求可能被過度複雜化:講者曾比較AI coding與資深工程師的成果,發現AI可能將不複雜的需求寫成較複雜的code,而資深工程師能以更簡潔的方式處理,讓後續驗證與維護更容易。
「需求沒有那麼複雜,AI會把code變得很複雜」
— Edward Kuo
評估Vibe Coding的效益,不能只看當下產出速度,也須納入交接、驗證與後續維運的負擔。若程式難以理解或接手,前端節省的時間未必能轉化為整體企業效率。
雲地混合部署與基礎設施取捨
雲地混合部署的核心,是依成本、導入速度與Security要求,將AI工作安排在合適的位置。Edward Kuo表示,團隊起初採全雲端,但隨著使用成本增加,開始評估地端Server;然而,Server採購與建置需要時間,無法立即配合AI實驗與導入,因此最終採取混合部署,而非全面移往單一環境。
- 雲端:利用彈性與快速部署能力,支援實驗、加速導入與創新。
- 地端:依Security要求處理不能上雲的資料,包括RD文件、財務資訊及個人資訊,相關Agent也安排在地端執行。
- Local與邊緣:依工廠及邊緣場景的需求配置執行環境,不以同一套部署方式涵蓋所有工作。
地端是否划算,不能只比較GPU採購價格與雲端Token費用。講者提醒,企業還須計入memory、Storage、網路架構與設備、折舊及電力成本。隨著應用重心轉向既有模型的推論,維持上下文與對話記憶所需的記憶體及儲存資源也更重要;硬體投資若只聚焦GPU,容易低估完整建置成本。
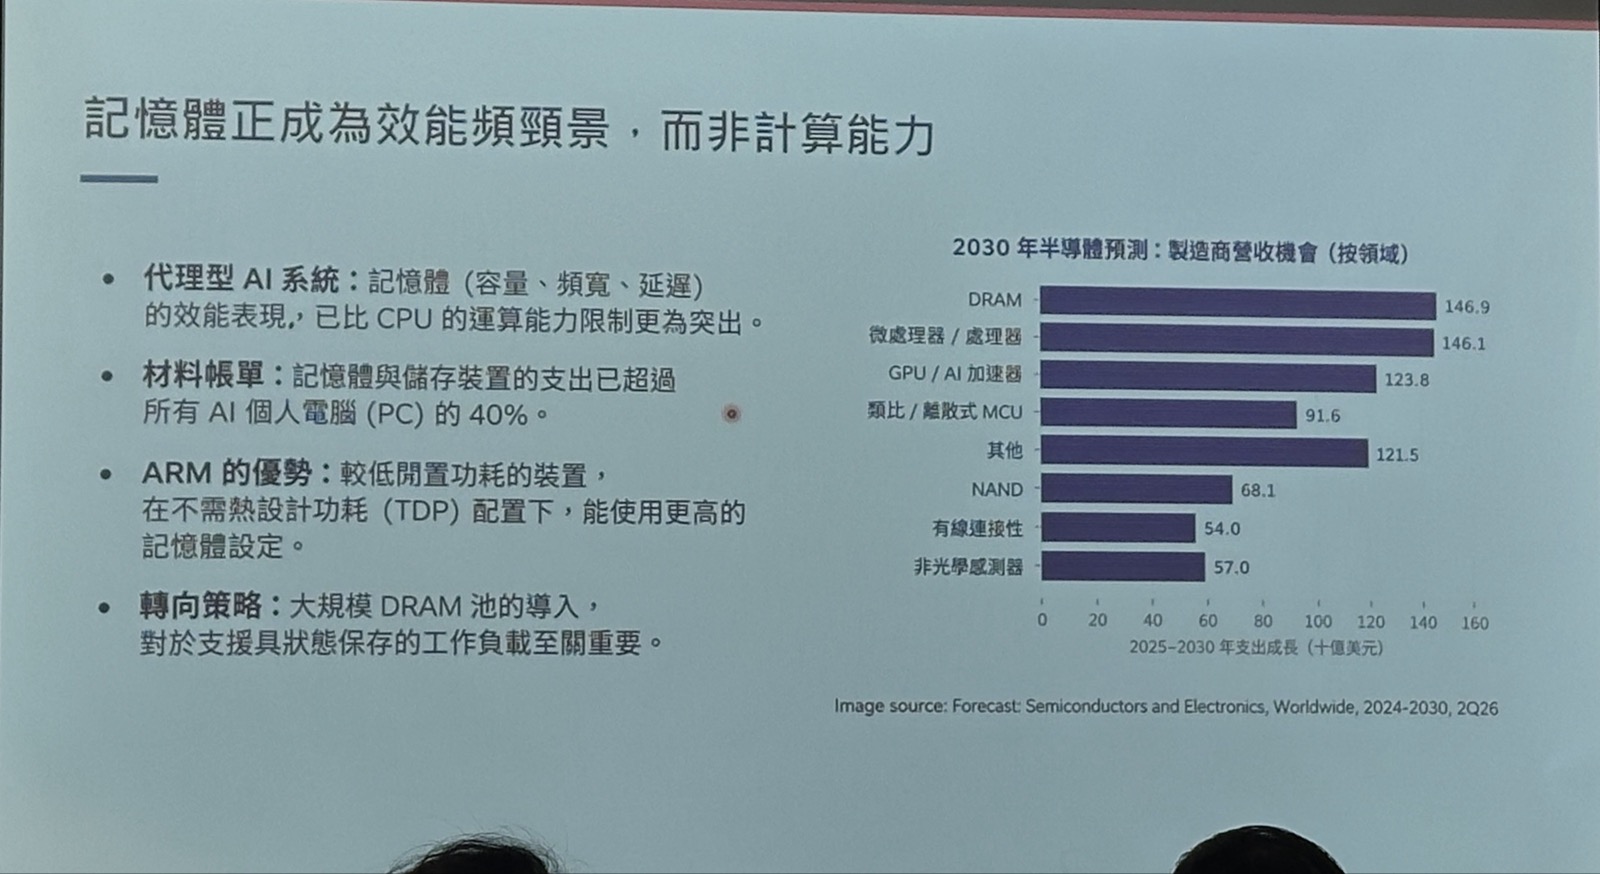
利用率是另一項關鍵。講者引述的調查顯示,部分設備使用率約兩成,其餘時間多處於閒置,但電源持續開啟,仍會產生耗電成本。因此,評估地端投資時,除了設備價格,也要檢視實際工作量、閒置時間及可替代的雲端用量,再決定哪些需求值得配置固定資源、哪些適合保留雲端彈性。
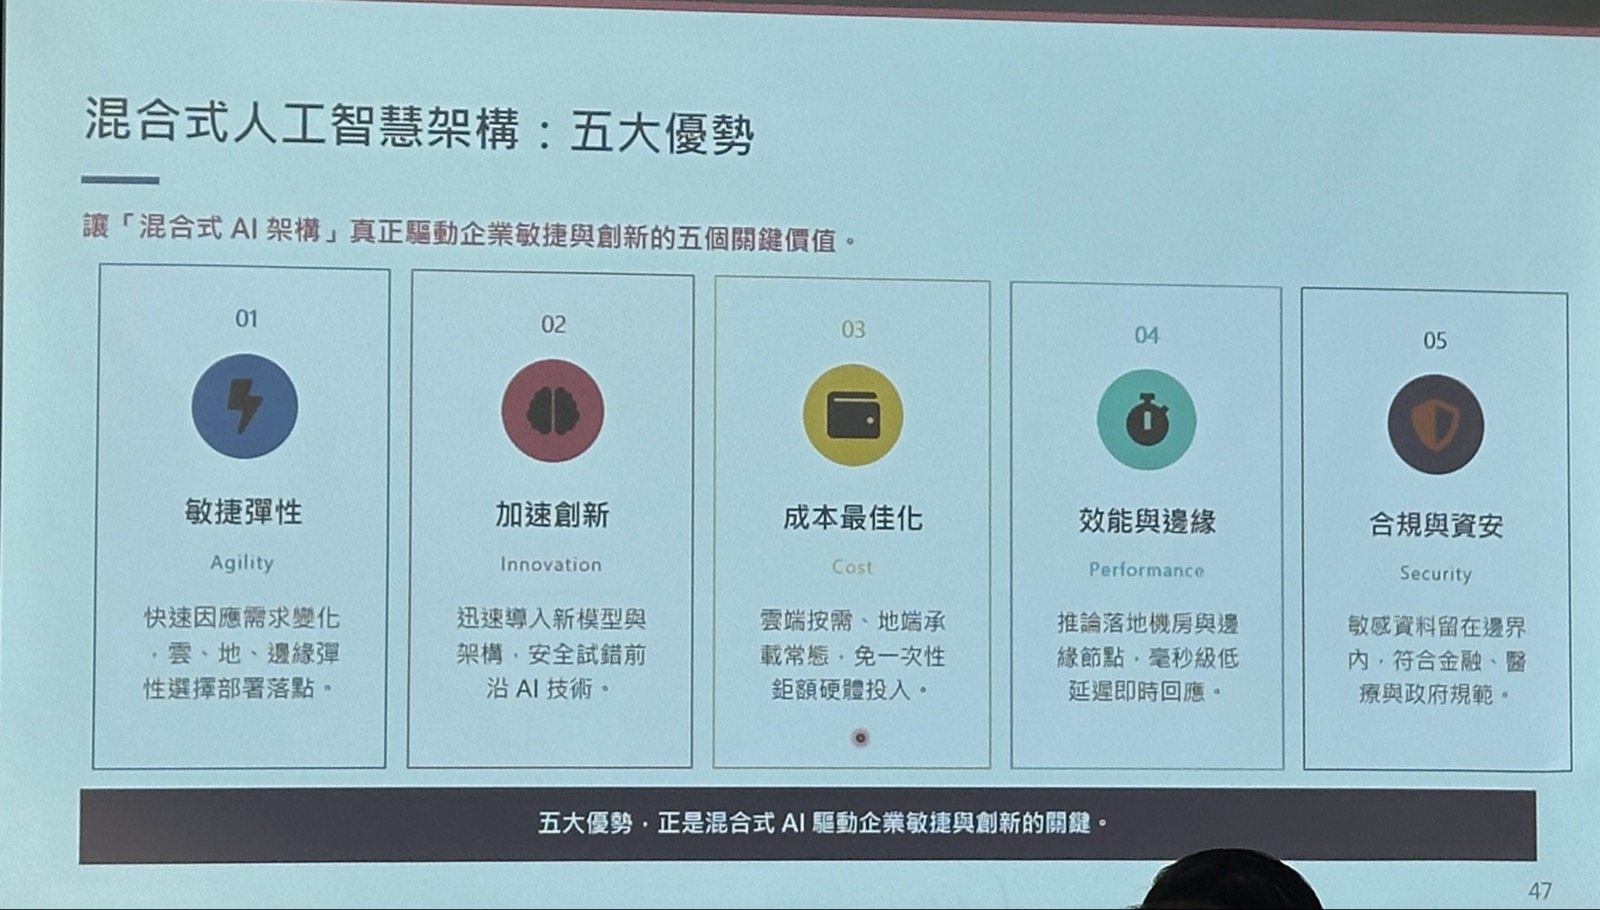
講者以微軟技術建構雲地協作架構,將Local需求與其他工作分流處理。對照Microsoft Foundry的雲地邊緣整合方向,Foundry Local可支援離線、低延遲與資料不外流的需求,呼應工廠、邊緣及機密資料處理的部署考量。選擇執行位置時,仍應以場景需求、Security限制與總成本為依據,而非單純追求全雲端或全地端。
導入推進、可信任AI與人才學習
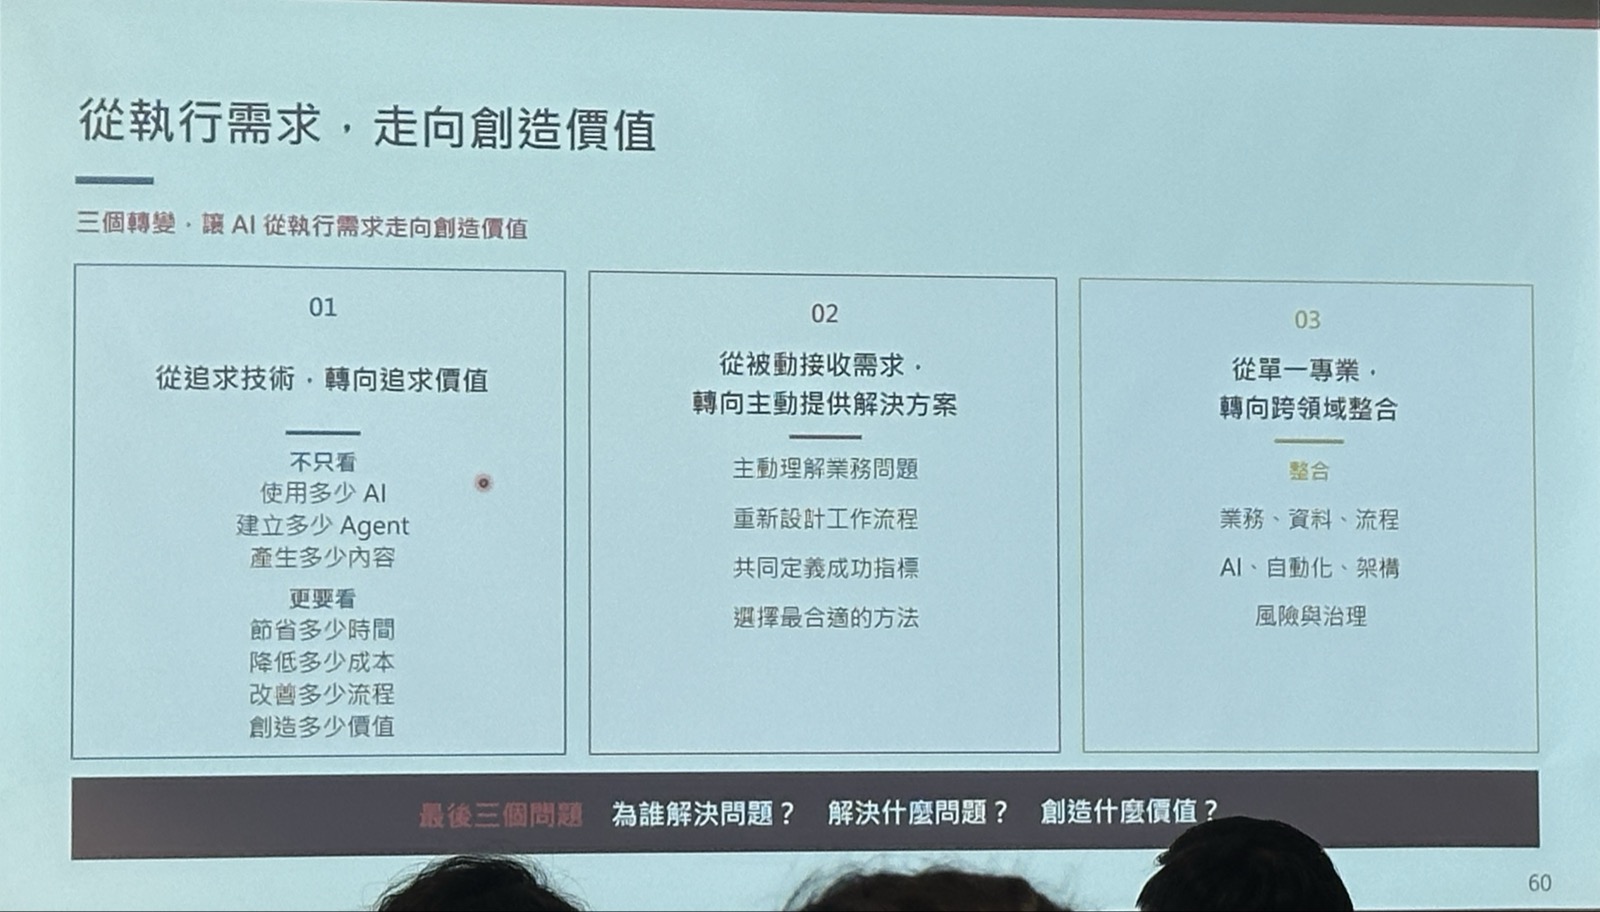
Edward Kuo說明,今年下半年起,導入策略由先找AI,改為先辨識企業實際問題,再透過PoC驗證效益。評估不只看開發投入,也須考量整體成本;推進依據應是能否改善工作,而非採用了多少新技術。
隨著AI應用增加,錯誤也逐漸削弱員工與各部門的信任。因此,負責任的AI與治理不只是技術配套,更是組織願意持續採用的必要條件。
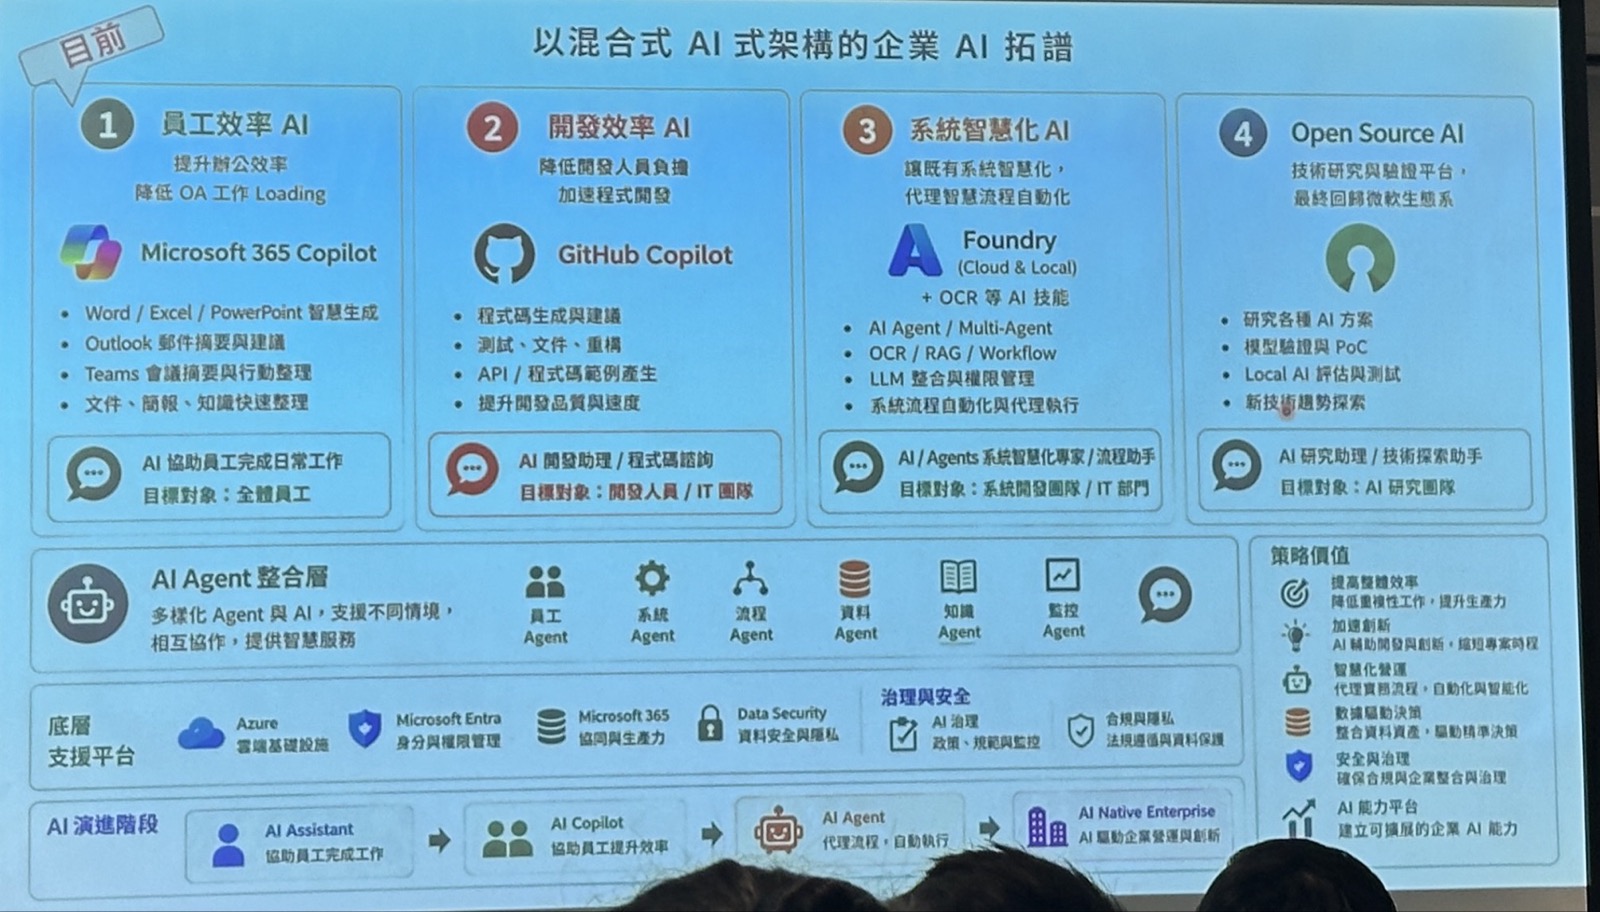
- 員工效率:使用O36,支援搜尋需要控制的文件。
- 開發協助:以GitHub Copilot協助開發者工作。
- 部門應用:針對部門需求自行開發AI,而非以單一工具涵蓋所有工作。
- 技術驗證:設置研究單位,驗證Open Source提供的技術與產品,再評估企業應用。
- 整合治理:設置AI Agent整合層,並將治理納入架構,不能只是部署Agent後便放任運作。
內部自建對話工具的經驗也顯示,資安限制與產品價值必須共同考量。當使用體驗不如外部服務,員工仍可能轉向外部工具;即使因資安考量封鎖外部服務,也不代表內部工具自然會獲得認同。AI應用不必侷限於對話介面,也可以融入既有系統與專業工作,重點是實際改善使用者的工作。
人才培養則應從「會下Prompt」進一步走向與AI共同思考。Edward Kuo鼓勵員工將AI視為consultant,透過問答理解原本不熟悉的知識,例如學習Python,或討論程式開發中的記憶體管理問題。重點不是直接接受產出,而是在互動中提升判斷與解決問題的能力。
「你不要只是會下一個Prompt」
— Edward Kuo
對工程師而言,AI的價值不只是代為產生程式,也在於協助釐清問題、討論解法與補足能力。持續學習並提升自身價值,比單純取得答案更能形成長期效益。
整體結論是:AI是工具,而非策略本身。應自動化的工作先自動化,需要AI的場景再導入AI;最終仍以能否節省他人的工作時間、降低成本及提升業務價值判斷成效。真正的競爭力在於理解問題、掌握業務並持續學習,而不是使用最多或最強的模型。