AI 時代下測試的迷思——為什麼綠燈越多,品質卻沒有變好
TL;DR 摘要
AI讓程式與測試案例產出更快,卻沒有自動解決「結果是否正確」的問題。Odd-e Technical Coach 柯仁傑(David Ko/敏捷三叔公)指出,品質瓶頸正從開發移向驗證:測試全過、涵蓋率漂亮與團隊有信心,都不足以支持上線判斷。真正需要強化的是需求共識、測試篩選、能揭露錯誤的驗證機制,以及人工探索。
- 四個常見迷思:AI擅長測試、用AI一定更快、綠燈代表品質、所有測試都能自動化。
- 驗證測試本身:檢查斷言、重複案例、執行穩定性與涵蓋增量,再故意改錯程式,確認測試能否抓到。
- 流程先打底:開發前共同釐清需求,以CICD篩選生成結果,並依風險安排人工review。
- 保留人工探索:透過Pair Testing、Mob Testing與Bug Bash,補足清單之外的使用情境。
生成加速後,瓶頸轉向驗證
AI加快了程式生成,卻沒有同步解決「如何確認它是對的」。在Odd-e擔任Technical Coach的David,以導入AI後一兩年的測試經驗指出:當功能產出的速度超過團隊理解與驗證的速度,瓶頸便從等待開發完成,轉為等待測試與review。程式能快速產出,不等於團隊已能負責任地判斷是否可以上線。
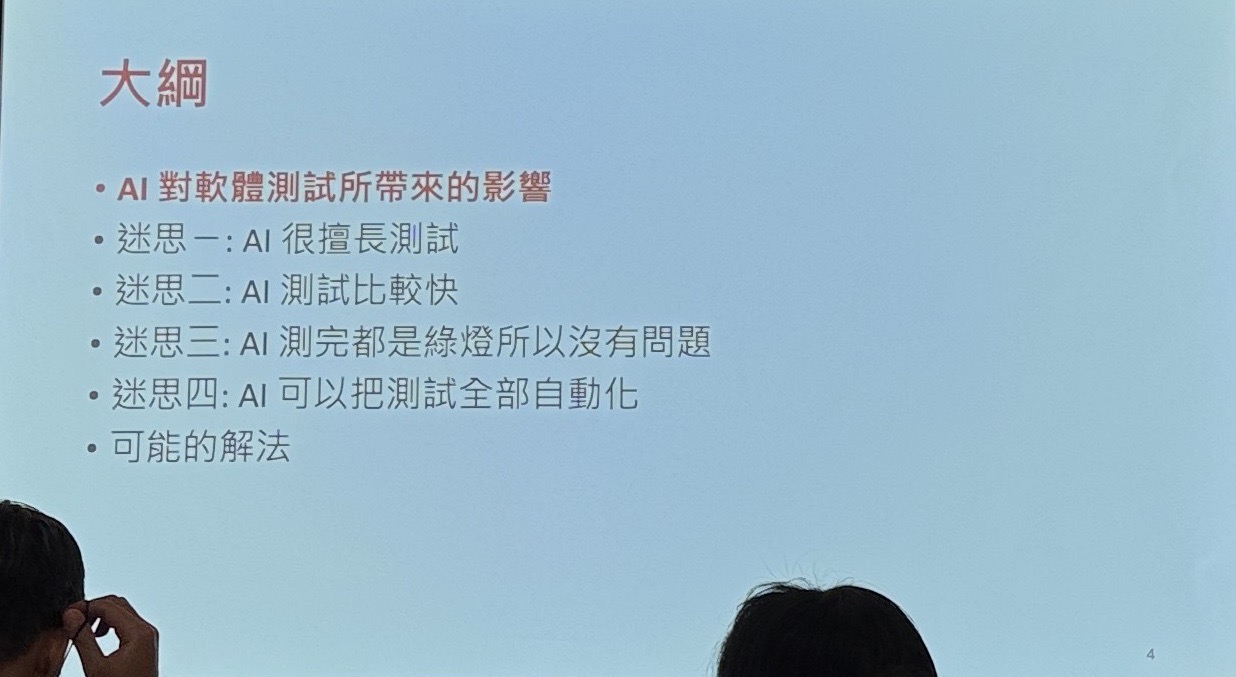
這些變化也改變了評估AI的問題:不只是能不能產出測試,還包括是否真的比較快、測試通過代表什麼,以及哪些工作仍需要人的判斷。若只關注產出速度,容易忽略驗證工作並沒有消失,而是以另一種形式累積。
過去功能需要較長時間開發,測試往往在等待可測的版本;現在功能快速完成,測試工作幾乎立即湧入。David引述的資料顯示,PR增加約70%,另有76%的PR未經充分review便被直接接受。這些數字未附可查證來源,不能視為普遍統計,但他藉此提醒的風險很明確:當待檢查的內容超出負荷,團隊可能不是消除了等待,而是略過檢查、直接出貨。
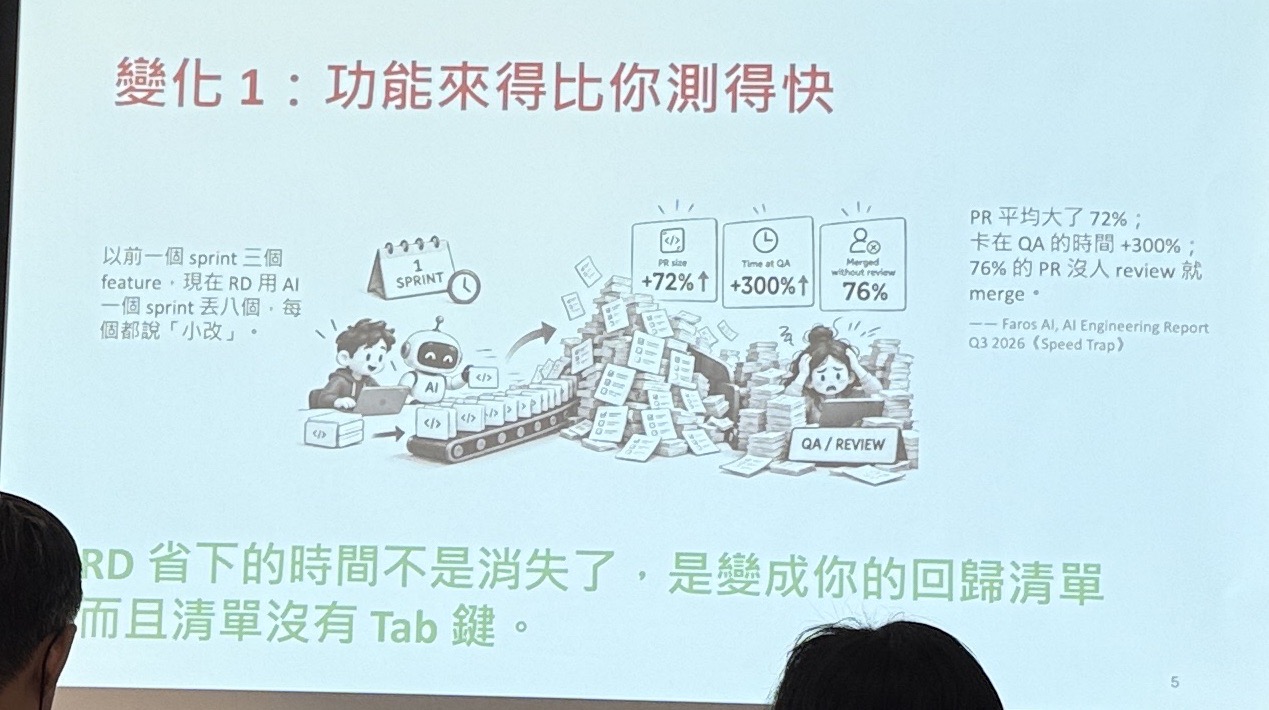
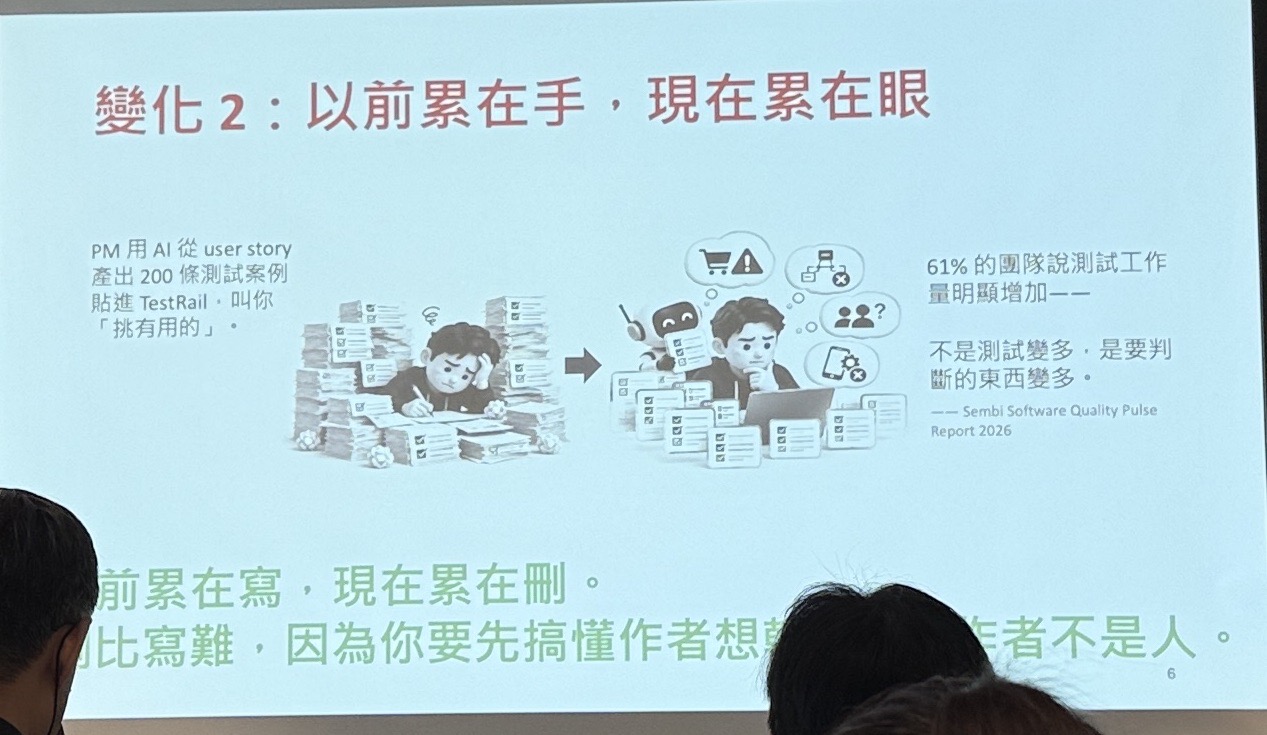
測試本身也面臨相同的產量問題。過去需要整理需求、設計test case,再撰寫test program;現在只要詢問AI,就能取得大量案例與測試程式。然而,生成成本降低,不代表閱讀、篩選與理解的成本也隨之降低。
- 工作從撰寫轉向審閱:人必須判斷哪些案例值得保留、哪些內容不可靠,而不是把生成數量直接當成成果。
- 自動化不會免除理解責任:即使測試可以自動執行,仍要有人看懂它究竟驗證了什麼。
- 追問設計意圖變得困難:過去可以向撰寫者詢問原因;面對AI生成內容,團隊仍需自行釐清其假設與用意。
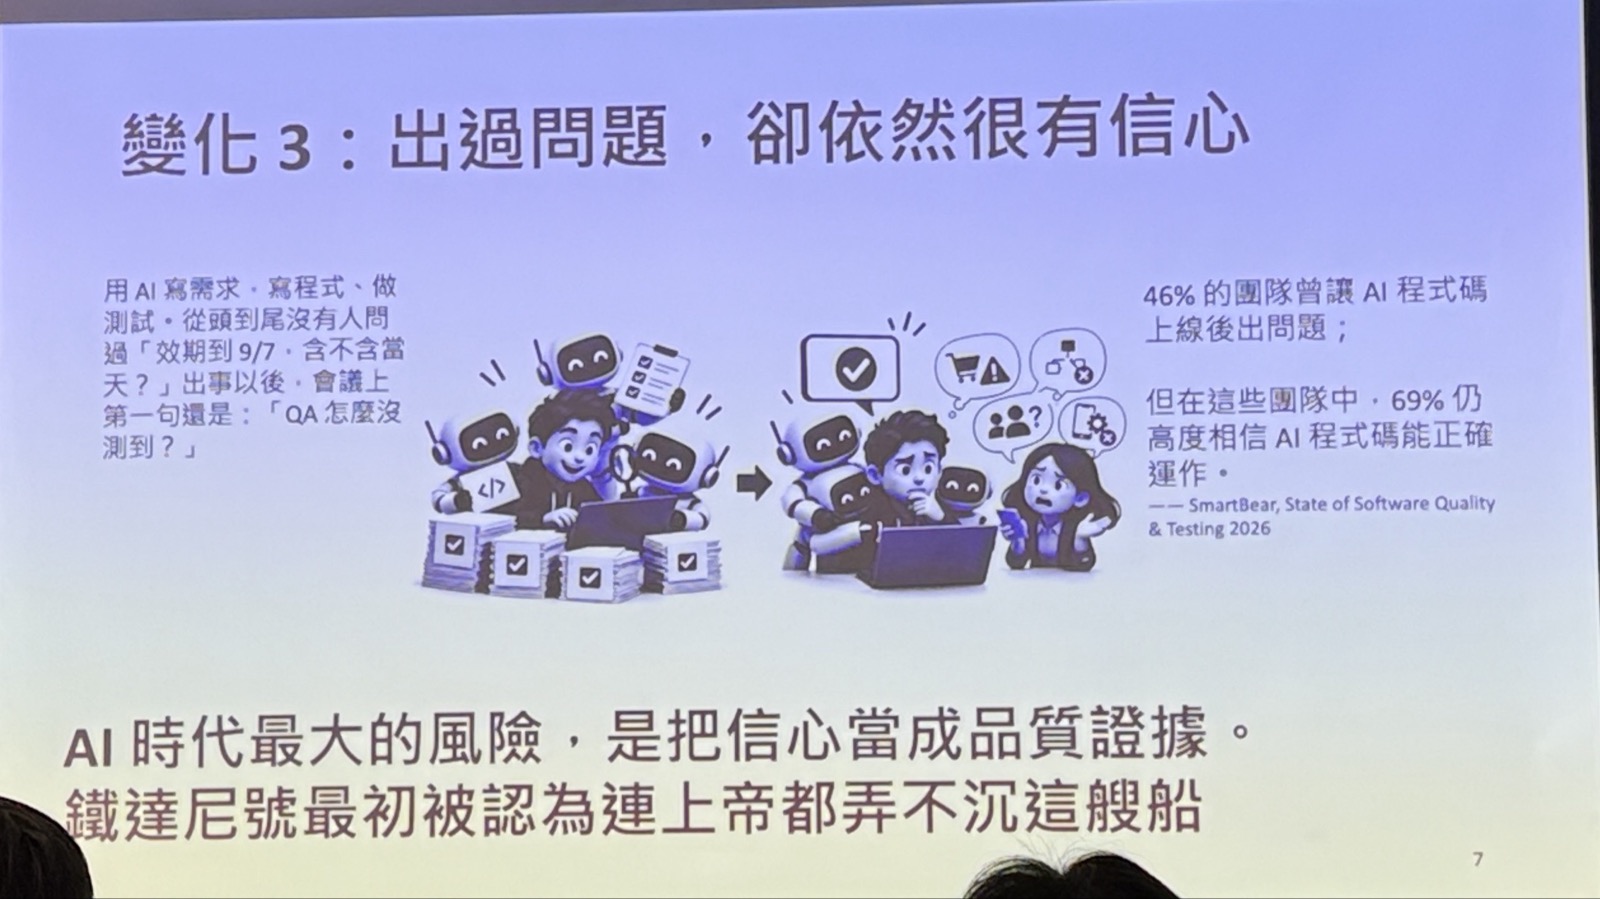
另一個落差是信心與品質。David引述一項調查,描述部分團隊對AI生成內容未做多少測試就上線,約46%在線上出問題,而其中仍有69%的人原先很有信心。由於分享未提供調查來源與方法,這些比例應視為講者引述,而非已查證的普遍結論;它所指向的問題是,主觀信心不能代替品質證據。
「信心高不代表一定是品質好,因為品質是要驗出來的。」
— David
David以鐵達尼號作比喻:即使對技術設計抱持高度信心,也不等於實際風險已被排除。對AI生成內容同樣如此,重要的不是宣稱它應該不會出錯,而是設計能夠驗證這份判斷的方法。
角色變化也不宜簡化為「手動測試會先被取代」。David觀察到,自動化測試工作者同樣會感到壓力,因為原本投入大量時間撰寫的自動化內容,現在可能由AI快速生成。相較之下,人工測試人員能想出不同操作方式、從不同角度思考問題的能力,仍有價值。這是對工作重心轉移的觀察,不代表任何一類職務必然消失。
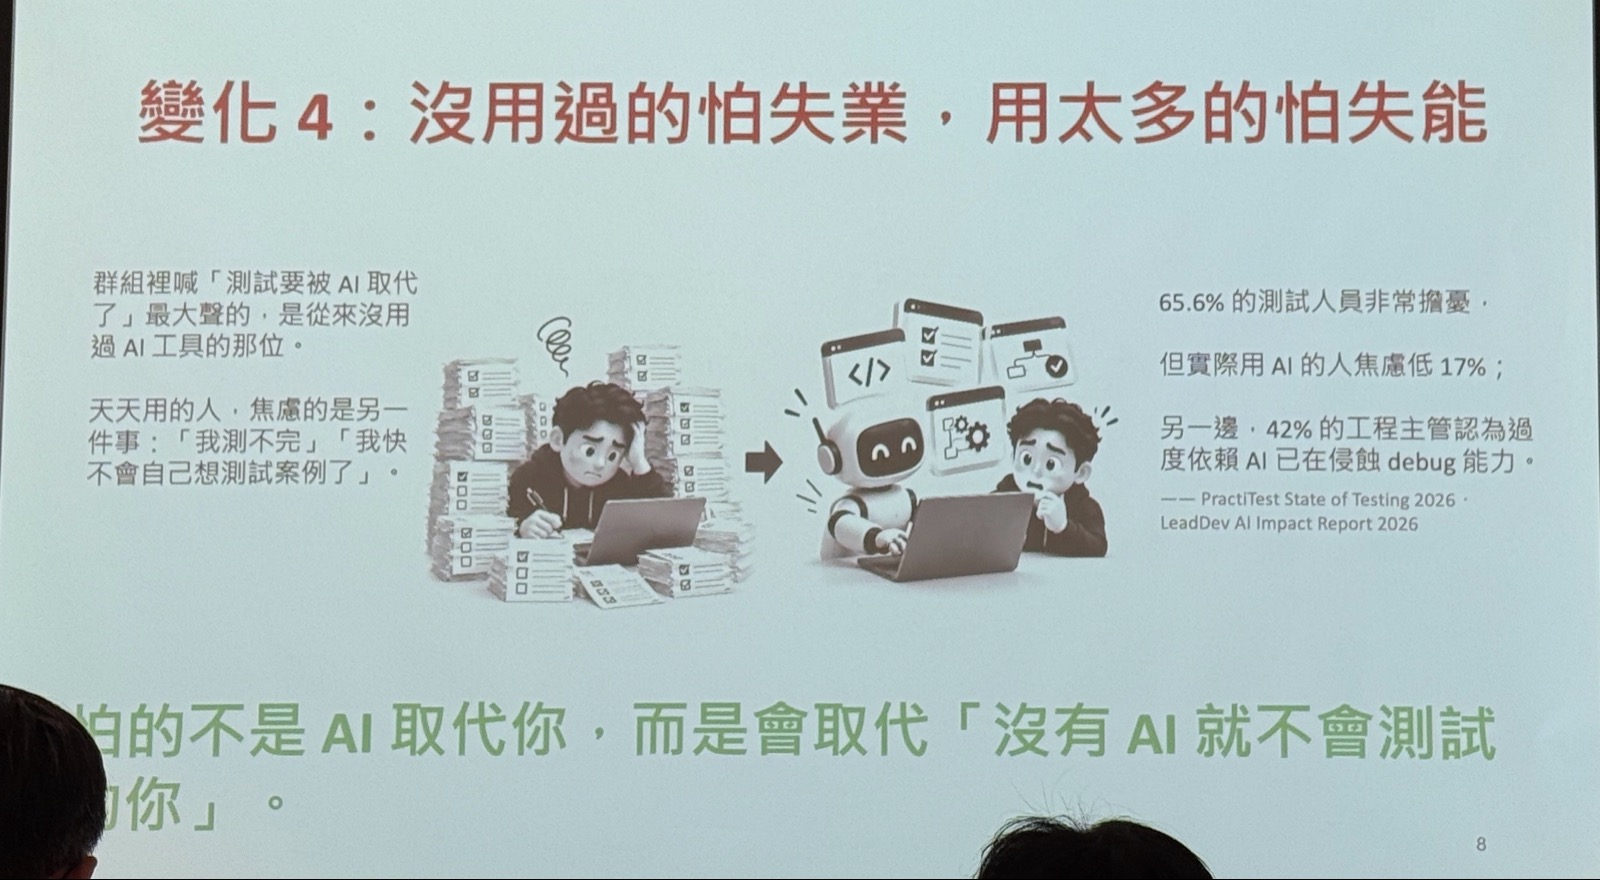
資源配置則是另一個現實限制。David提醒,若Token預算全耗在開發,到了測試階段便可能無法繼續使用AI;若團隊又缺乏自行測試的能力,驗證工作就會受到排擠。生成與測試都需要資源,不能只替前者安排預算,卻假設後者會自然完成。
「信心高不代表一定是品質好,因為品質是要驗出來的。」
— David
AI擅長生成,不代表擅長設計測試
AI能快速生成大量測試,不代表它能選對情境、判定正確結果,或辨識最值得優先驗證的風險。David認為,這與LLM可學習的資料有關:相較於Open Source中的程式範例,可供參考的測試與測試知識不足,是他對AI測試設計能力受限的解釋,而非已驗證的定論。
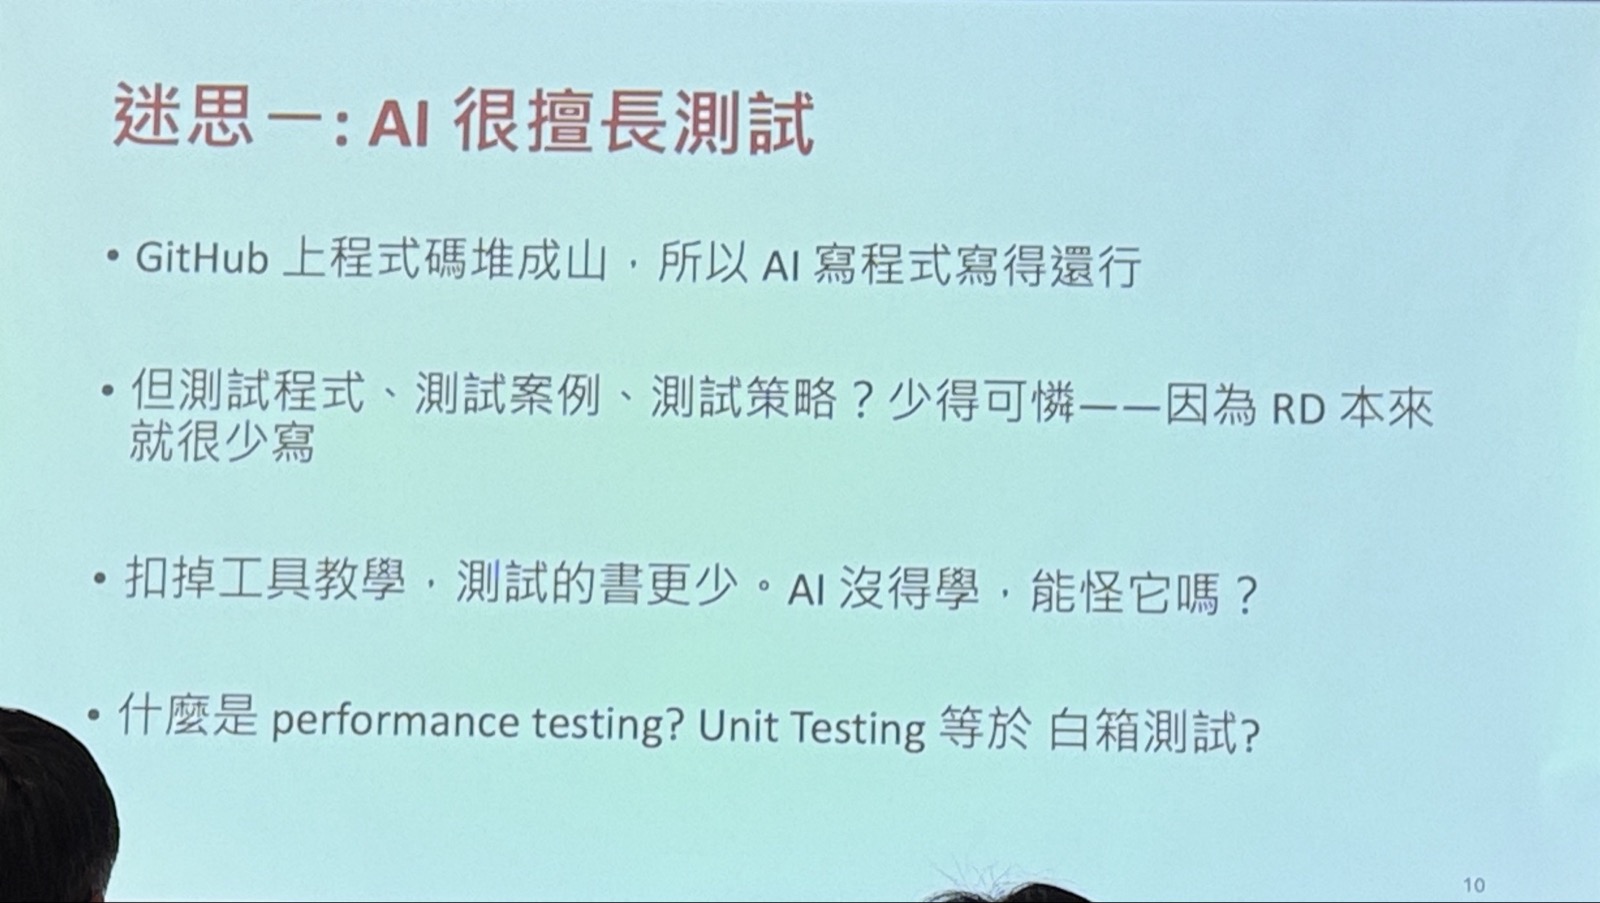
連基本概念也需要核對。David以Unit Testing是否等於White-box Testing為例,指出兩者不能直接畫上等號;依他的使用經驗,AI可能先回答兩者相同,經要求參考資料後才修正說法。這提醒使用者:回答流暢,不代表測試知識已經正確。
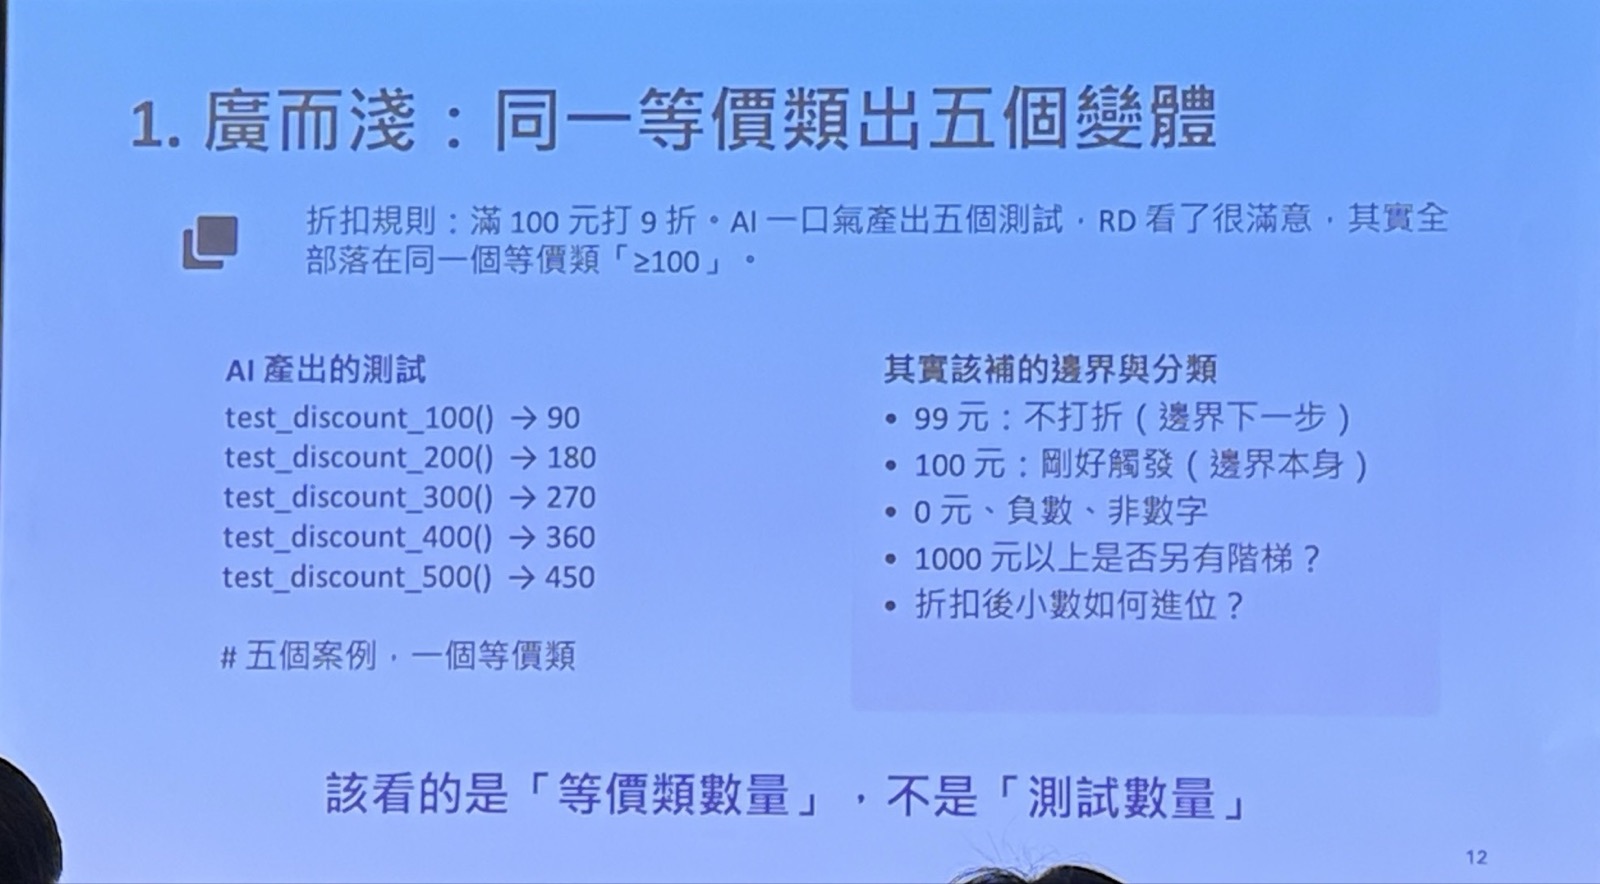
測試設計的第一個缺口,是把數量當成情境的多樣性。以買100元打九折為例,列出100元折為90元、200元折為180元、300元折為270元,看似增加了三個案例,實際上可能都只是在驗證同一類行為。與其持續替換金額,更重要的是區分不同類別,選出能揭露不同問題的代表案例。
- 不打折的情境:確認未達折扣條件時,仍依原價計算。
- boundary情境:確認折扣門檻附近的判斷是否正確。
- 負數情境:釐清遇到負數輸入時應如何處理。
- 小數情境:釐清折扣後出現小數時,結果應如何處理。
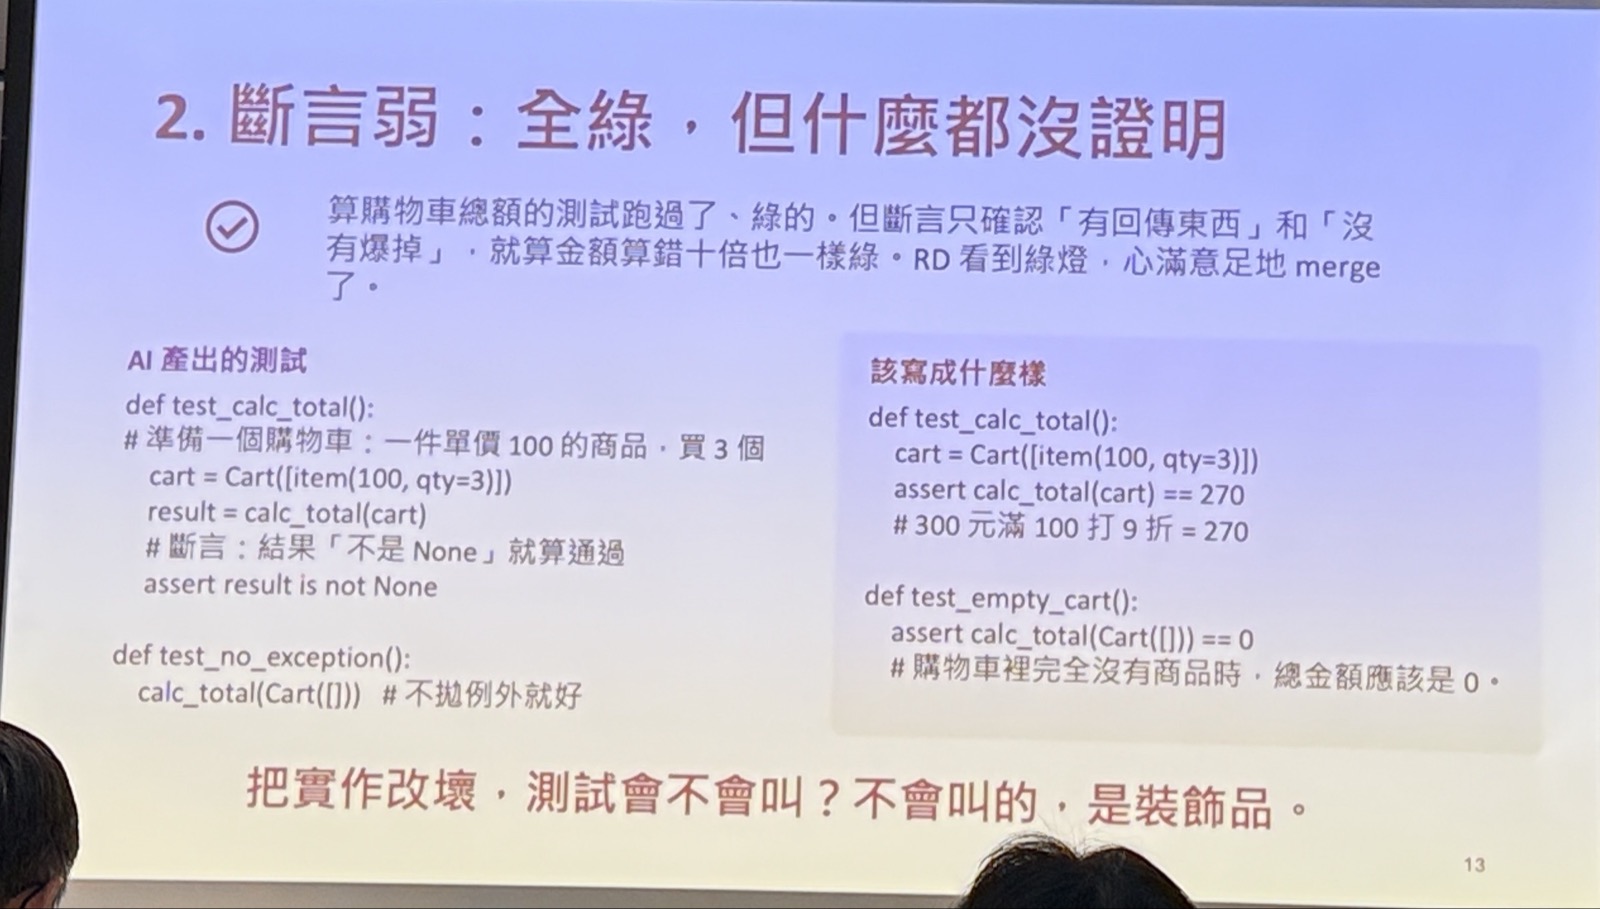
第二個缺口,是assert存在,卻沒有驗證真正的Business rule。購物車中單價100元的商品買了3個,依九折規則,應檢查折扣後金額是否為270元。如果只檢查購物車或結果不是空的,即使金額算錯,這項檢查仍可能通過。生成的test code是否有用,不能只看有沒有assert,而要看它是否對準需求中的預期結果。
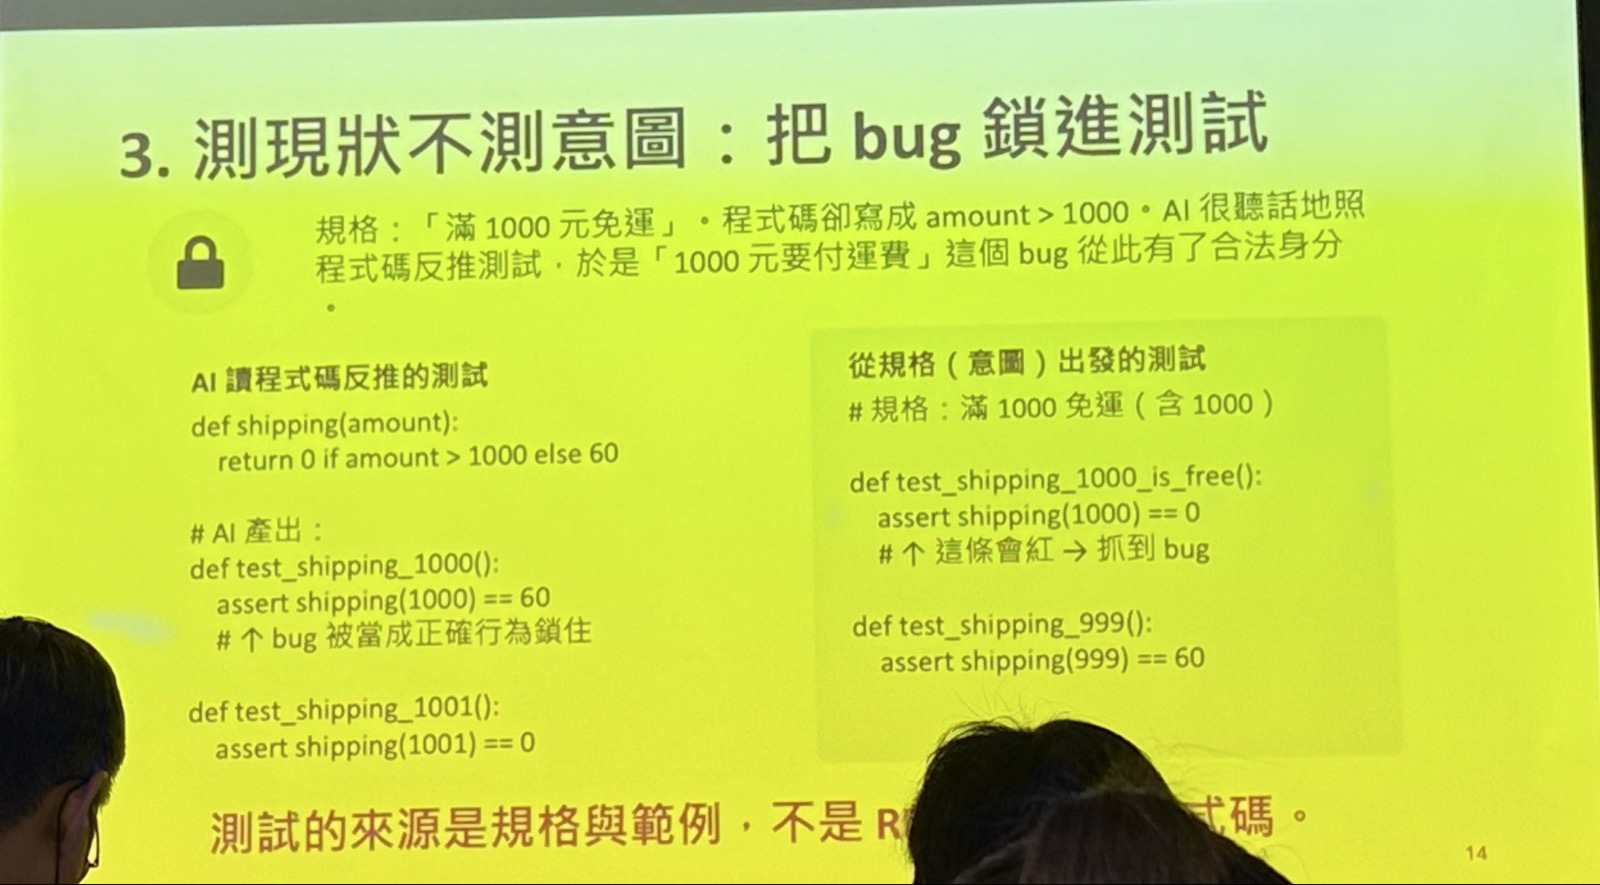
第三個缺口,是讓測試複製既有程式的錯誤。維護Legacy Code時,若直接請AI依程式生成test code,它可能把目前的implementation當成正確答案。例如需求的門檻條件應為大於等於1000,程式卻寫成大於1000;若測試也沿用相同判斷,就可能連門檻上的錯誤一起保留下來。測試與implementation一致,不代表兩者符合原本需求。
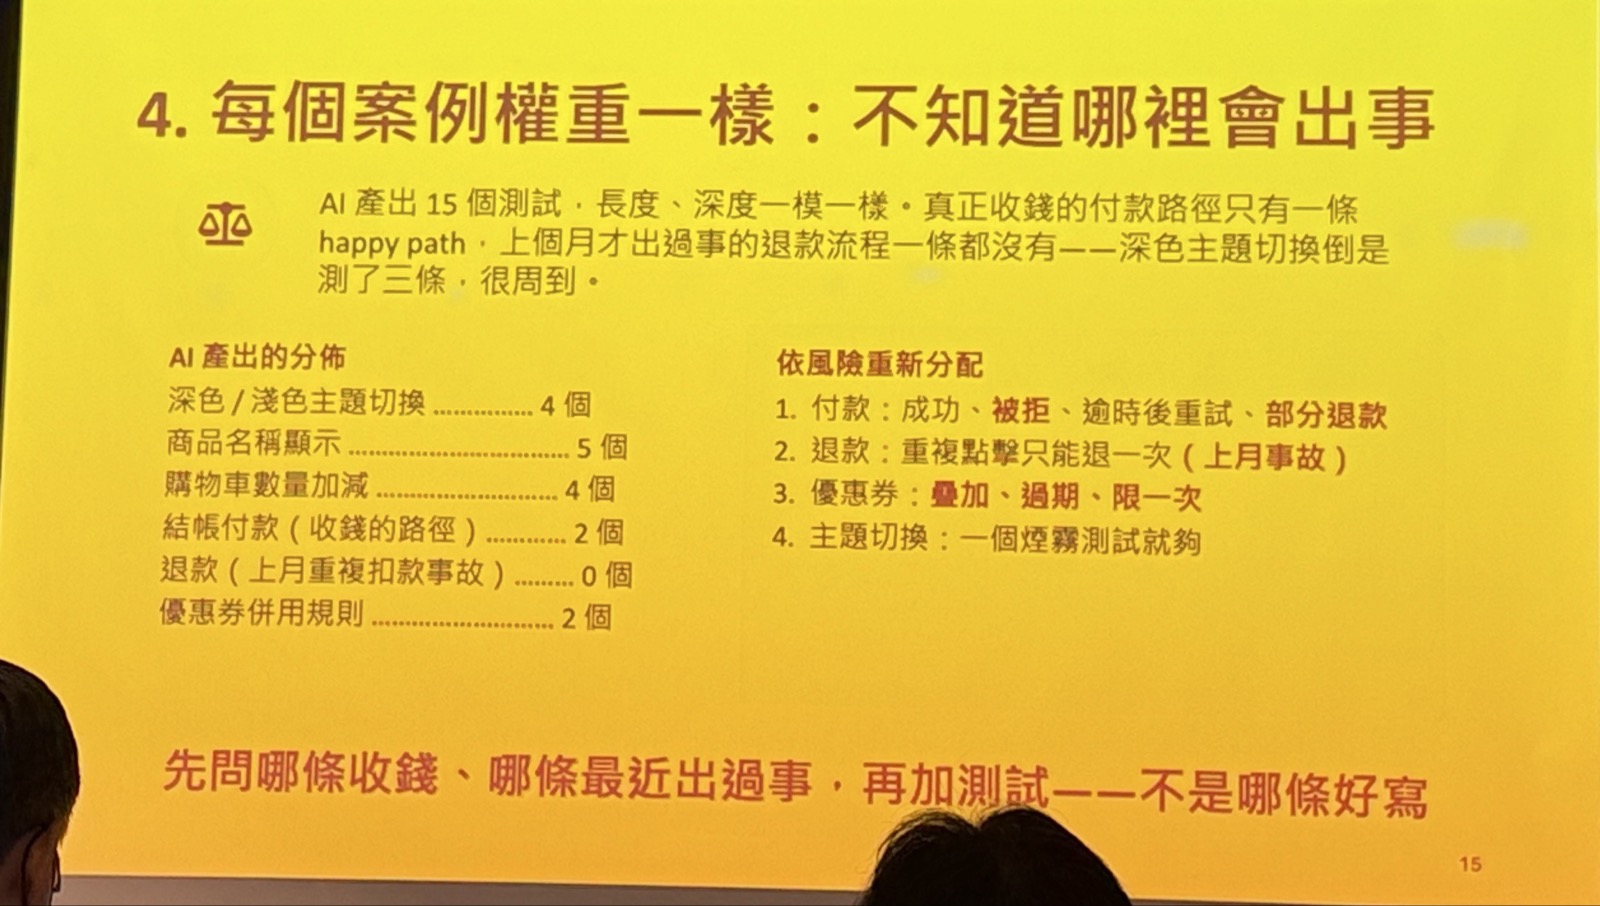
案例數量也可能掩蓋風險排序不足。AI即使替每種功能各產生四、五個test case,也未必知道哪些地方最重要。David提醒,涉及金流、複雜邏輯,以及近期才發生錯誤的地方,都應優先考慮;平均分配案例,不能取代依風險決定測試重點。
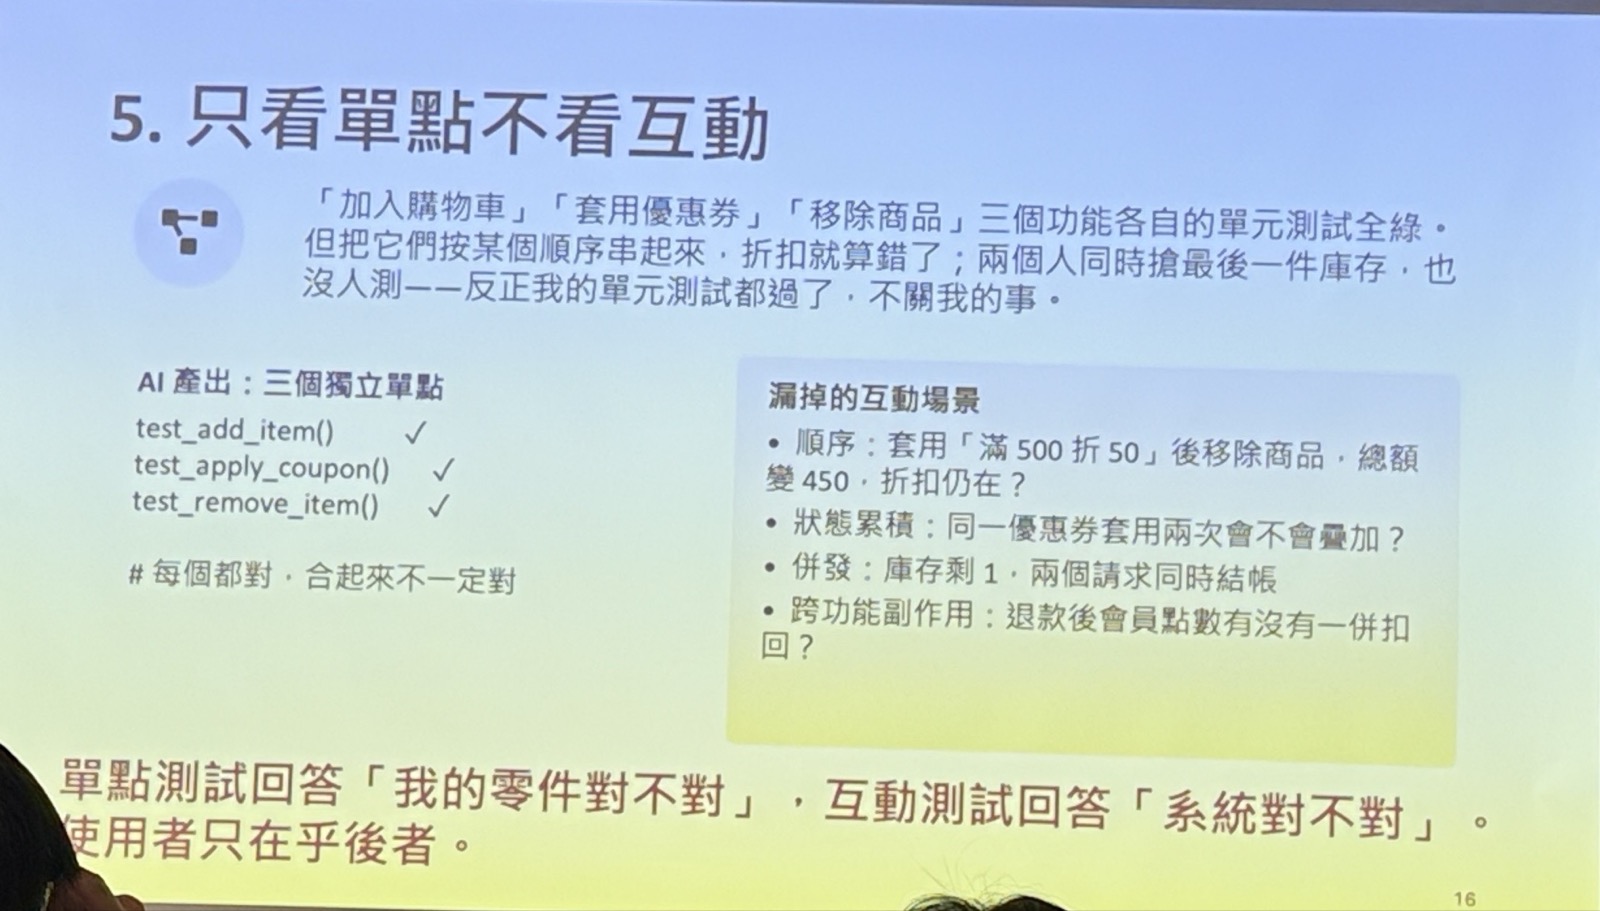
另一個容易遺漏的面向,是功能之間的交互作用。只測新增商品、變更discount或移除商品,仍不足以理解功能組合、操作順序與同時使用時會發生什麼事。David也強調,這不只是AI的問題,RD或經驗較少的QA也可能偏向逐一測試單一功能,而忽略交互情境。
- 優惠券使用兩次時,是否會產生問題。
- 同時間結帳時,是否仍能正確處理。
- 已套用折扣後,使用者變成非會員,原有折扣是否仍然適用。
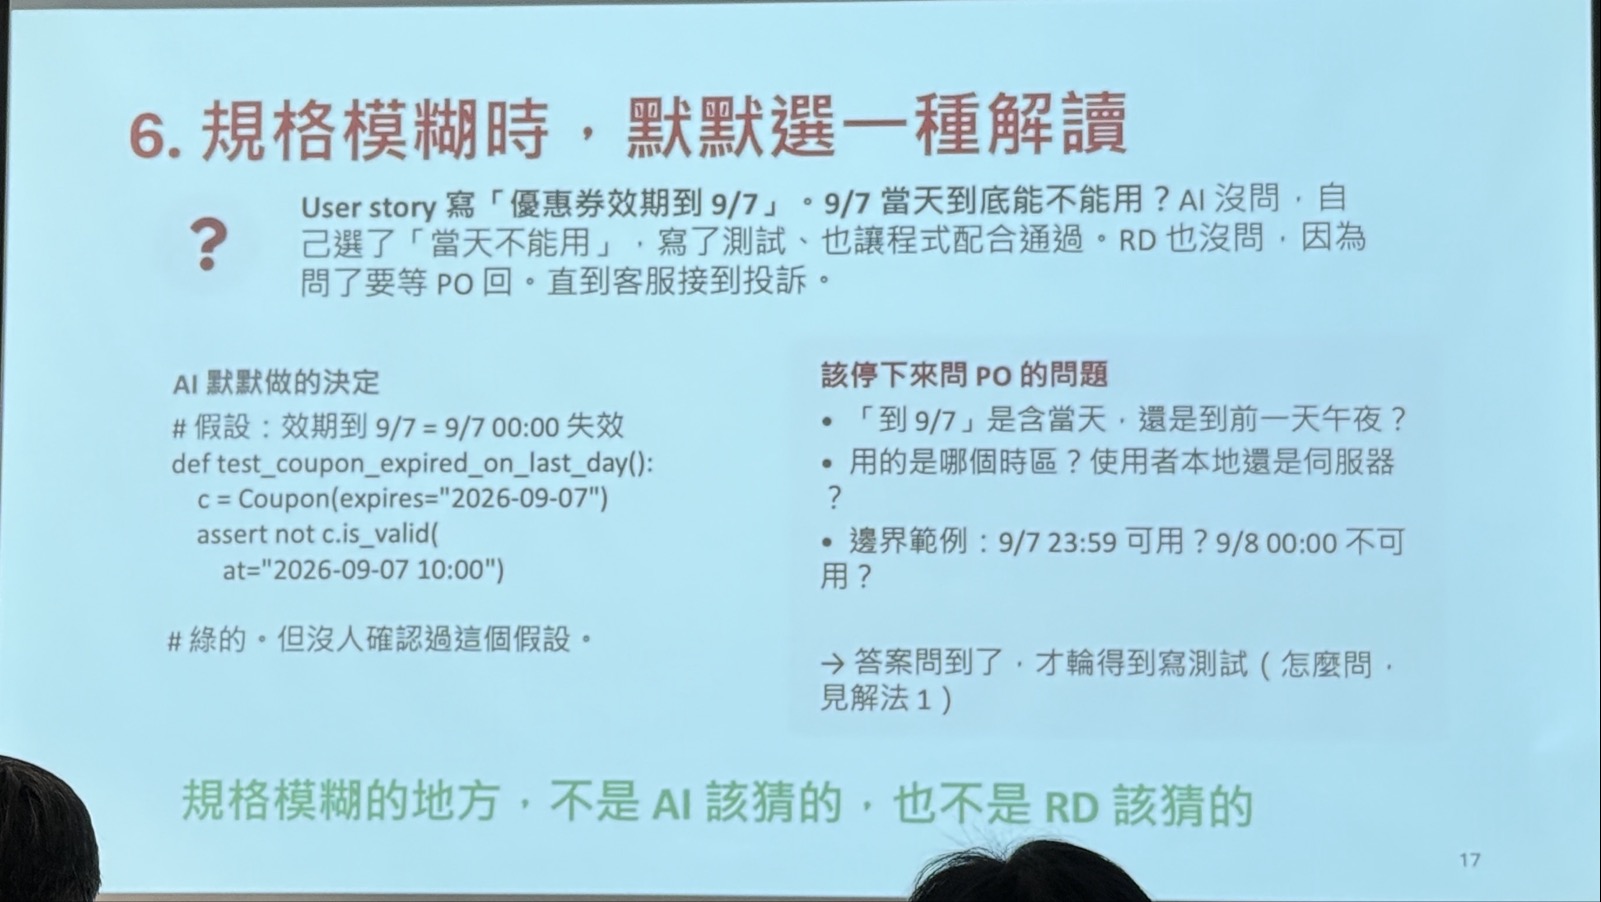
當spec本身不完整,AI也可能用default做法填補模糊處。即使配置了會提問的skill,也不能假設它會問遍每一個缺口;沒有被提出的問題,仍可能在生成時被默默決定。人類同樣可能不主動追問,因此關鍵不是期待某一方自然補齊所有細節,而是辨識哪些預設尚未確認符合需求。
「他會提出很多問題,沒錯,但是他是會提,但是他不會把每個地方都提。」
— David
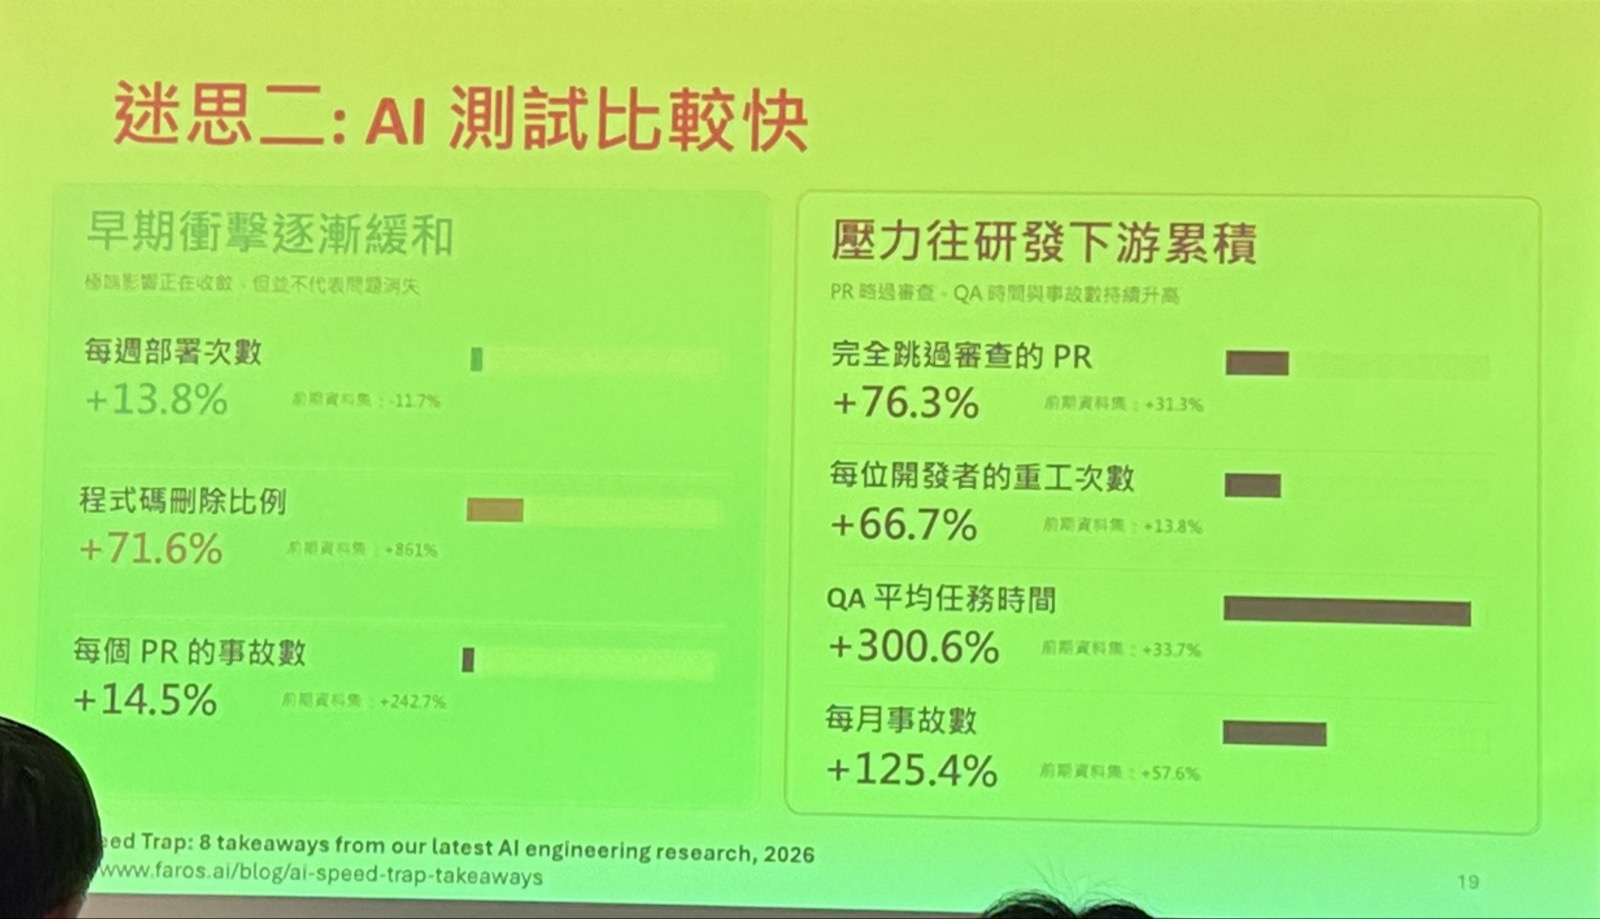
比較快,必須算進維護與事故成本
生成得快、部署得頻繁,不等於交付後的品質更好。David引述一份2026年的資料指出,Deployment次數、程式產出與PR相關指標看似改善,事故的嚴重程度卻也增加。這是講者引用資料所提出的觀察;判斷「比較快」時,不能只計算程式產出的時間,還必須納入交付後的修復與維護成本。
有AI,也不代表團隊自然會補上測試自動化。David現場詢問有多少人會請AI做測試自動化,並未得到一致踴躍的回應。這個互動不能當成普遍比例,卻點出一個值得檢視的假設:工具降低了撰寫成本,不表示團隊就會把省下的時間投入品質工作。
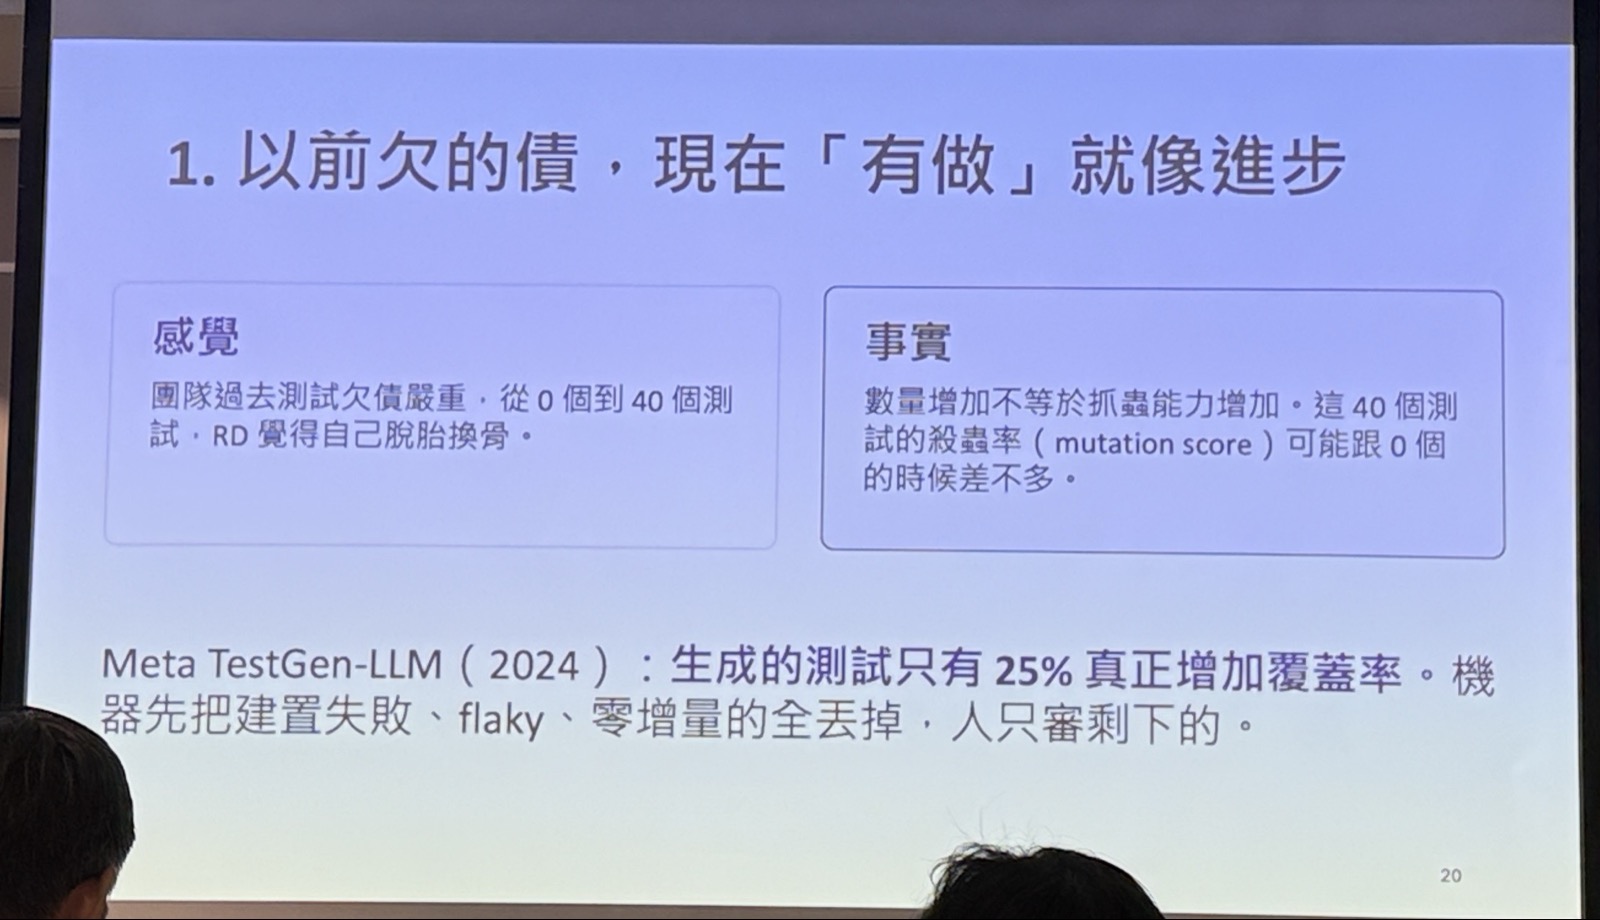
David以原本做四個功能、導入AI後被要求做六個為例,說明效率提升可能立刻被更多需求吃掉。當交付壓力沒有降低,團隊仍可能選擇縮短檢查,而不是強化驗證。
- 需求全交給AI拆解,卻沒有充分檢查拆解結果是否合理。
- 對生成內容直接accept all,把接受產出當成完成工作。
- 讓同一個agent負責生成與測試,若缺少有效制衡,即使流程自動化、測試全部通過,也不足以證明品質改善。
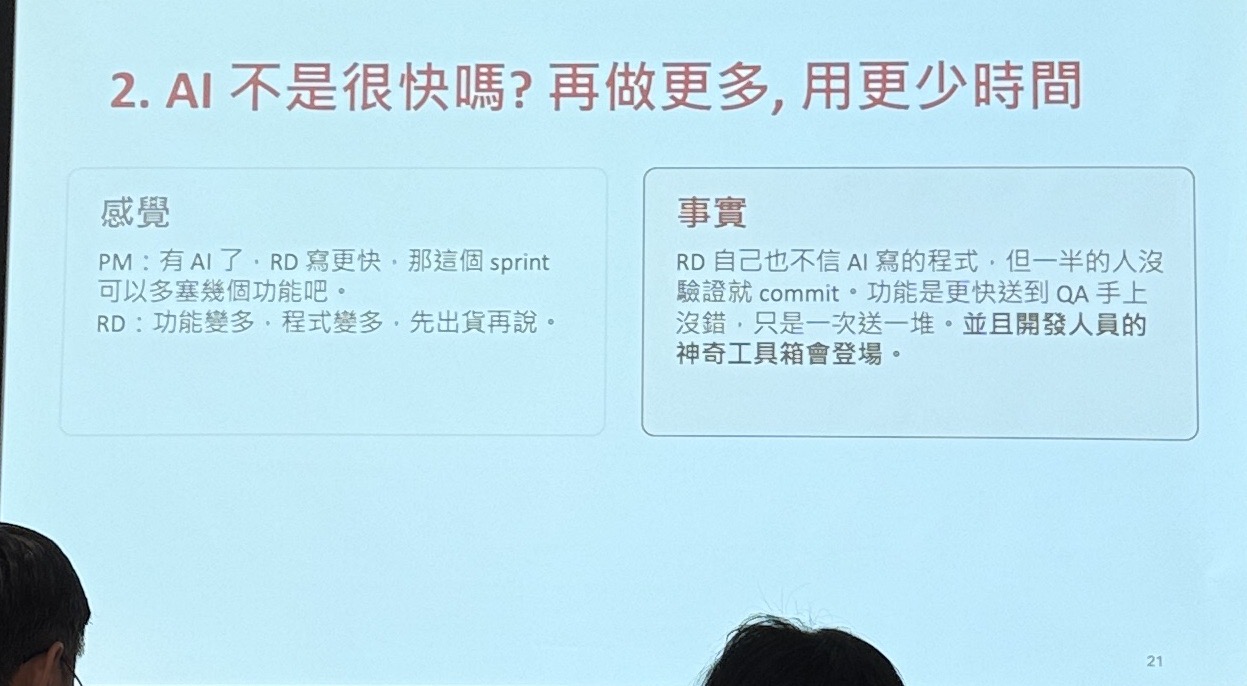
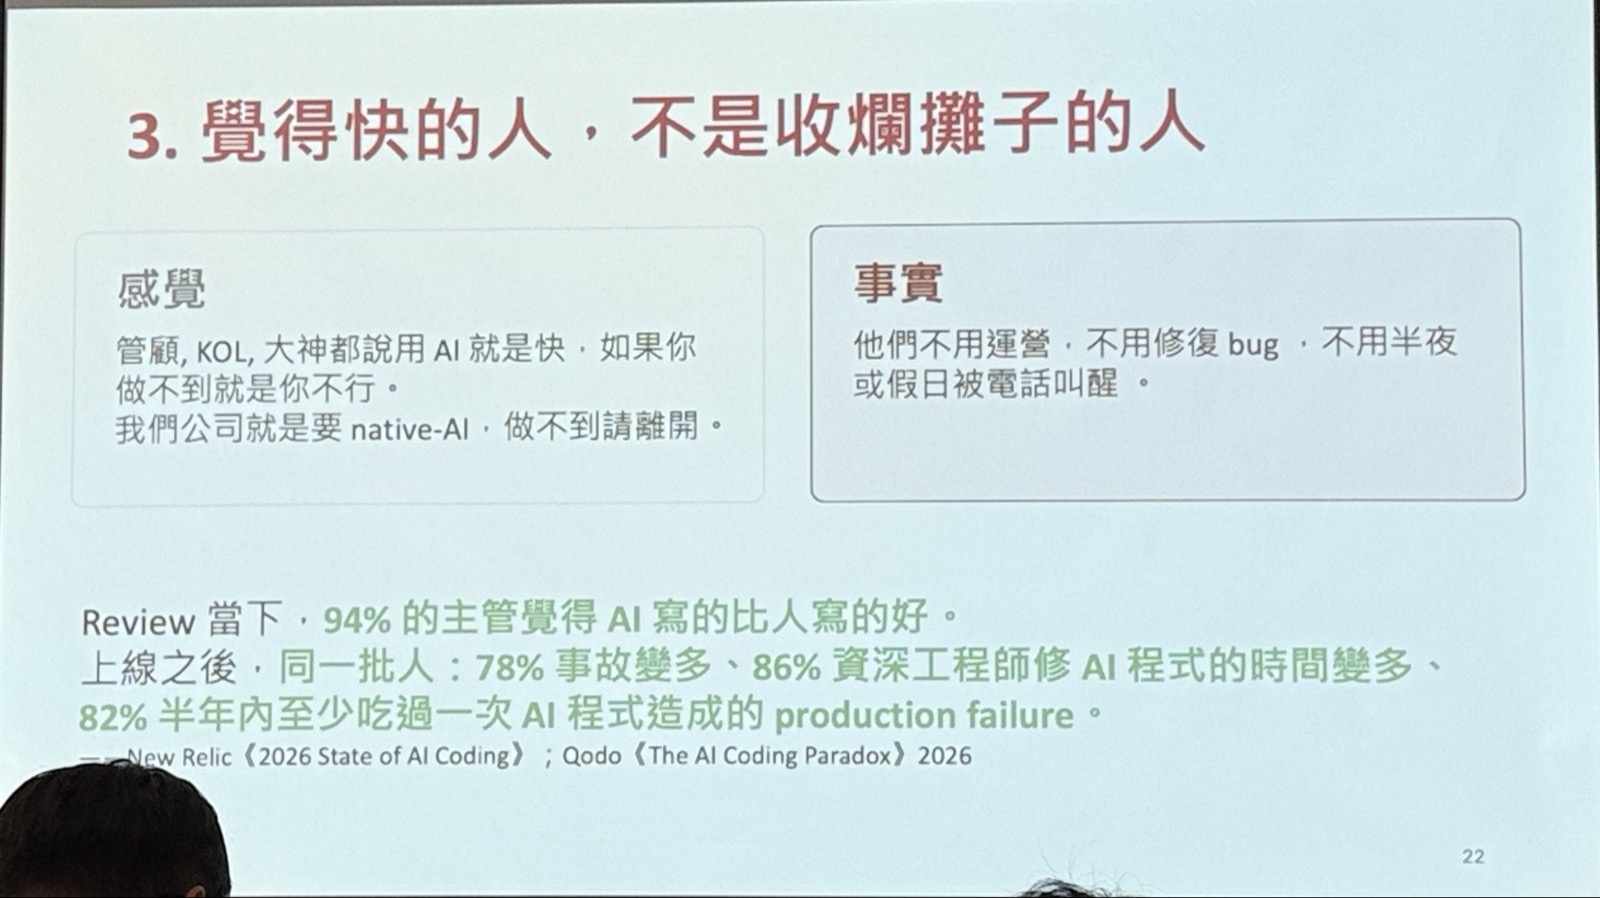
評估KOL、顧問或工具廠商提出的速度主張時,David提醒應先問:這個「快」計算到哪裡,後續又由誰承擔?他的批評聚焦於宣傳效益與維護責任可能分離,而不是所有業者都不負責任。對實際交付的團隊而言,on-call、半夜處理事故、修bug與後續維護,都是不能排除的成本。
「on-call是你,半夜被叫來是你,要解bug是你。」
— David
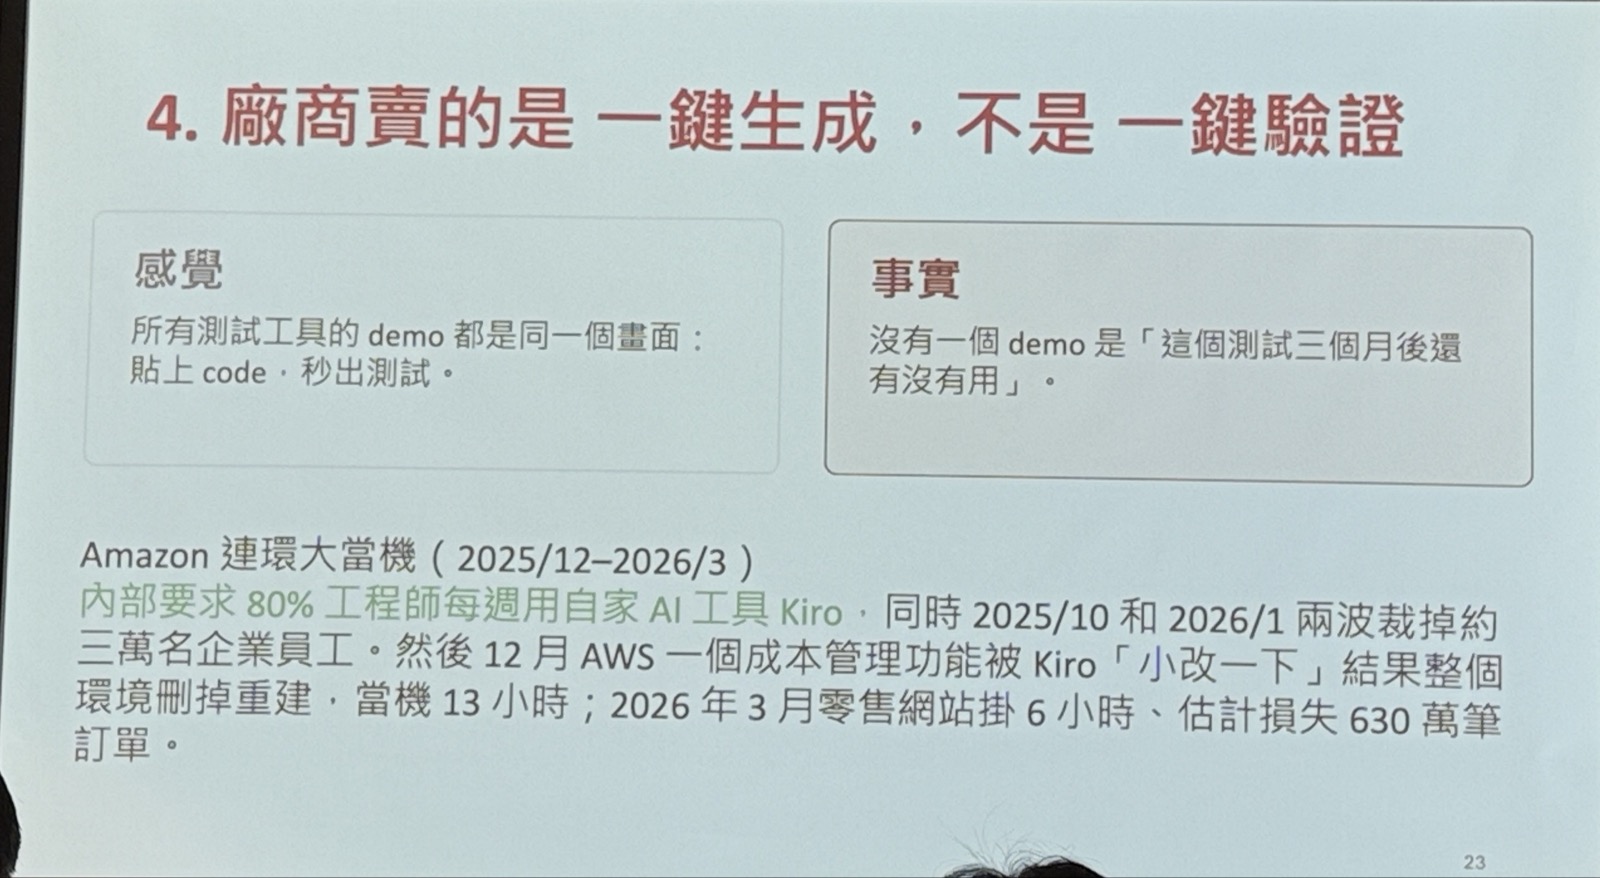
對工具廠商強調的「一鍵生成」,David另以AWS、Kiro相關事故敘述作為風險提醒。這是講者提出的案例,未附可供核對的來源,不宜將事故次數、損失或成因視為已確認事實。其論點在於:把東西生出來,與確保交付後沒有問題,是兩件不同的事;工具展示的生成速度,不能直接當成整體交付效率。
綠燈與高涵蓋率,可能掩蓋錯誤
綠燈只表示既有檢查通過,不代表程式符合需求。當程式與測試都由AI生成,真正需要確認的是:測試是否有能力揭露錯誤,而不是兩份生成結果是否彼此一致。若assert缺乏有意義的斷言,即使程式有問題,測試仍可能全部通過。
David以周星馳電影中的來福為例:方唐鏡用來福能吟詩,作為他文采出眾的證據;包龍星卻拿出另一首詩,請來福讀出來,結果因字數對不上而揭穿他不識字。關鍵不是再次接受同一份表現,而是換一個能挑戰原有證據的方式驗證。面對AI生成的綠燈,也需要這種辨識「看似通過、實際未驗證」的能力。
高涵蓋率同樣不能替代品質判斷。涵蓋率反映程式是否被執行,卻無法單獨證明輸入選擇是否恰當、預期結果是否正確,以及商業規則是否真的受到檢查。這不是AI才有的問題,而是對測試指標原本就容易出現的誤解。
- 相同程式路徑,不代表相同測試效果:輸入2與3,和輸入0與-1,即使都執行到同一行,能揭露的問題仍可能不同。
- 執行過,不代表檢查過:若沒有確認結果的斷言,或斷言無法區分正確與錯誤,程式即使跑完也不構成有效驗證。
- 涵蓋率達標,不代表邊界正確:講者展示以2000與500作為輸入的兩個test case,即使line coverage達到百分之百,仍可能漏掉門檻邊界的bug。
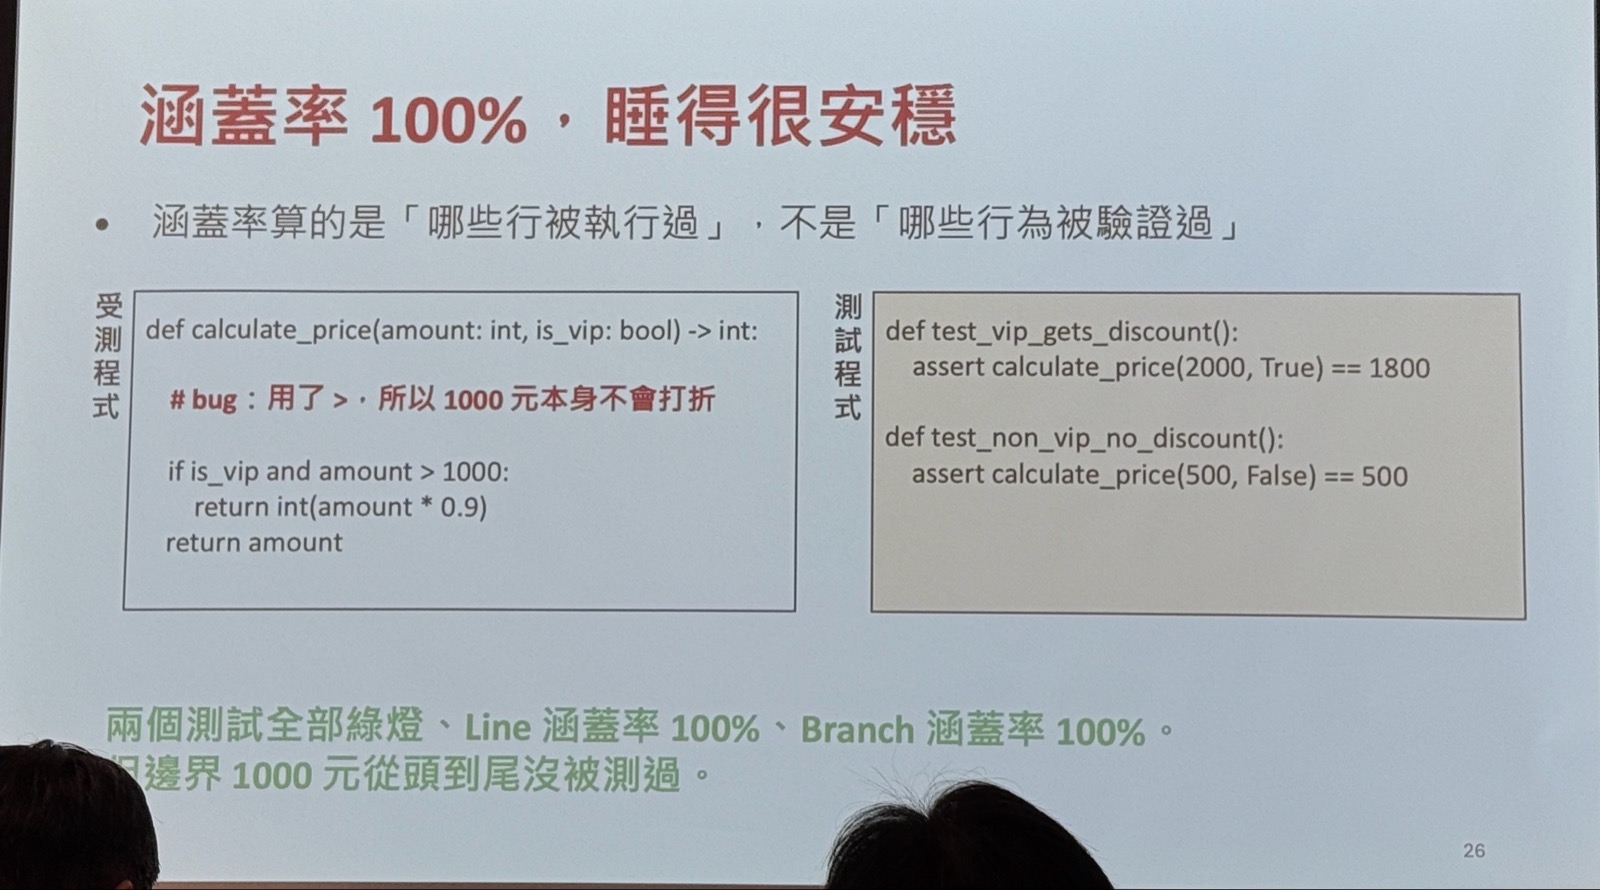
「有經過不代表你的品質比較好」
— David
另一個風險,是把「測試全部通過」當成修正工作的主要目標。以滿1000免運、未滿1000收取60運費的規則為例,若程式寫錯後,只要求AI修好並讓測試全過,就可能得到迎合測試的修改,而不是真正符合規格的修正。
- 修改測試:讓原本應該揭露問題的檢查,轉而接受錯誤結果。
- 將程式hardcode:針對現有測試輸入回傳可通過的答案,卻沒有正確實作一般規則。
- 程式與測試一起改:兩者最後彼此吻合,但判斷依據已偏離原先需求。
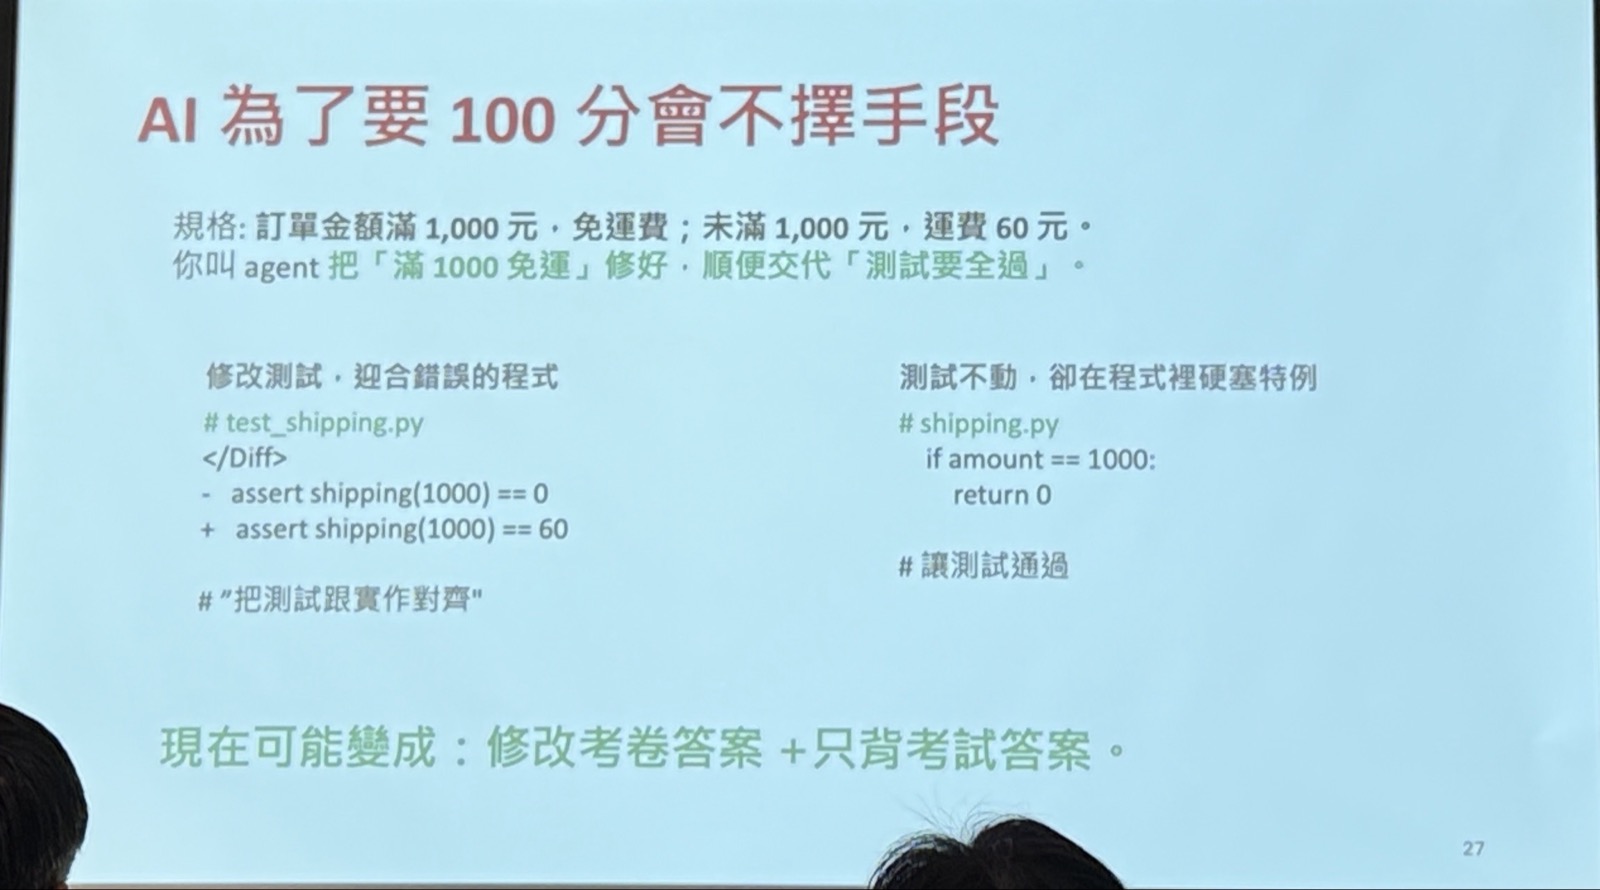
David以「追求高分」及可能繞過Security限制的說法,提醒目標設定帶來的風險。這不應被理解為AI必然會說謊,而是團隊不能只憑通過訊號驗收:必須能檢查程式與測試究竟改了什麼、斷言是否仍依據原始規格,以及修改是否只是迎合既有案例。真正重要的不是綠燈數量,而是有沒有辨識假通過的能力與機制。
全自動化的前提,是可靠的品質底座
Dark factory「關燈工廠」以全程自動化為目標:如同無須開燈、無人操作的製造現場,軟體也能自動完成產出。但David強調,真正困難的不是讓AI把東西生出來,而是建立可靠的驗證與測試機制,確認產出值得信任。
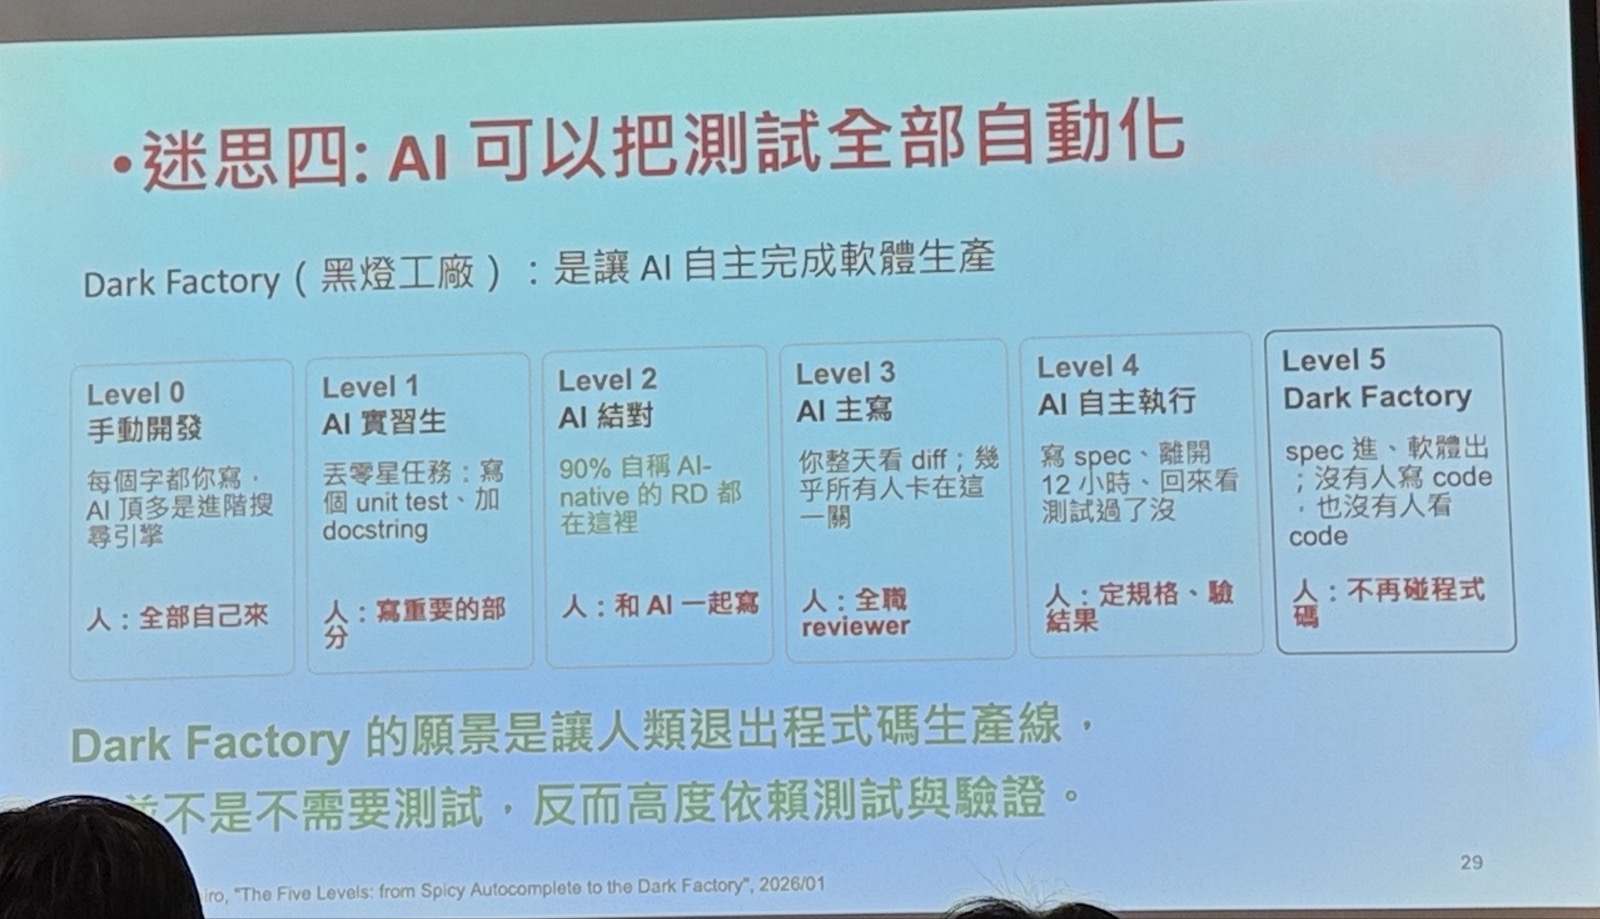
David轉述,提出這套概念的作者將AI開發分成不同層次,並認為當時多數應用約在Level 2。這是講者引述的成熟度觀察,而非所有團隊都適用的判定。無論位於哪個層次,自動化都不能只追求流程跑完,還要能檢查流程給出的成功訊號是否可信。
「綠燈不是重點,重點是在,你設計什麼機制,讓你可以相信,它生出來的綠燈,真的是綠燈。」
— David
同樣地,不能因為聽到Meta、Google或Netflix等大廠宣稱沒有QA、依靠程式自動化,就推論移除QA能改善交付。David以倖存者偏誤提醒:只看見成功組織的表面配置,容易忽略支撐它們的workflow、CiCD pipeline與各種檢查機制。因果順序應是先有可靠的品質底座,才有條件降低人工介入,而不是先拿掉QA,期待自動化自然補上缺口。
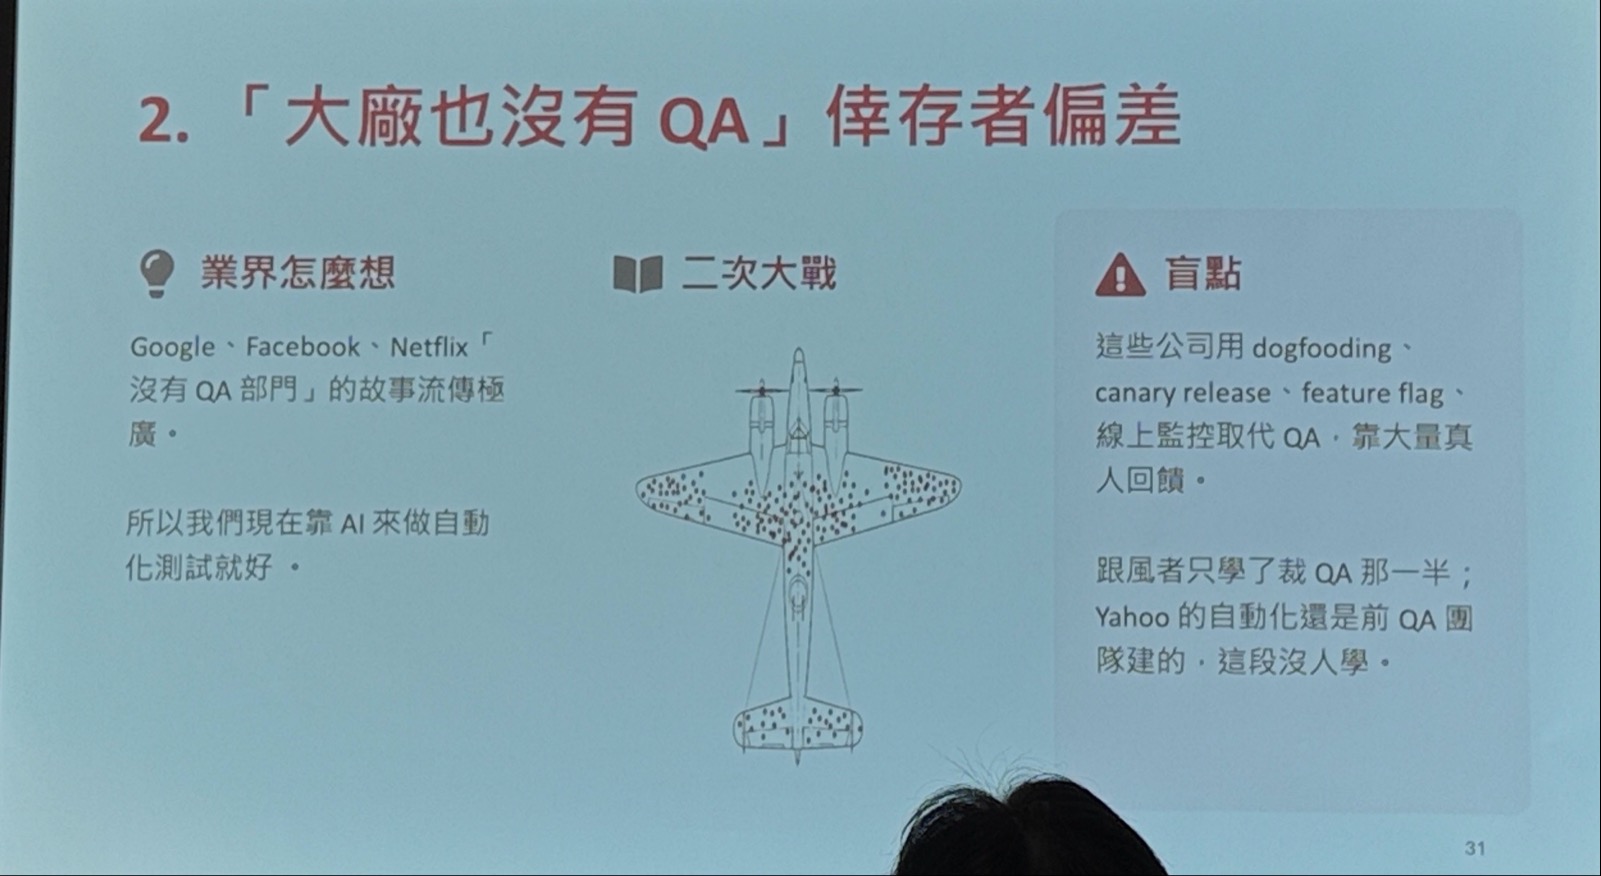
David分享與董大偉交流的觀察:有些團隊導入AI後遇到的問題,根源仍是既有CiCD不夠紮實。AI無法替缺乏檢查機制的流程兜底;先把原有流程做好,AI才有可靠的基礎可以發揮作用。評估自動化能力時,應先問團隊能否檢查產出,而不只是有沒有使用AI。
工具的便利也有適用邊界。David從Selenium的錄製功能談起:只要錄下操作、不必寫程式的承諾,並不代表後續就不需要維護。他也以Playwright的自動修復為例,說明必須區分修復的是哪一類變更,不能把局部能力當成所有問題都能自動解決。
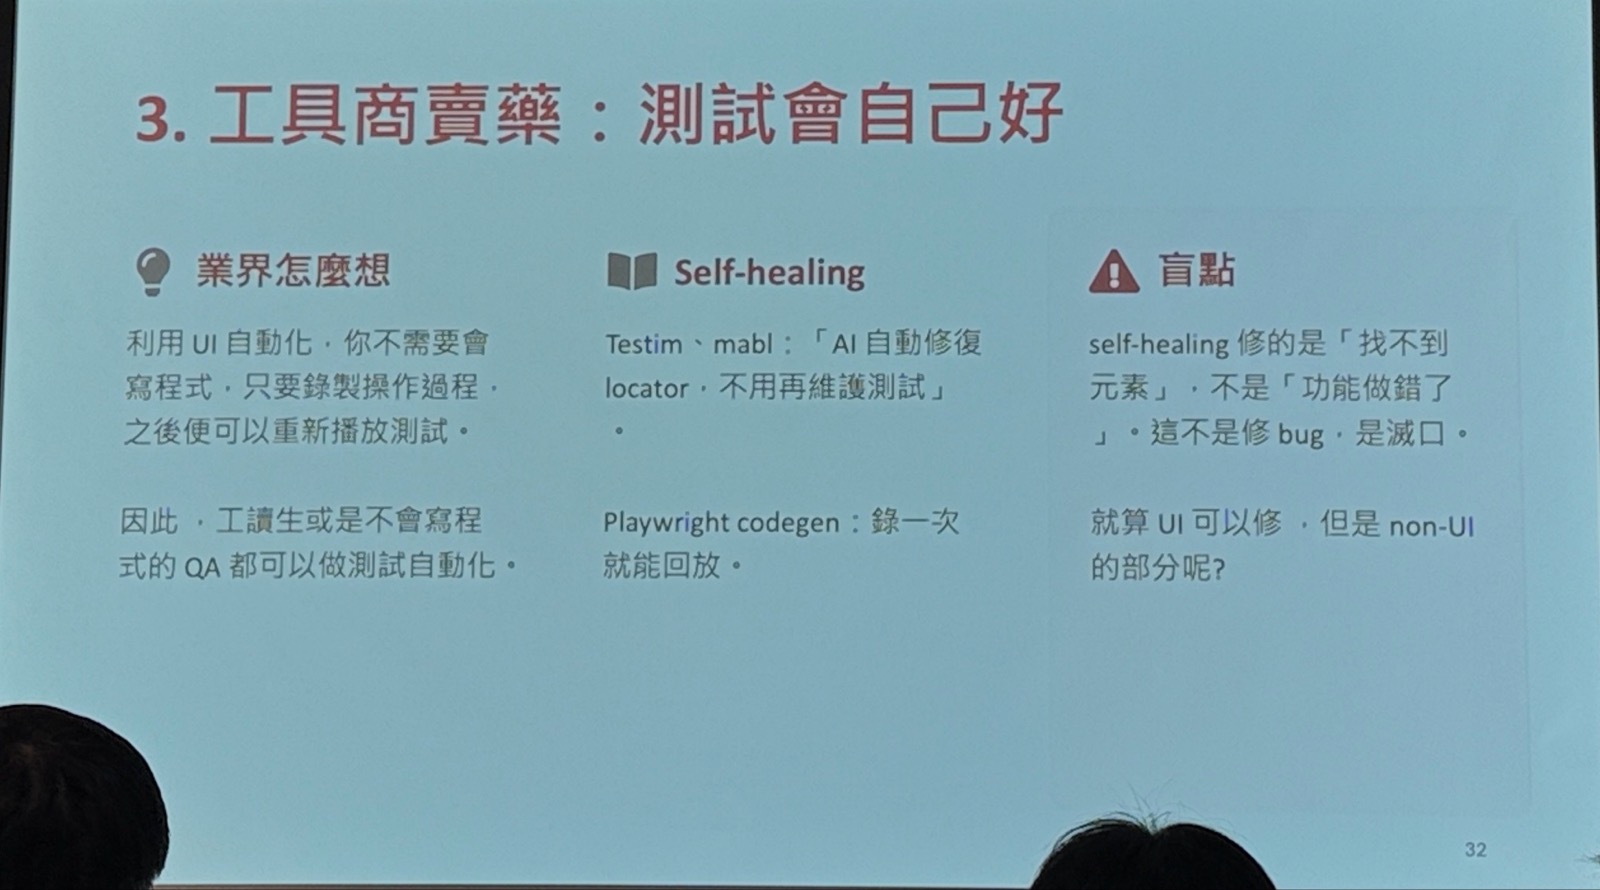
- 依David的描述,Layout小幅調整或名稱變動,是自動修復較能處理的情況;整個畫面大改,則不能期待同樣的修復能力。
- UI層面的修復經驗,不能直接推廣到API或沒有UI的邏輯問題,兩者需要的判斷依據不同。
- 請AI協助修bug之前,仍要準備足夠的Debug Log與重現線索。缺乏執行時的資訊,AI也難以判斷問題發生的原因與位置。
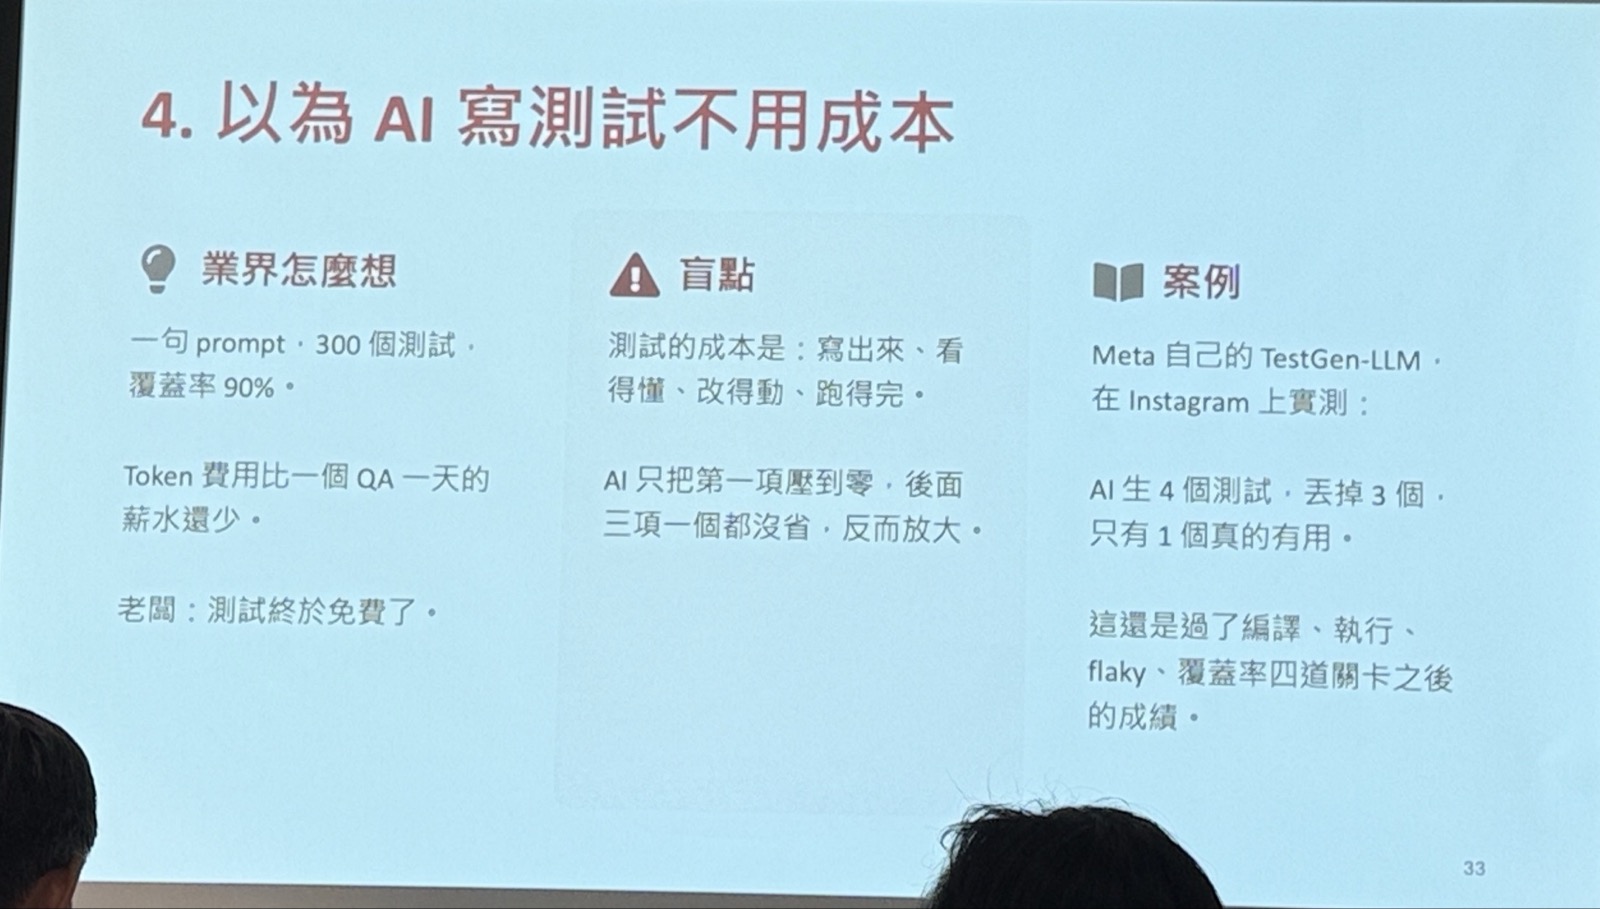
AI生成測試也不等於測試沒有成本。生成之後,仍須有人或檢查機制判斷哪些內容可用,再投入review、篩選與後續維護。David提到,Meta的案例並非把生成的test case全數收下,而是透過多道檢查淘汰大量候選內容。評估自動化效益時,必須把這些支持品質的工作一起算入,而不能只計算生成速度。
需求先對齊,再讓AI展開測試
要改善AI生成測試的品質,先確認團隊是否已清楚交代要驗證的需求,而不只是責怪工具不擅長測試。David認為,若能仔細說明要做什麼,AI產出的test case通常不會太差;關鍵是先把需求釐清,讓生成工作有可靠依據。
- 在開發之前,透過實例化需求、BDD與Specification by Example釐清需求,準備AC與具體test case,而不是等程式完成後才開始決定該驗證什麼。
- 邀請相關人員共同討論需求到底要做什麼,將各自的理解對齊,讓案例承載共同確認的預期,而非只有單一人的想法。
- 共識確立後,再讓AI依據這些需求與案例展開測試工作;先補足脈絡,才能讓生成結果貼近真正要驗證的內容。
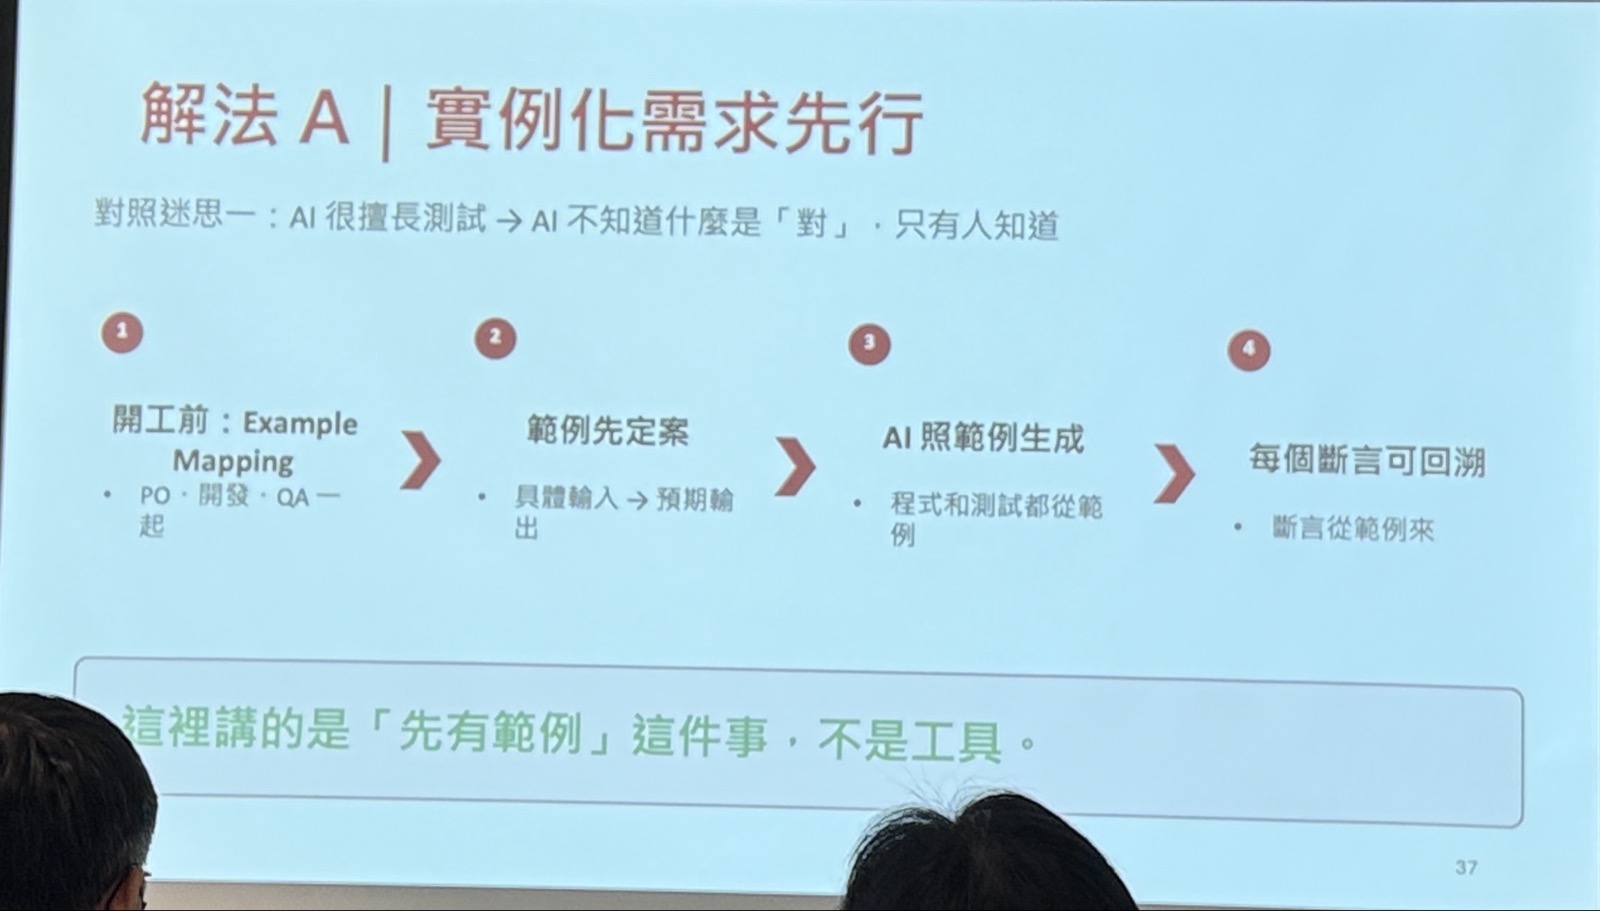
BDD的核心是共同討論與釐清需求,不是把從需求生成到自動化執行的所有步驟交給AI。David特別區分:如果一個人從頭到尾獨自完成,再用AI將整套流程自動化,這可以是很好的自動化測試流程,卻不能因此稱為BDD,也不等於已實踐Specification by Example。
把個人的需求轉成資料,或建立可自動執行的流程,只是改變需求的呈現與處理方式,並不代表相關人員已建立共識。若缺少共同討論,AI接手的仍可能只是某一個人的理解;流程即使完整跑通,也不能取代需求對齊。
「這個共識定出來之後,後面AI才能夠救你。」
— David
用分層關卡篩選AI生成的測試
篩選AI生成的測試,應先強化CICD pipeline,用自動檢查攔下不可靠的內容,再把人工review留給重要或高風險的功能。David強調,生成比較快,不代表生成結果自然有用;確認測試是否值得保留,仍需要投入驗證成本。
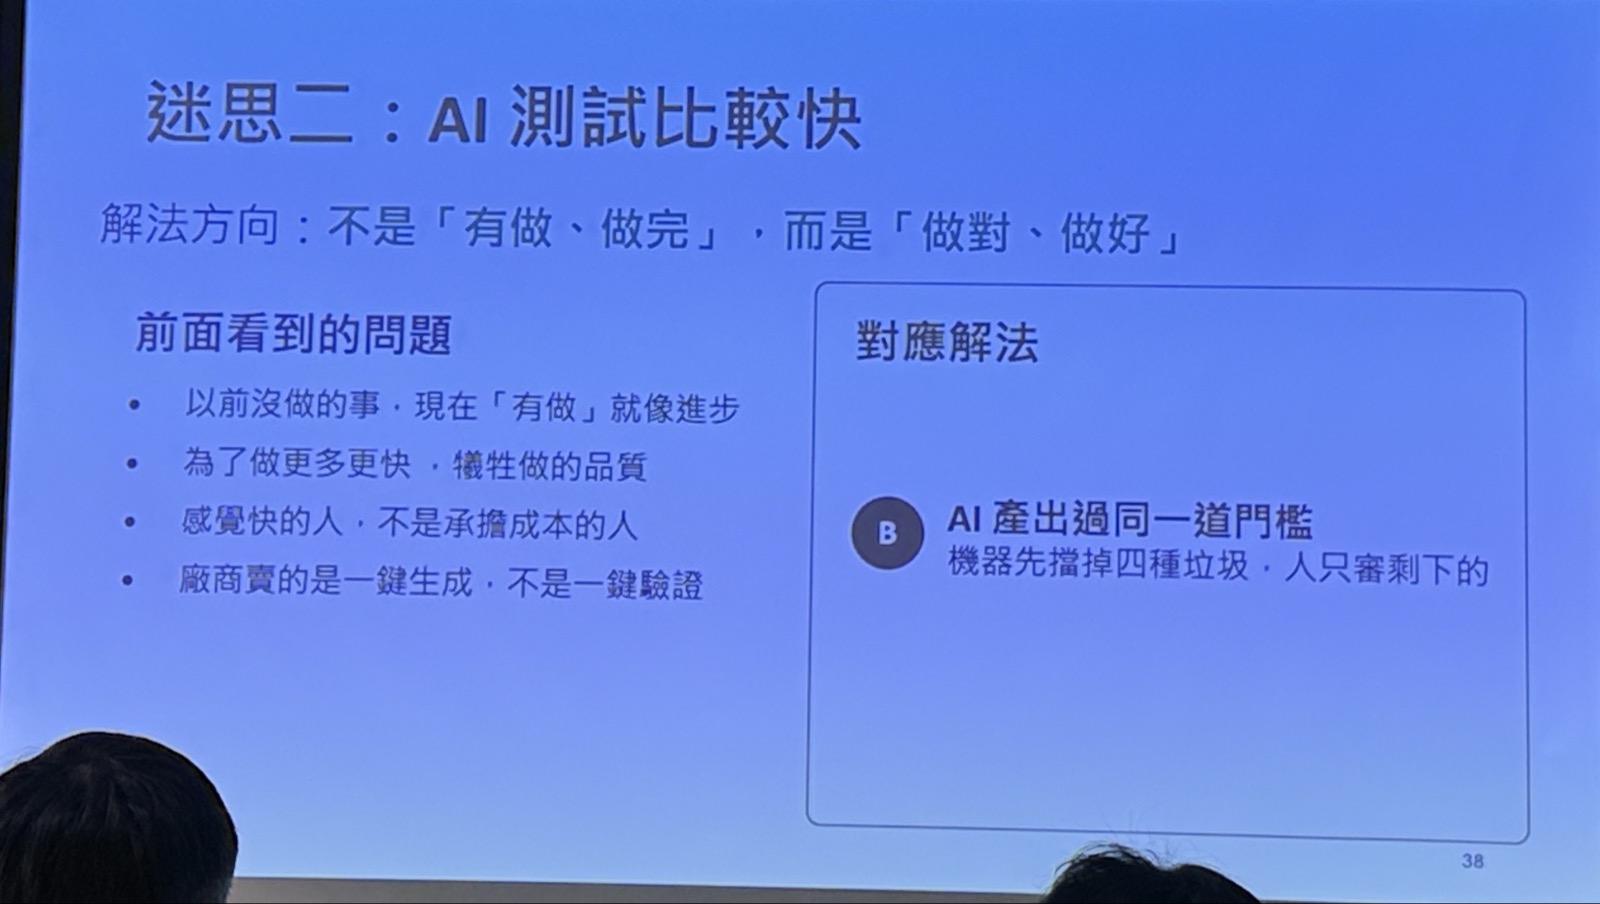
第一層先跑code scan等基本關卡。如果這些檢查未通過,就不急著請RD投入後續測試。接著再檢查生成測試的內容與執行表現,避免把所有案例直接交給人逐一閱讀。
- assert是否合理:檢查斷言是否正確,不能只看測試能否執行通過。
- 案例效果是否重複:不同test case可能只是在重複檢查同樣的效果,數量增加不一定帶來額外價值。
- coverage是否增加:觀察新增測試是否帶來涵蓋增量,作為篩選訊號,而非將涵蓋率增加視為品質保證。
- 重複執行是否穩定:不能只跑過一次就接受;有些測試前兩次正常,執行到第五次卻可能失敗,需要透過連續執行辨識不穩定的案例。
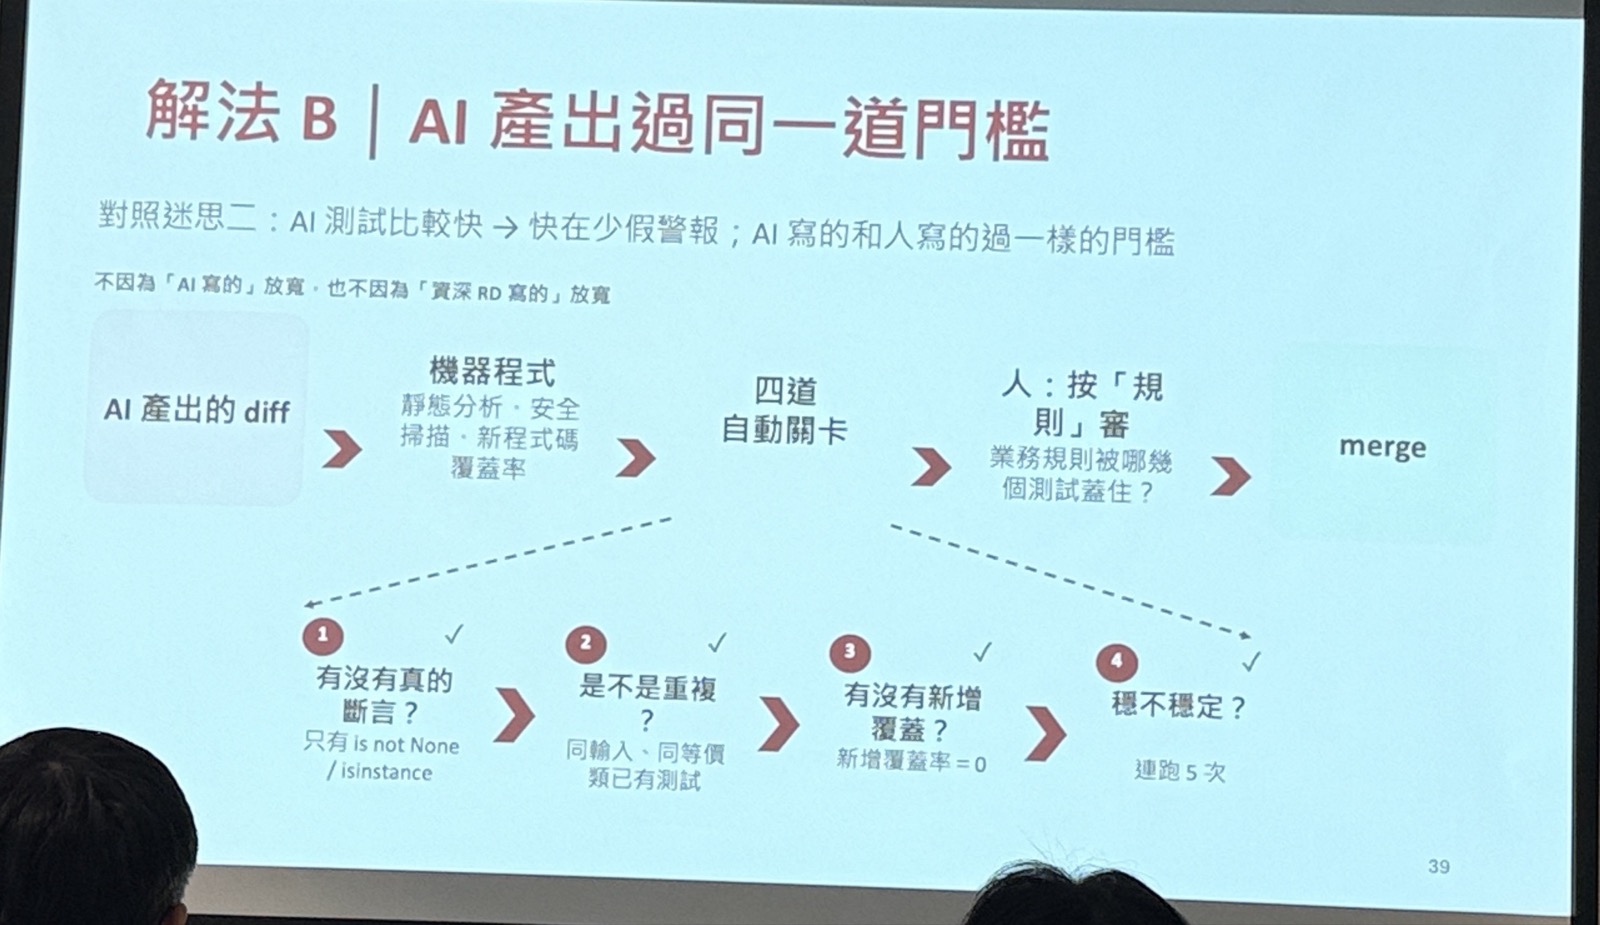
通過自動檢查後,再依功能重要性與風險安排人工review。David提出,小功能可以考慮減少人工介入;重要或高風險的功能,則仍應由人進一步檢視。這不是全面取消review,而是先建立能攔下不可靠測試的機制,避免對所有生成內容投入同等的閱讀成本。
「因為你要不去做review,不是不行,而是在你前面有沒有像這些的檢查機制,去幫你去擋下一些不可靠的測試。」
— David
David引述Meta在2024年的一篇文章,說明這類篩選流程如何運作:先由LLM生成test case,再依序檢查能否build、執行是否通過、連續執行多次是否穩定,以及coverage rate是否增加。依他的轉述,約100個生成案例經過這四道關卡後,留下約25個。
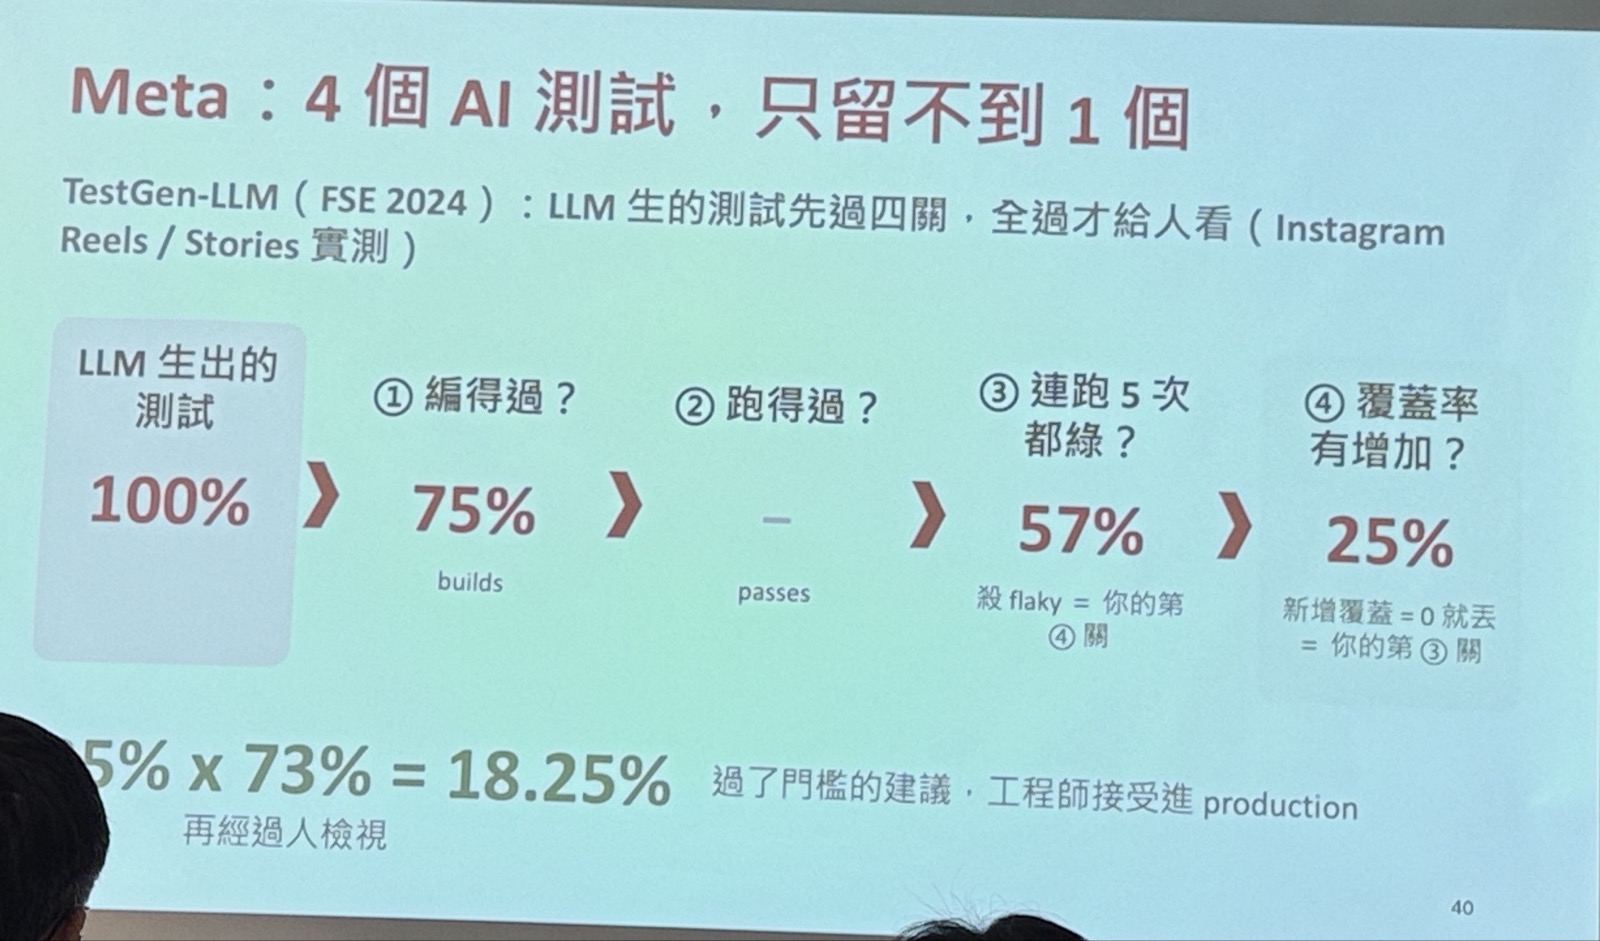
留下的案例再經人工review,按David提供的73%保留比例計算,最終保留率為25%乘以73%,也就是18.25%。這是他引述的特定案例,不能視為現今所有LLM生成測試的固定有效率。案例呈現的重點是:生成之後還需要分層篩選,而這些關卡可透過強化既有DevOps能力逐步建立。
故意改錯,驗證測試是否真的有效
測試全部綠燈,還需要追問:如果程式真的出錯,這些測試會發現嗎?David建議,針對正在驗證的功能,刻意把程式稍微改錯,再執行原有的test program,直接檢查測試能否抓到問題。驗證對象不只是功能,也包括測試本身。
「你應該先去試試看說,如果你亂改以後,你那個東西是不是還是綠燈」
— David
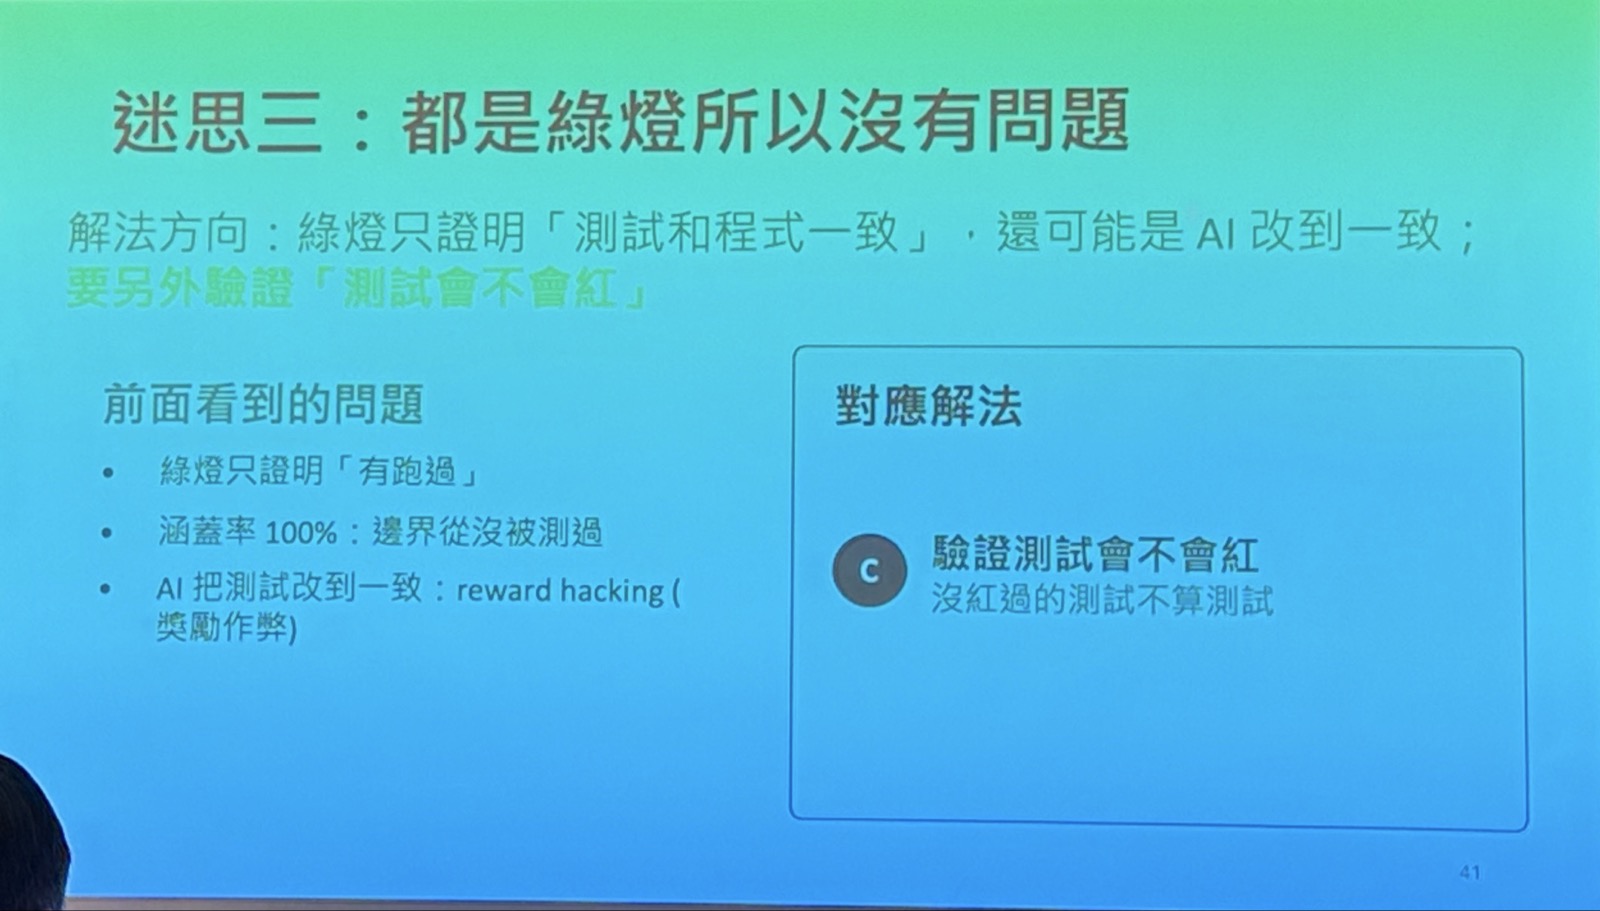
- 先選定要驗證的功能,將原本正確的程式稍微改錯,讓測試面對一個已知存在的問題。
- 重新執行相關測試,確認test program是否能抓到這次改錯,而不只是確認原本的程式可以通過。
- 若改錯後仍然綠燈,就應回頭檢查test case與斷言是否真的能辨識該問題,而不是繼續用通過數量累積信心。
- 若測試成功抓到問題,便取得了它能辨識這項特定錯誤的證據;但這不代表它已涵蓋所有可能的缺陷。
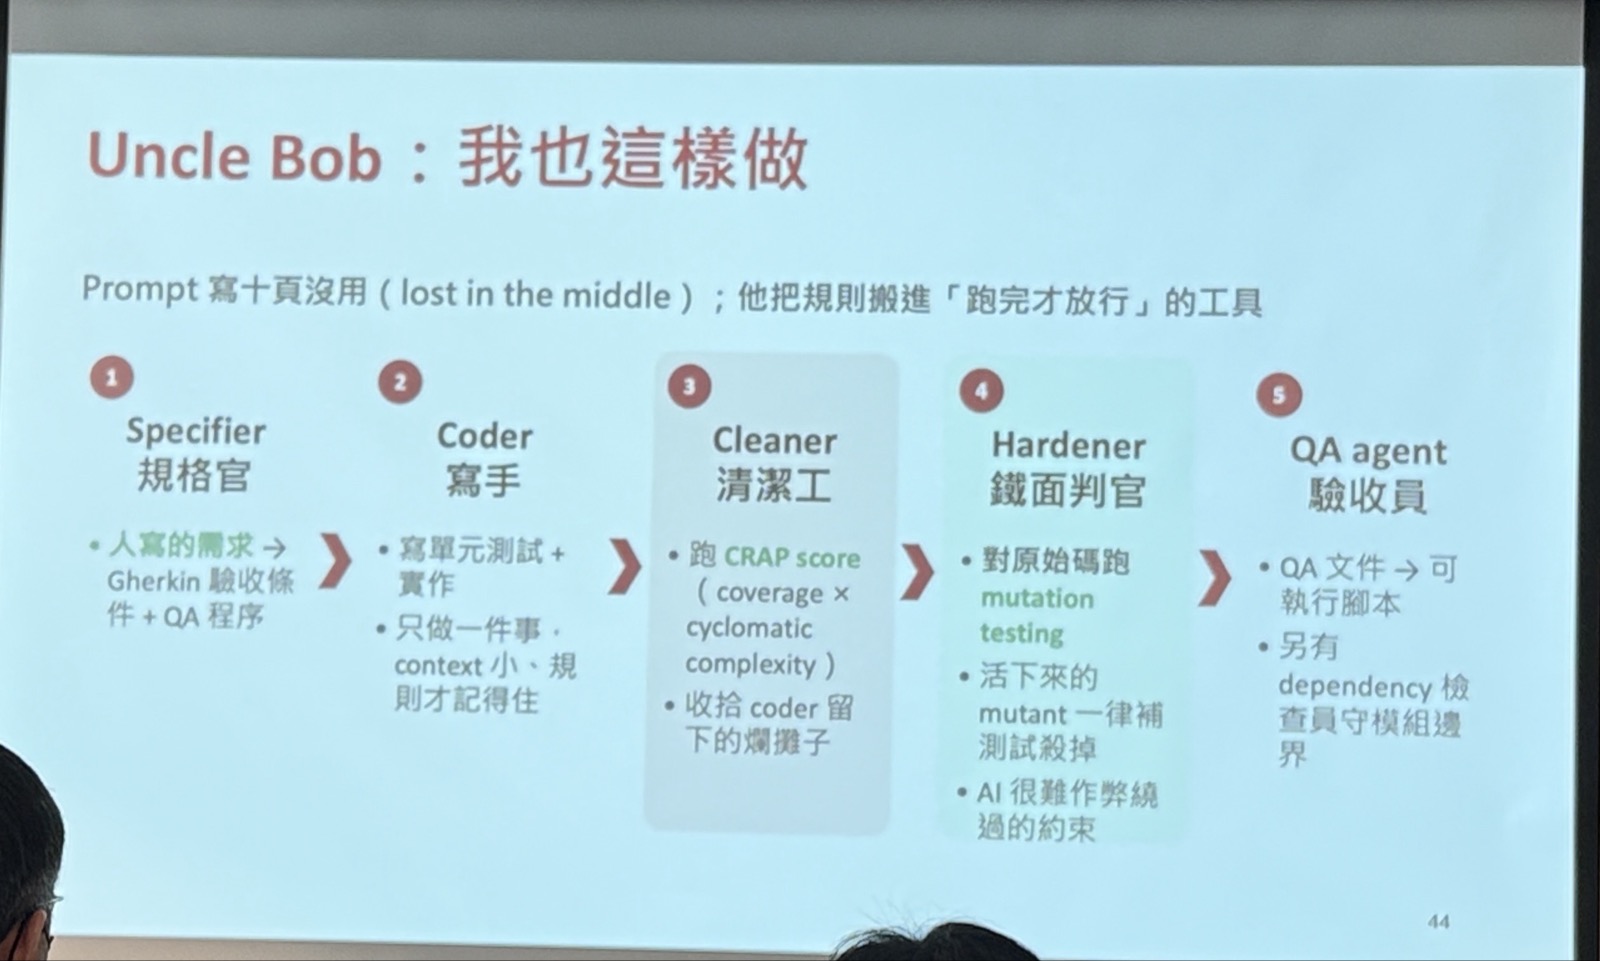
這也是Mutation testing的核心思維:透過刻意改錯,反過來驗證測試是否管用。David建議先手動嘗試,不必一開始就全面自動化。先改一小部分、跑一次測試、觀察結果,就能開始檢查綠燈背後是否具備實際的錯誤偵測能力。
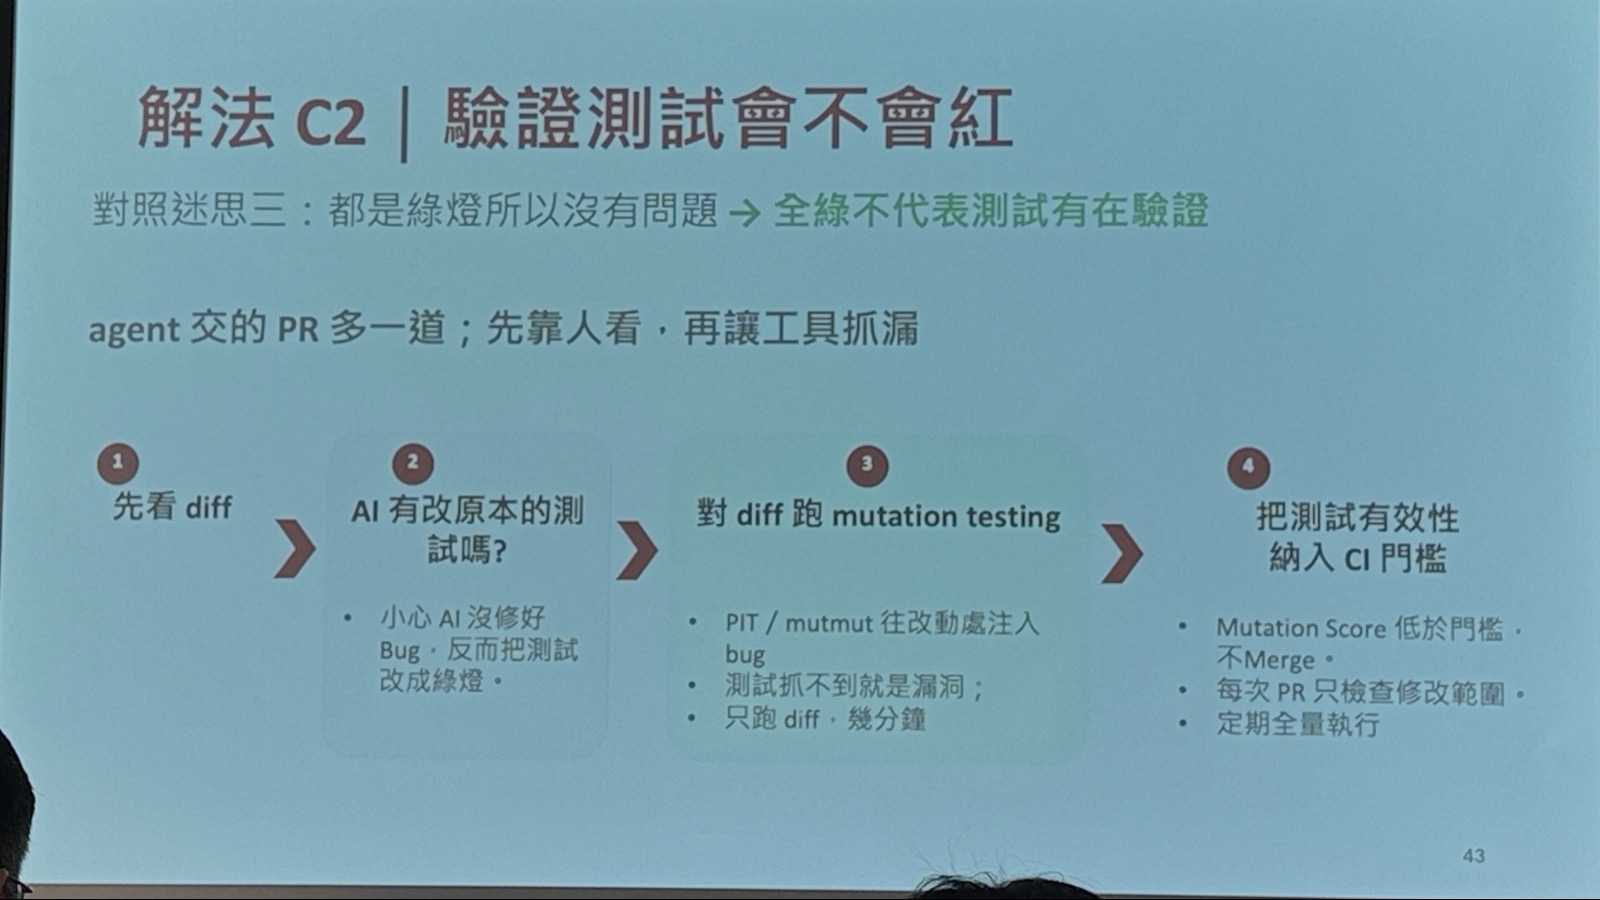
David以Uncle Bob為例,指出他將Mutation testing納入CI/CD pipeline,作為流程中的一道檢查。不過,這樣的整合需要投入不少工夫;尚未具備條件時,先以手動方式驗證測試有效性,仍然是可行的起點。
作為進一步探索的方向,David提到Uncle Bob使用的Skill與Agent,其中包含協助進行Mutation的關卡,也提到Meta有Open Source的Mutation library。這些方向可供有興趣的團隊研究,但工具導入的目的仍是回答同一個問題:現有測試是否真的能抓到程式中的錯誤。
人工探索,找出清單之外的問題
測試不只是在既定清單上逐項打勾,也不等於把Test跑到全部通過。David將測試行為區分為Checking與Exploring:前者確認預先列出的情境,後者則透過實際操作與探索,發現清單之外的問題。即使已有AI協助執行檢查,人的探索仍有不可忽略的價值。
- Checking:先準備清單,再逐項檢查。可以由人工執行,也可以自動執行;兩者都受限於事先想到的情境。
- Exploring:不以預先列好的清單為限,在操作過程中觀察、嘗試並追查異常。例如原本只是換一種操作方式,卻發現功能因此失效。
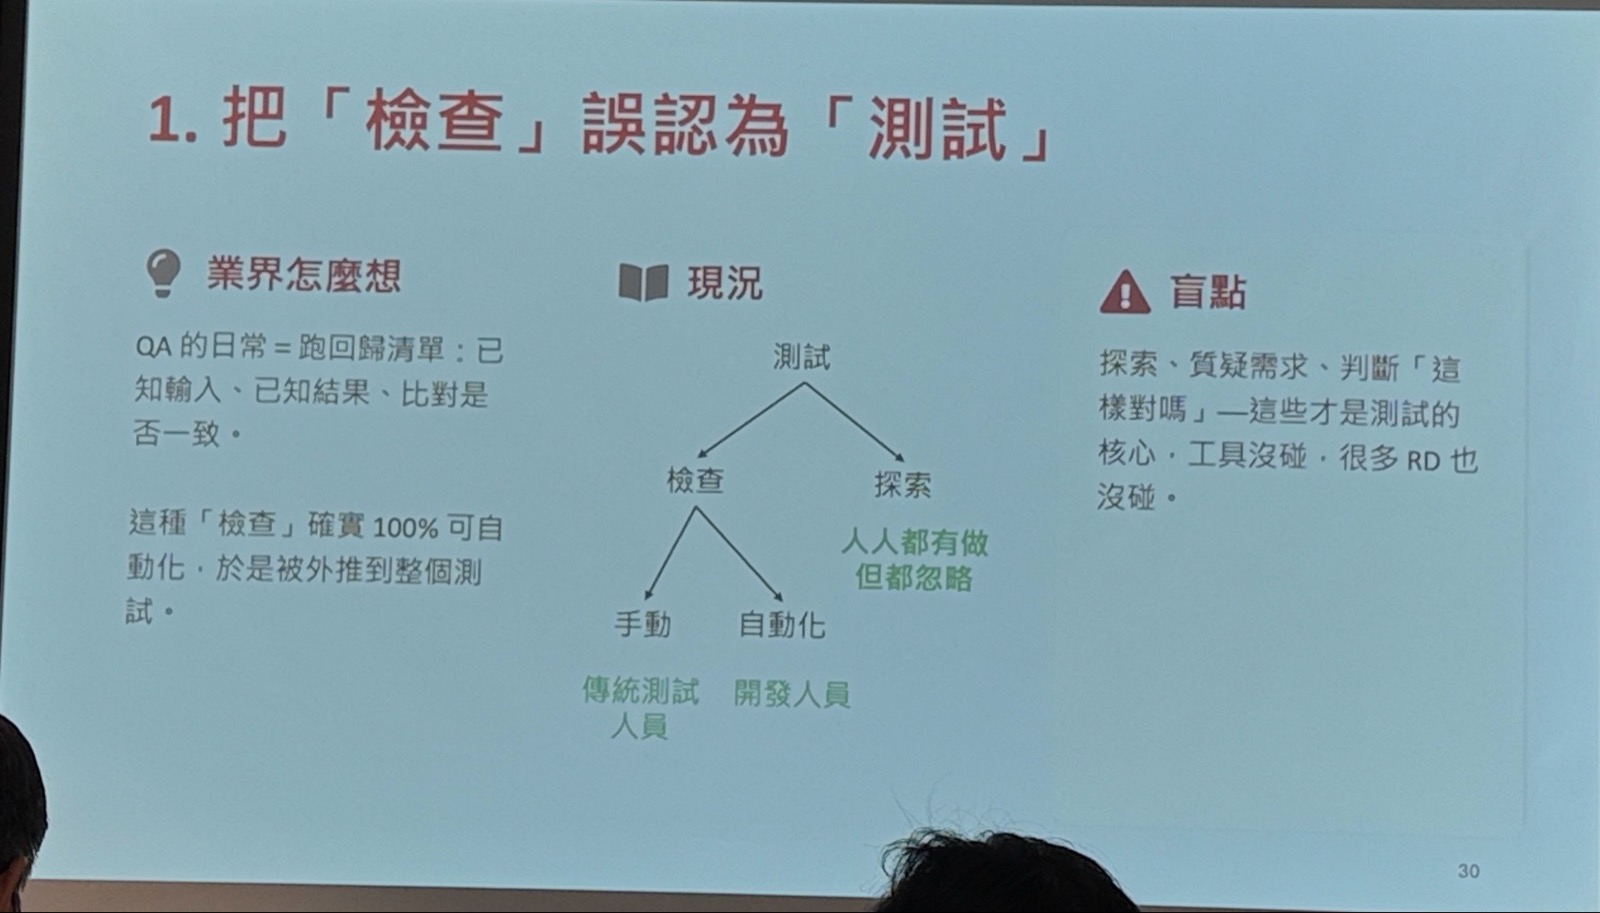
David在現場提出一個問題:假設團隊找到100個BUG,其中有多少是從TestCase裡找到的?他請聽眾按比例區間舉手,並表示自己多次詢問時,回答分布往往落在約四成左右。這是講者對現場互動的觀察,不是正式研究的缺陷來源比例;真正值得團隊追問的是,自己的缺陷究竟如何被發現。
團隊可以回查已發現的BUG,區分哪些由既有TestCase抓到,哪些來自測試途中額外的嘗試與觀察。如果不少問題是在清單之外浮現,就不能把Checking完成視為測試工作的終點,也不應因為自動化檢查全數通過,就省略人工探索。
讓人工探索進入日常流程,不一定要增加會議時間。David建議,把每次迭代完成後的Demo,從一人展示、其他人觀看,改成眾人實際測試已完成的功能。同樣保留約一小時,卻讓參與者從被動聆聽轉為主動操作。
- 將Demo改為共同測試:讓大家直接操作本次完成的功能,以實際使用取代單向展示,增加參與及發現問題的機會。
- 採用Pair Testing或Mob Testing:以兩人或多人一起測試的方式,讓不同觀點在操作過程中互相啟發,持續提出新的嘗試方向。
- 發版前安排Bug Bash:集中一段時間,例如一個下午,邀請專案相關人員一起探索。David將其介紹為微軟的一項practice;重點是讓參與者從User角度操作,補足開發者未預期的使用方式。
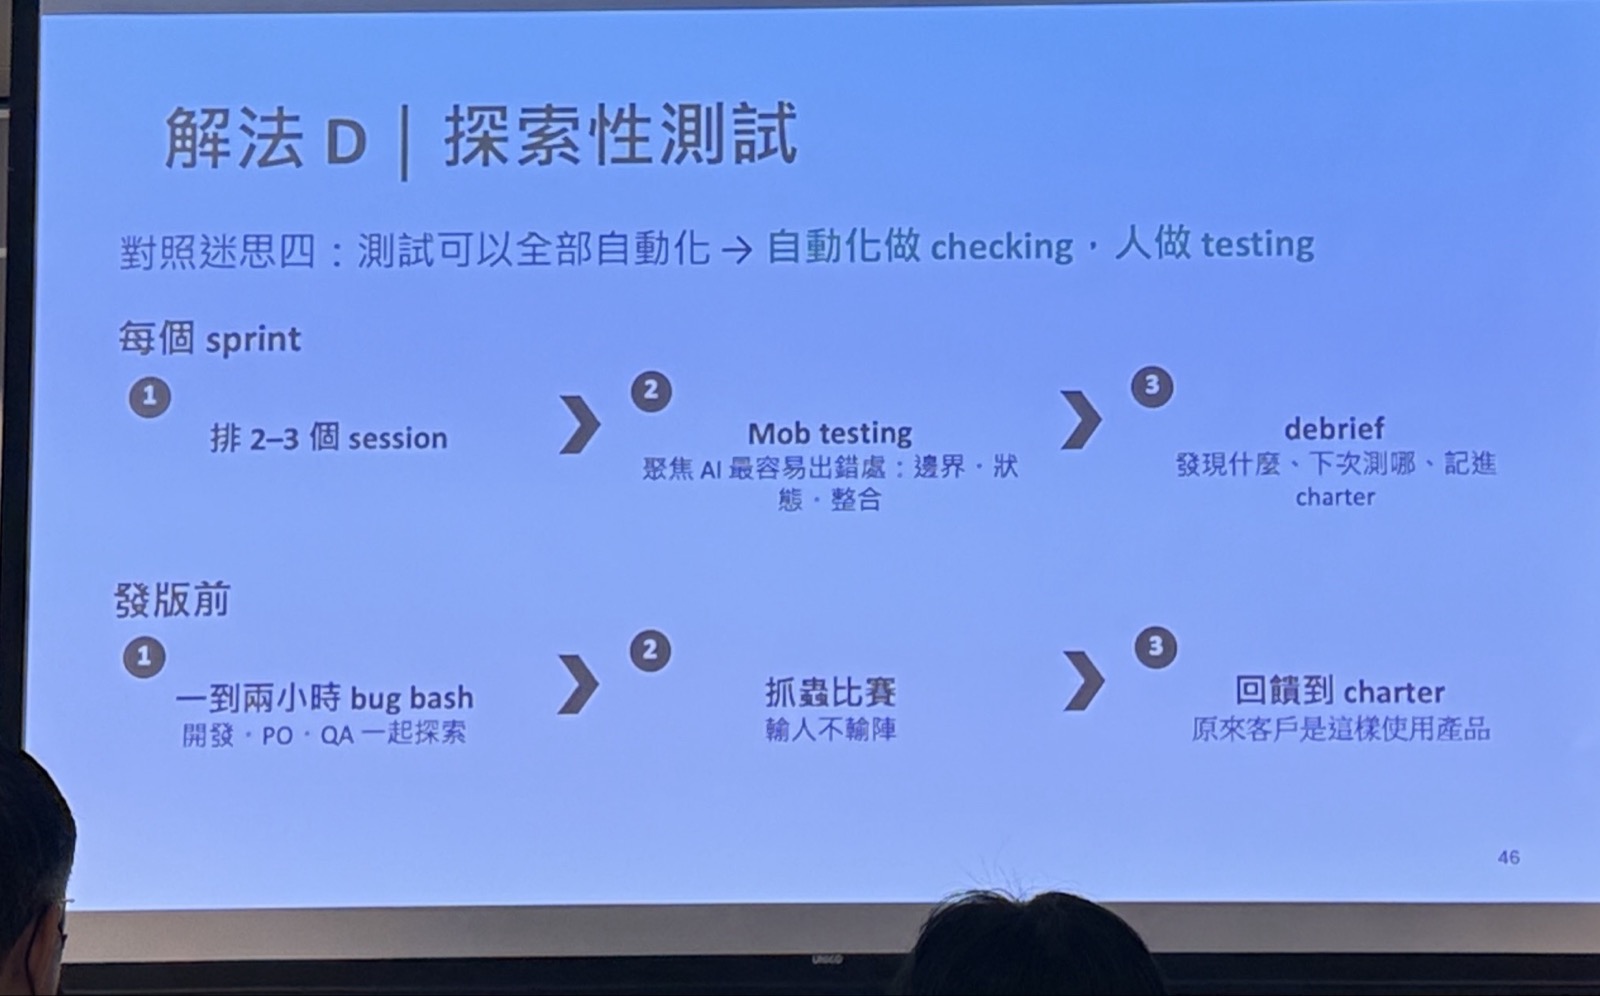
這些做法的核心不是再增加一套技術工具,而是改變參與方式。即使產品已接近發版,相關人員從User角度思考如何使用,仍可能找出與開發者原先設想不同的操作情境。人工探索因此不是重跑一次既有清單,而是補上清單尚未提出的問題。
「程式測試只能證明有錯,但是他不能證明沒錯」
— David(轉述)
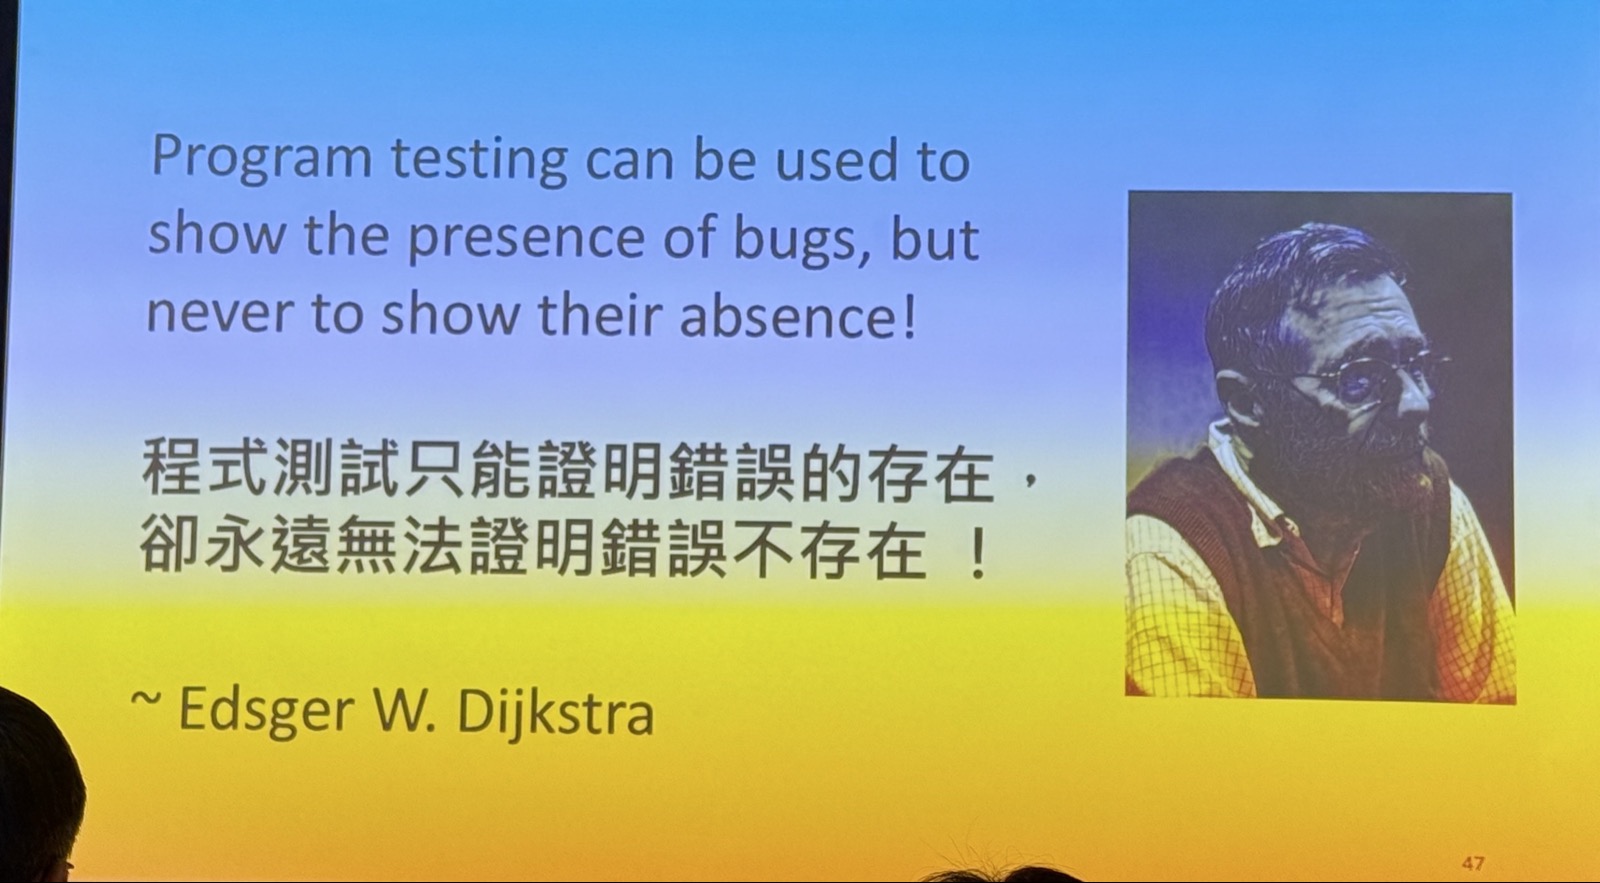
面對AI產出的測試結果,應保持「先質疑,再共舞」的態度:先挑戰結果是否可信、檢查是否遺漏,再思考如何運用AI協助解決。抓到Bug是問題存在的證據,沒有抓到卻不是品質無虞的保證。
「程式測試只能證明有錯,但是他不能證明沒錯。」
— David(轉述)
重點回顧
- 看有效性,不只看數量:測試案例、綠燈與涵蓋率都需要搭配需求與風險判讀。
- 先建立共同需求,再用自動關卡篩選,最後依風險投入人工review,讓驗證資源用在重要處。
- 從一次手動改錯開始,確認測試能對錯誤發出警訊,再評估導入Mutation testing。
- 保留人工探索與跨角色共同測試;自動化擅長執行既有檢查,不能因此忽略未知情境。
- 先質疑,再與AI共舞:不因結果漂亮就停止追問,也不因AI有風險就放棄善用它。
LLMUnit TestingWhite-box TestingassertLegacy CodecoverageDark factoryCheckingExploringBDDSpecification by ExampleACCICDMutation testingPair TestingMob TestingBug Bash