自己刻 Agent 框架:最難的不是呼叫 LLM
TL;DR:Jamis Liao 的分享核心是,Agent 的第一版往往只是一個呼叫 LLM 與工具的 while loop;真正困難的是把它變成能在線上穩定運作、可驗證、可追查、可控成本的系統。實務上必須處理 Context 篩選與敏感資料、流程約束、評測與回歸、防呆機制、Human In The Loop、完整執行軌跡,以及模型與 Token 成本。這些方法多屬目前 Agent 工程的基礎實務,但對於從 POC 跨入正式服務,仍是一份脈絡完整的落地檢查表。
從 POC 到線上服務:一個 loop 不等於一個系統
Jamis Liao 從自己開發 Agent 框架的經驗出發:最初的想像很直觀,將問題與可用工具交給 LLM,模型決定下一個工具呼叫,系統把工具結果放回 Context,反覆執行直到任務完成。這個 POC 很快能跑起來,卻不代表已具備產品化條件。當 Agent 開始承接公司服務或產品任務,原本隱藏的資料治理、流程控制、錯誤處理、上線驗證與成本問題會一次浮現。
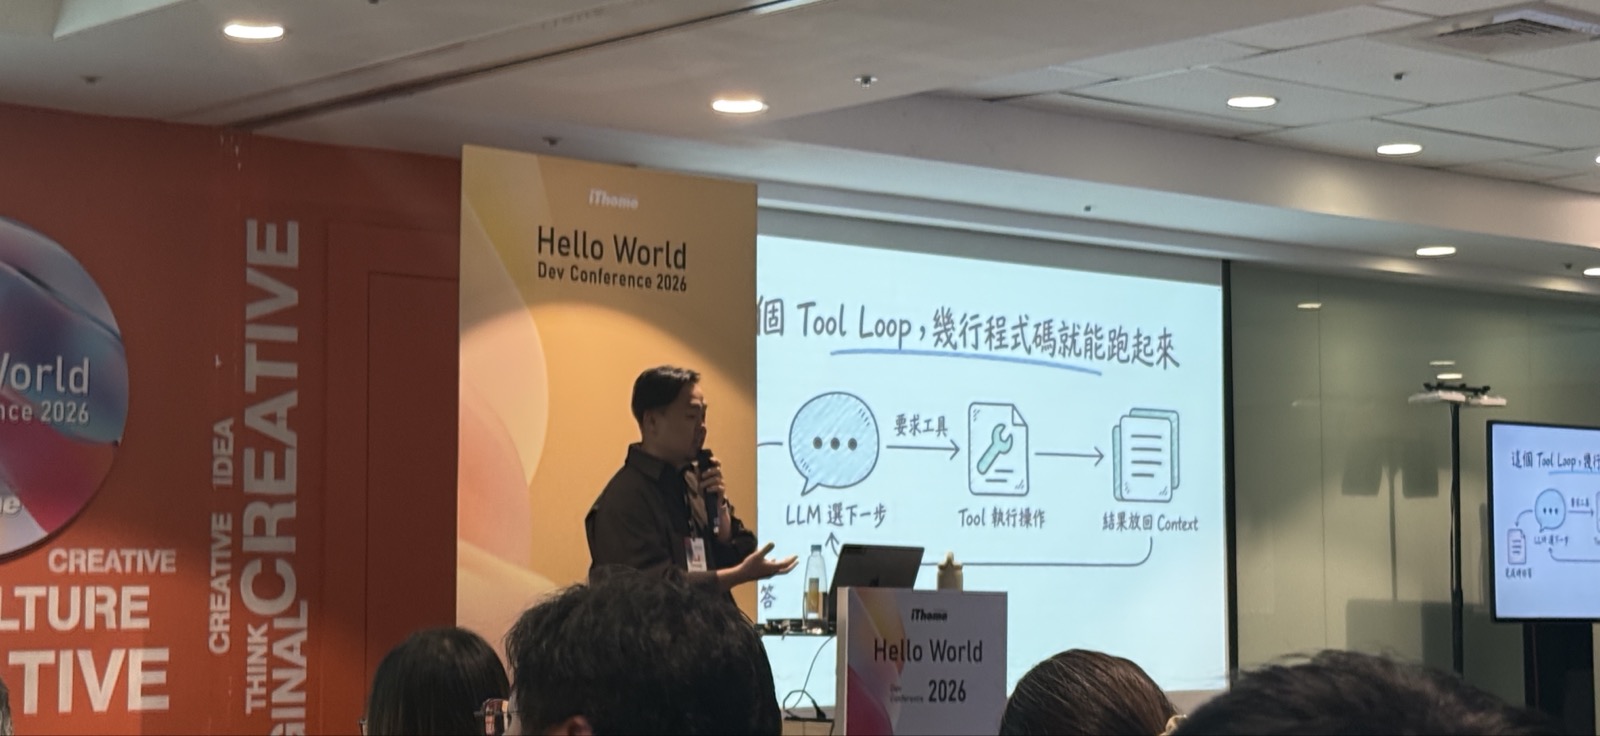
- 資料面:哪些資料應讓模型看見,哪些資料過多、敏感或不必要。
- 流程面:如何讓 Agent 依指定步驟與規格完成任務,而不是只產生看似合理的答案。
- 品質面:LLM 具有機率性,必須界定哪些錯誤可接受、哪些錯誤必須攔下。
- 維運面:出錯後必須保留足夠紀錄,才能定位是 Skill、prompt、程式碼、工具結果或模型設定造成問題。
- 商業面:正式導入前就要能估算 Token、模型與硬體成本,不能等帳單出現才處理。
「寫一個loop很簡單,但是你要讓這個loop能夠正確的完成任務,是正確的完成任務,才是一個最困難的工程問題。」
— Jamis Liao
為何自刻框架:可替換模型、細節控制與治理整合
面對 Anthropic、OpenAI 的 SDK、LangChain 與微軟等既有框架,Jamis 選擇自行實作,不只是因為起步看似簡單,而是希望避免模型供應商綁定、掌握每個執行細節,並把企業所需的治理與系統整合放進架構。尤其在金融、銀行或具合規要求的環境,AI 的執行軌跡與存取行為不能任由框架預設決定。
講者指出,供應商原生 SDK 相對較可能涵蓋治理需求,但也可能提高未來替換成較低成本或開放權重模型的難度;開源框架則多聚焦在功能元件,較少直接處理企業治理議題。因此,自刻的代價是必須自行補足大量工程能力,但回報是可以將資料邊界、紀錄、權限與模型策略納入同一個平台層。
Agent frameworkPOCSDKLangChainAI治理合規開放權重模型模型綁定
Context 控制策略:把資料倉庫與推理視窗分開
多輪 Agent 最常見的陷阱,是把每次 Tool Result 原封不動塞回 Context。單輪問答或短 prompt 時通常無妨;一旦任務包含多次工具呼叫,任務規則、舊結果、新結果與中間推理會不斷累積,使 Context 像沒有整理的工作桌,模型愈難抓住當前真正重要的物件。更重要的是,工具結果可能包含個資或其他敏感資訊,本就不應直接交給 LLM。
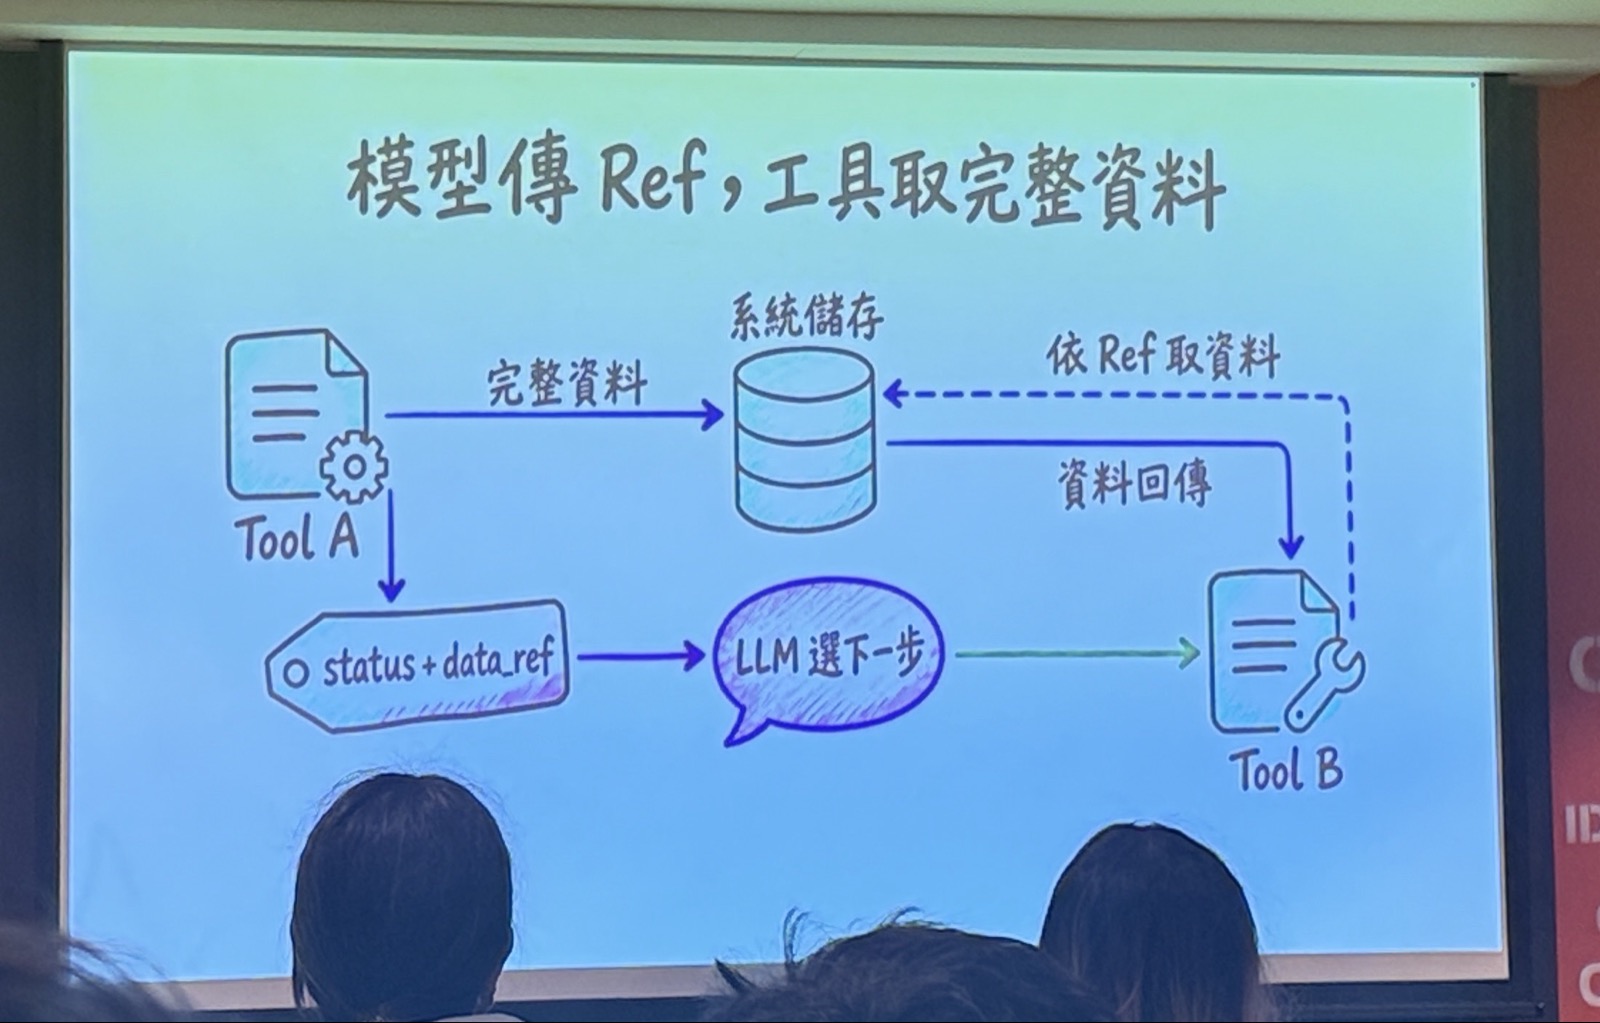
- 工具回傳後先做 PII 清洗或 filter,將完整資料與可供模型閱讀的資料分開。
- 由 Agent runtime 或平台層保存原始結果,可放在 memory 或其他儲存空間,而非全部帶入每輪推理。
- 只提供下一步決策真正需要的欄位、摘要或狀態,以抑制 Context 無限膨脹。
- 若模型根本不需要讀取原始資料,Context 可只放置 reference 位置;下一個工具再依此位置從系統儲存體取回真實資料。
- 讓真正需要個資或完整內容的 Tool 取得資料,而不是讓模型在推理階段持有不必要的敏感資料。
講者以查詢使用者資料後寄送 Email 為例:模型只需要知道上一個步驟已取得使用者資料,以及下一步應發送 Email;姓名與 Email 的實際內容可由寄信工具依 reference 取得。這種做法將推理判斷與資料操作拆開,既降低敏感資料暴露,也減少不必要的 Token。
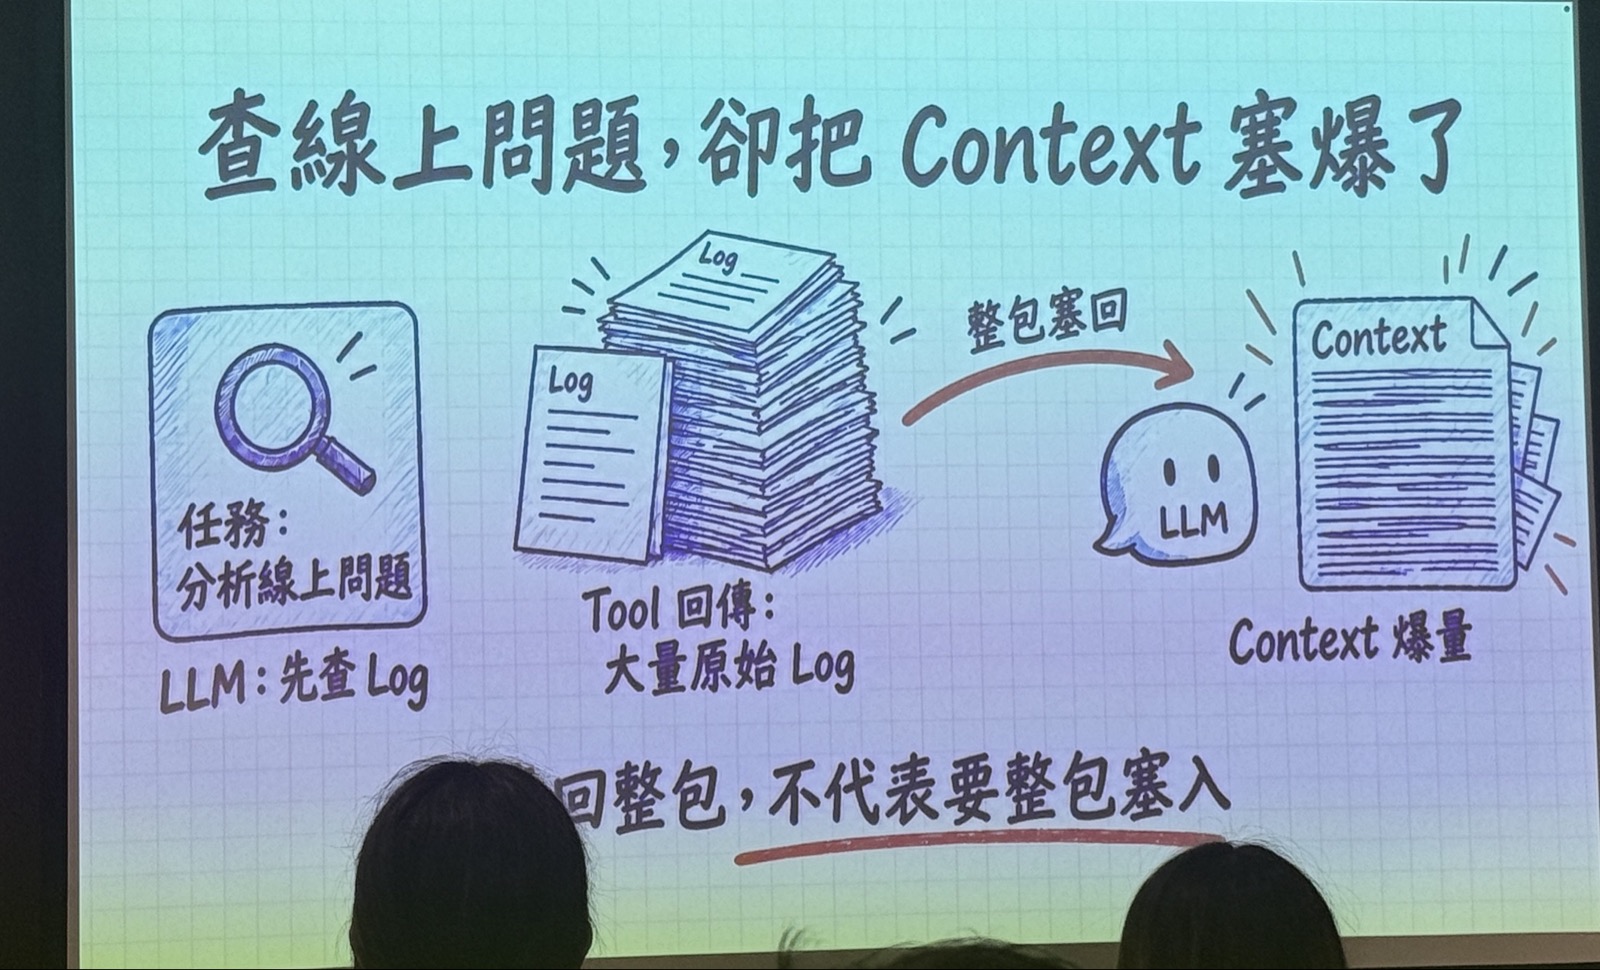
查 log 的案例更直接說明問題:幾千、幾萬行 log 若完整放入 Context,講者曾看到上下文迅速長到 30–40K。解法不是單純截短,而是依情境定義哪些 log 屬性與片段足以支持模型找問題。Context 控制的目的也不只是節省 Token;過長的上下文會讓模型偏離指定流程、忽略 Skill 中明確定義的步驟,或出現「你講 A、它做 B」的現象。
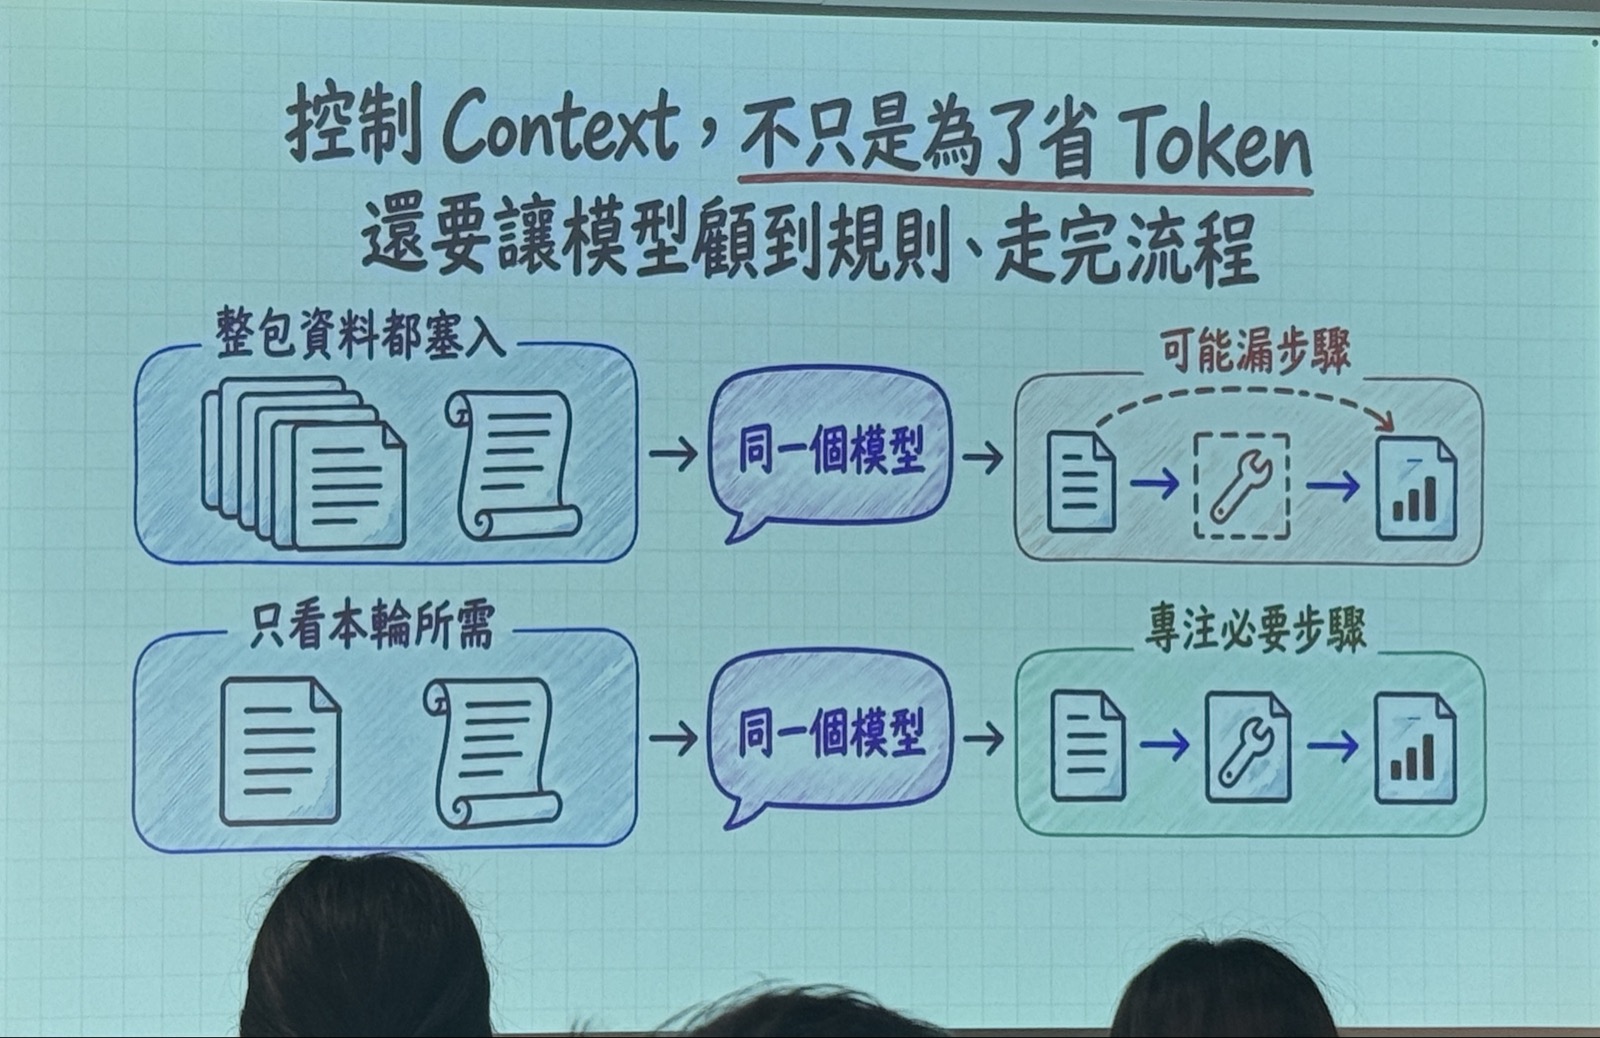
Jamis 將此現象連結到 arXiv 所稱的 Lost in the Middle:模型對 prompt 開頭與結尾的注意力通常較高,中段內容容易被忽略。對 Agent 而言,這意味著即使 Skill 寫得清楚,塞入大量無關 log 或歷史結果後,模型仍可能跳過流程。因此,filter 是可靠性設計的一環,而非只是成本最佳化。
ContextTool ResultPIIruntimereferenceLost in the Middlelogfilter
模型選擇與成本:先縮 Context,再升級模型
Context 大小會直接改變模型選型。講者以 GEMMA 4 的實務經驗說明:當 Context 約為 10K 時,26B 的 MOE 模型可以依 Skill 規範完成流程;當 Context 膨脹到 30K,模型開始不依規範行事,可能被迫改用 31B 的較高能力模型。這不只增加 API 費用,若採 Local Model,硬體需求與推理速度也會進入不同級距。
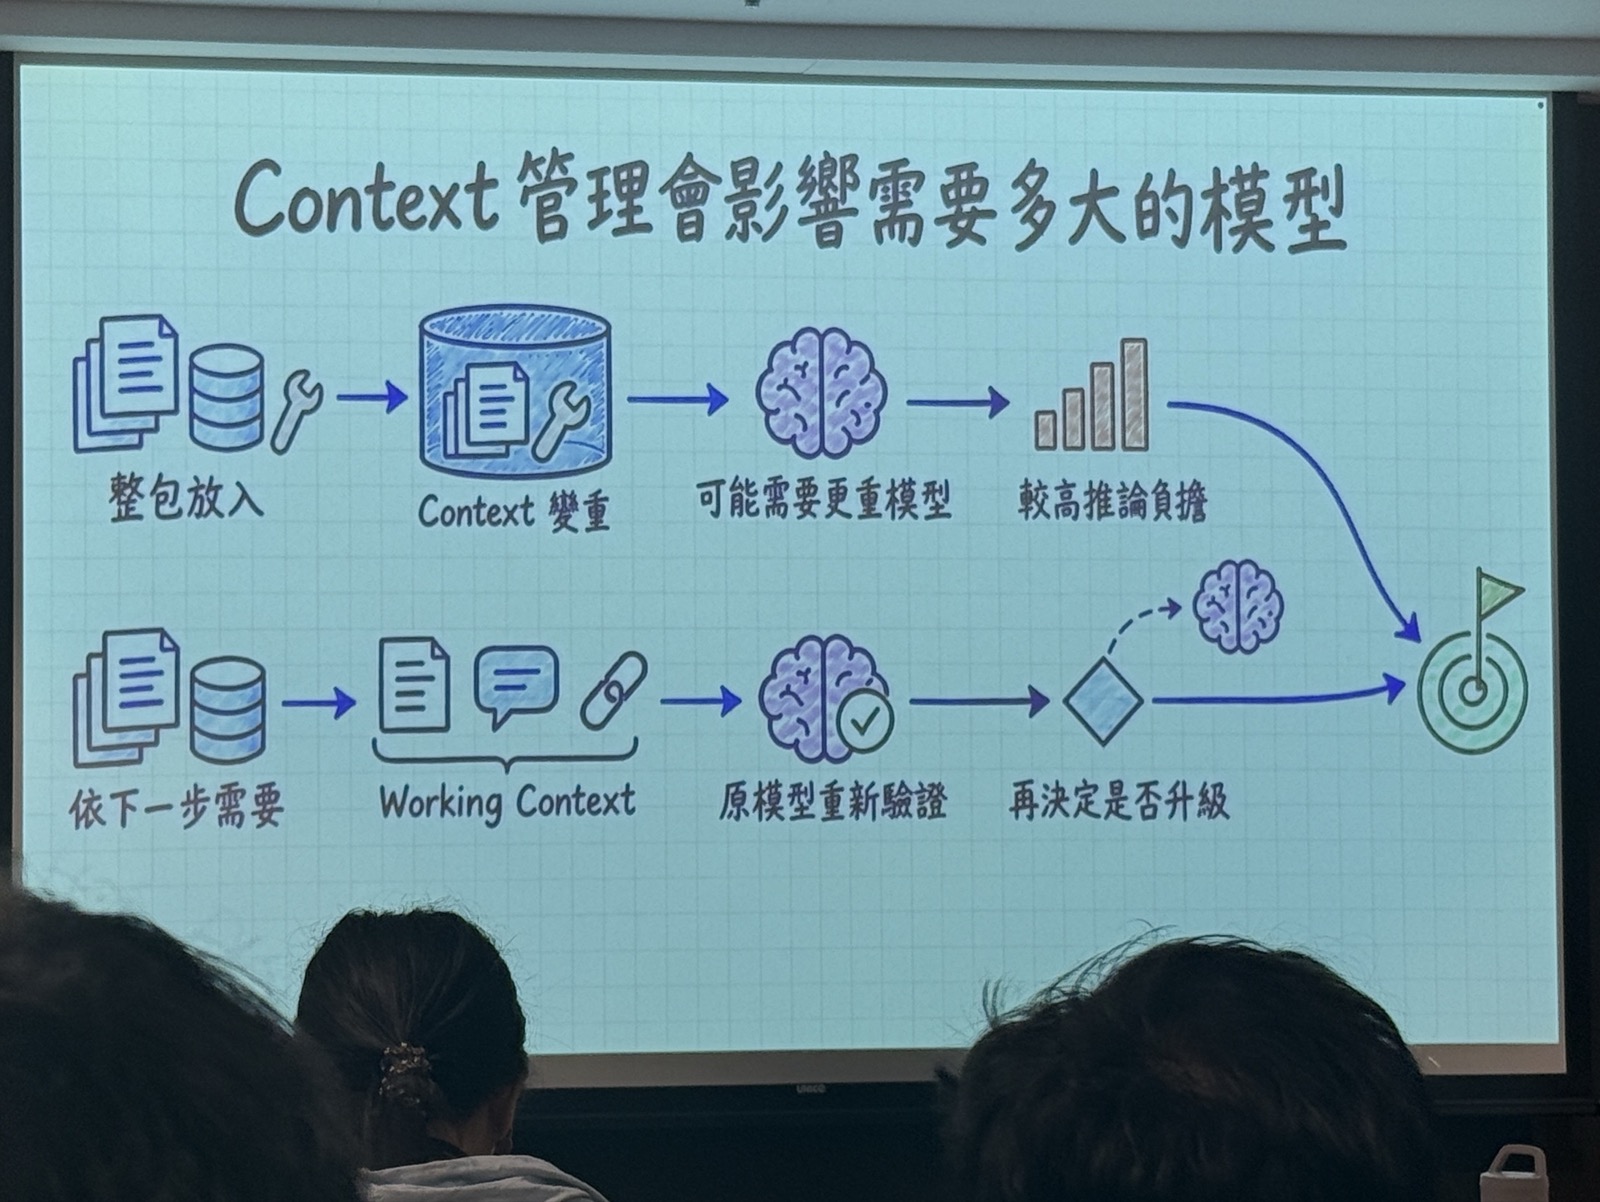
- 模型表現不佳時,先檢查 Context 是否包含過多或不相關資訊,再考慮換更大模型。
- 重新以縮小後的 Context 驗證,可能讓原本模型重新符合任務要求。
- 公司日常任務未必需要最高階付費模型;講者認為部分工作可由開放權重模型完成。
- 講者舉例,GEMMA4 的 31B 在 Google AI 的 API 可免費使用,未必一開始就要採用 Gemini 3 Flash 或 3.1 PRO 等付費等級模型。
- 模型選擇、Context 管理、Token 消耗與 Local Model 的硬體成本必須一起評估。
Agent 開發實務坑:有答案,不代表流程正確
在 log 分析後產出正式報告的情境中,講者一開始讓 LLM 自由撰寫 report,結果每次格式不同,也經常缺少預期資訊。若報告需要固定分類、統計與明細,應將這種確定性需求做成 report builder,並在 Skill 中要求模型於分析後呼叫 builder,而非自行拼接最終報告。
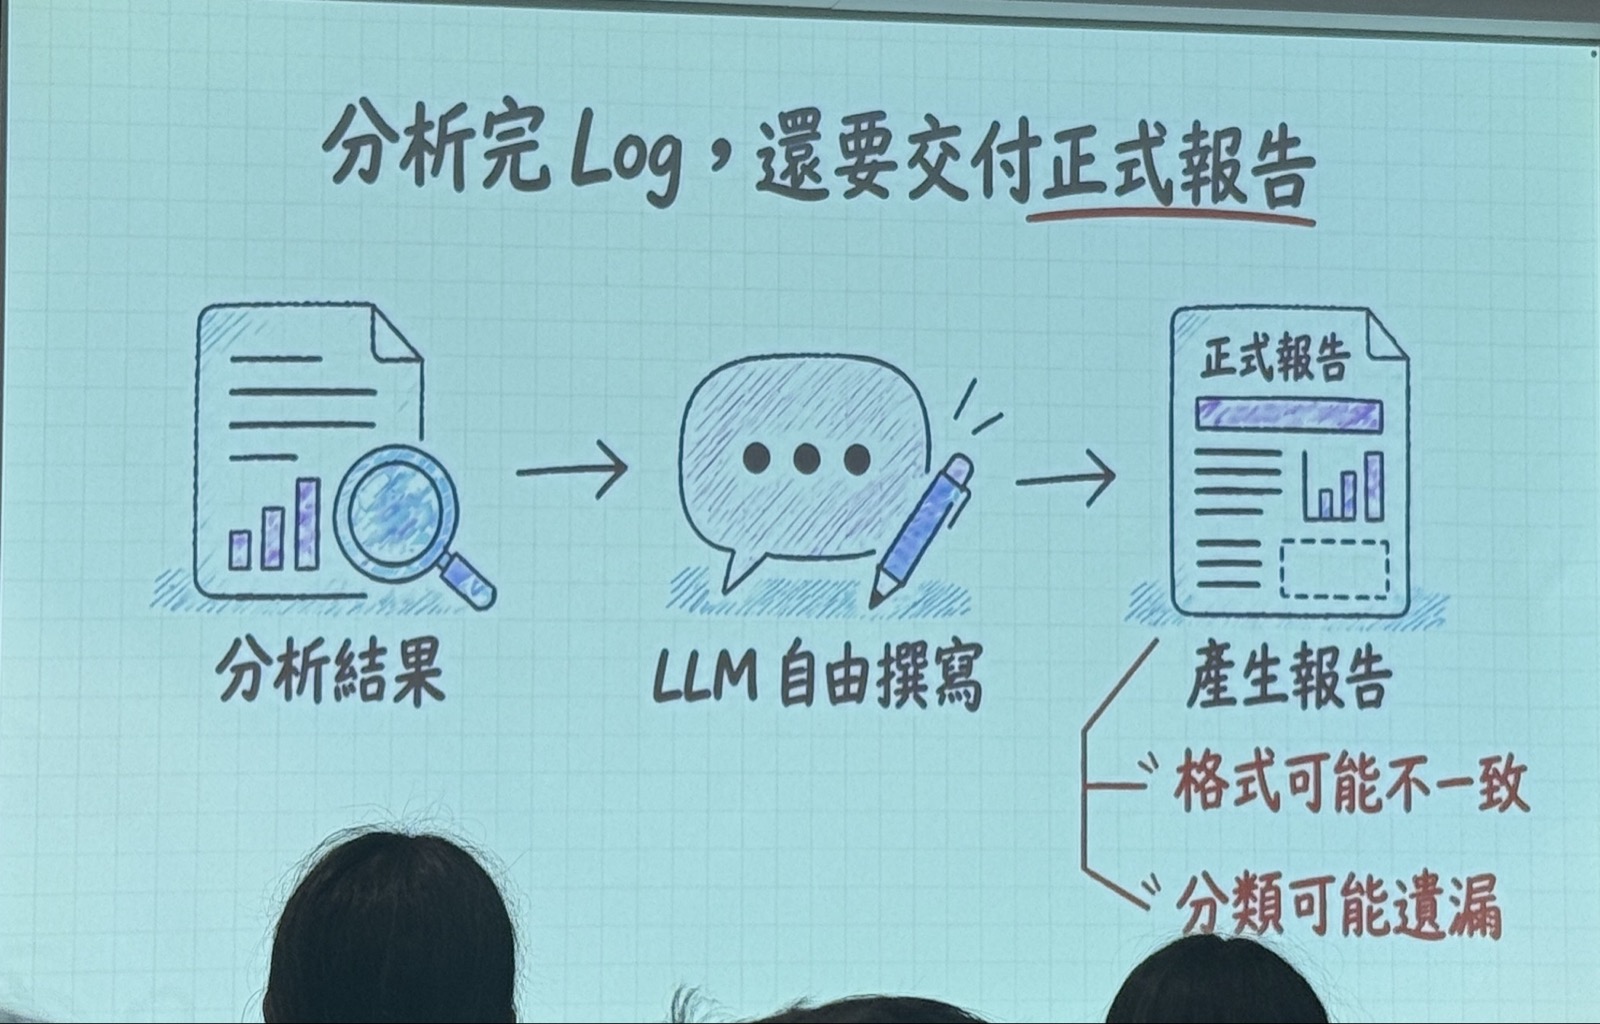
但即使指令已明寫「分析後呼叫 builder」,模型仍可能自行完成一份看似合理的報告。這揭示 Agent 與傳統 API 的關鍵差異:傳統系統沒有錯誤回應、且回傳內容看似正常,往往可初步視為成功;Agent 則可能交出內容正確度看似很高的答案,卻沒有遵循必要流程、沒有使用指定工具,因而不符合系統要求。
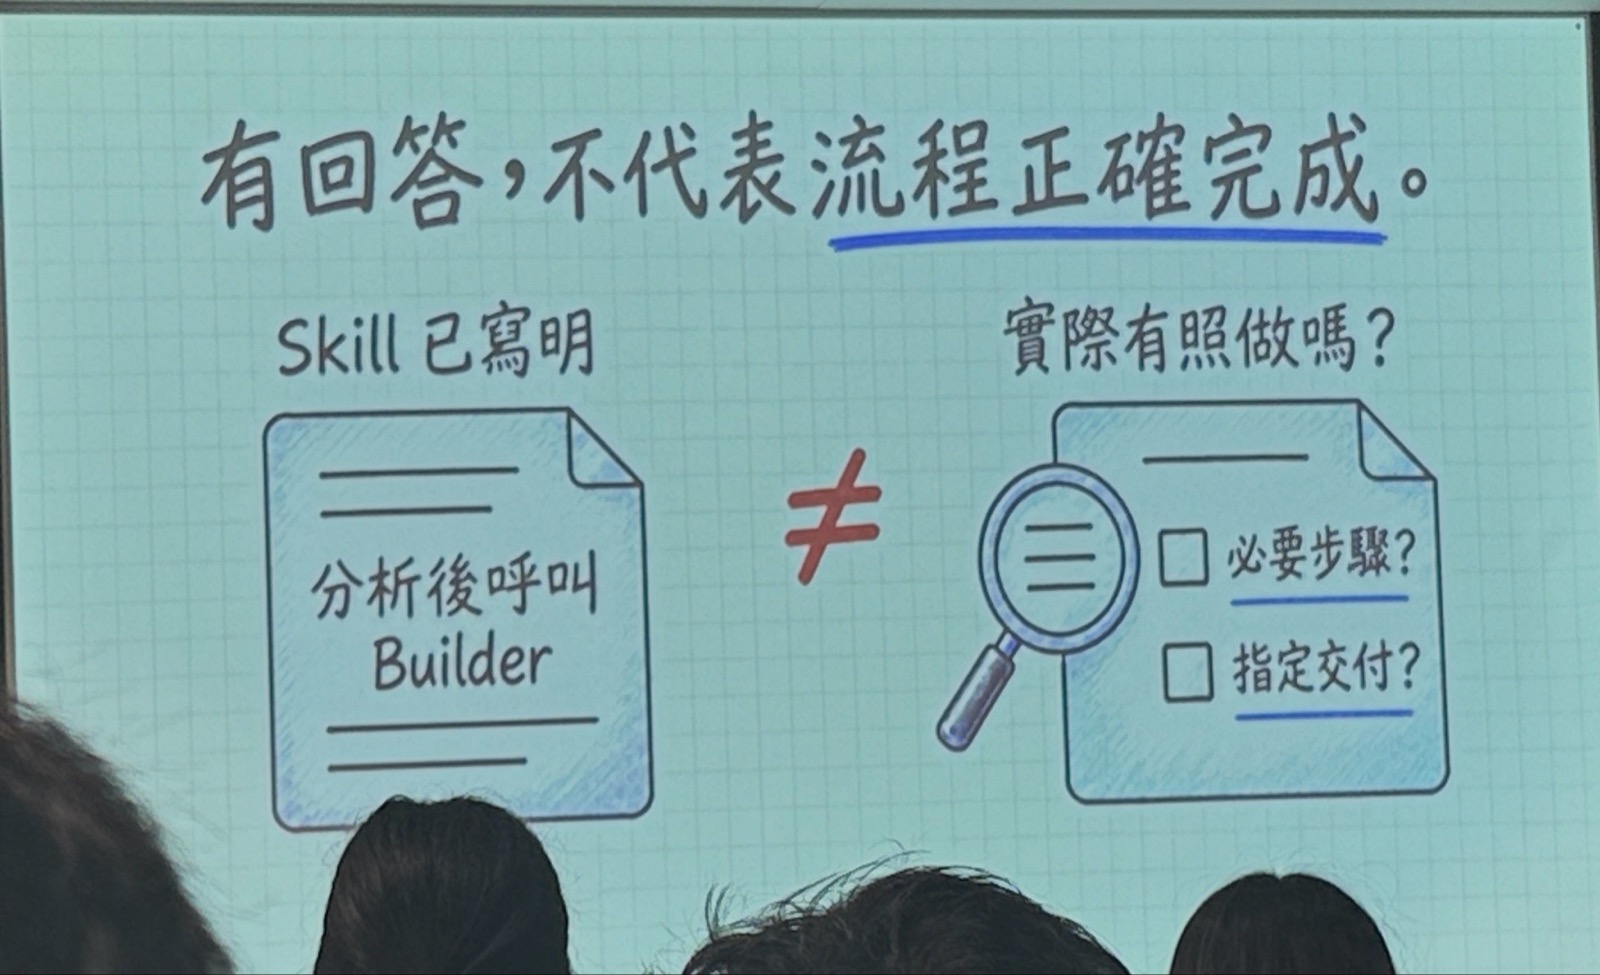
「它有回答你,不代表它作對;你有拿到結果,不代表系統沒有問題。」
— Jamis Liao
因此,開發 Agent 前要先像撰寫驗收條件一樣定義「完成」:以此案例而言,Agent 必須確實呼叫 builder、由 builder 產出報告、交付該報告,並依指定流程執行。最終產物與執行過程缺一不可。這也是分享中特別有價值的工程觀點:將 Agent 視為一個需要可驗收行為契約的系統,而不是只評判回答文字。
Skillpromptreport builderTool call驗收條件執行軌跡流程正確性
Agent 評測方法:同時驗收產出與執行軌跡
Jamis 以 evaluation 或 evals 說明 Agent 測試:準備任務、成功標準與測試資料,實際執行 LLM 後,檢查結果是否符合預期。這和端到端測試相似,可使用預先設計的測試資料來確認指定輸入下是否得到預期結果。不同之處在於,Agent 的評測不應只評估報告內容或是否產生報告,還應評估整段執行 flow。
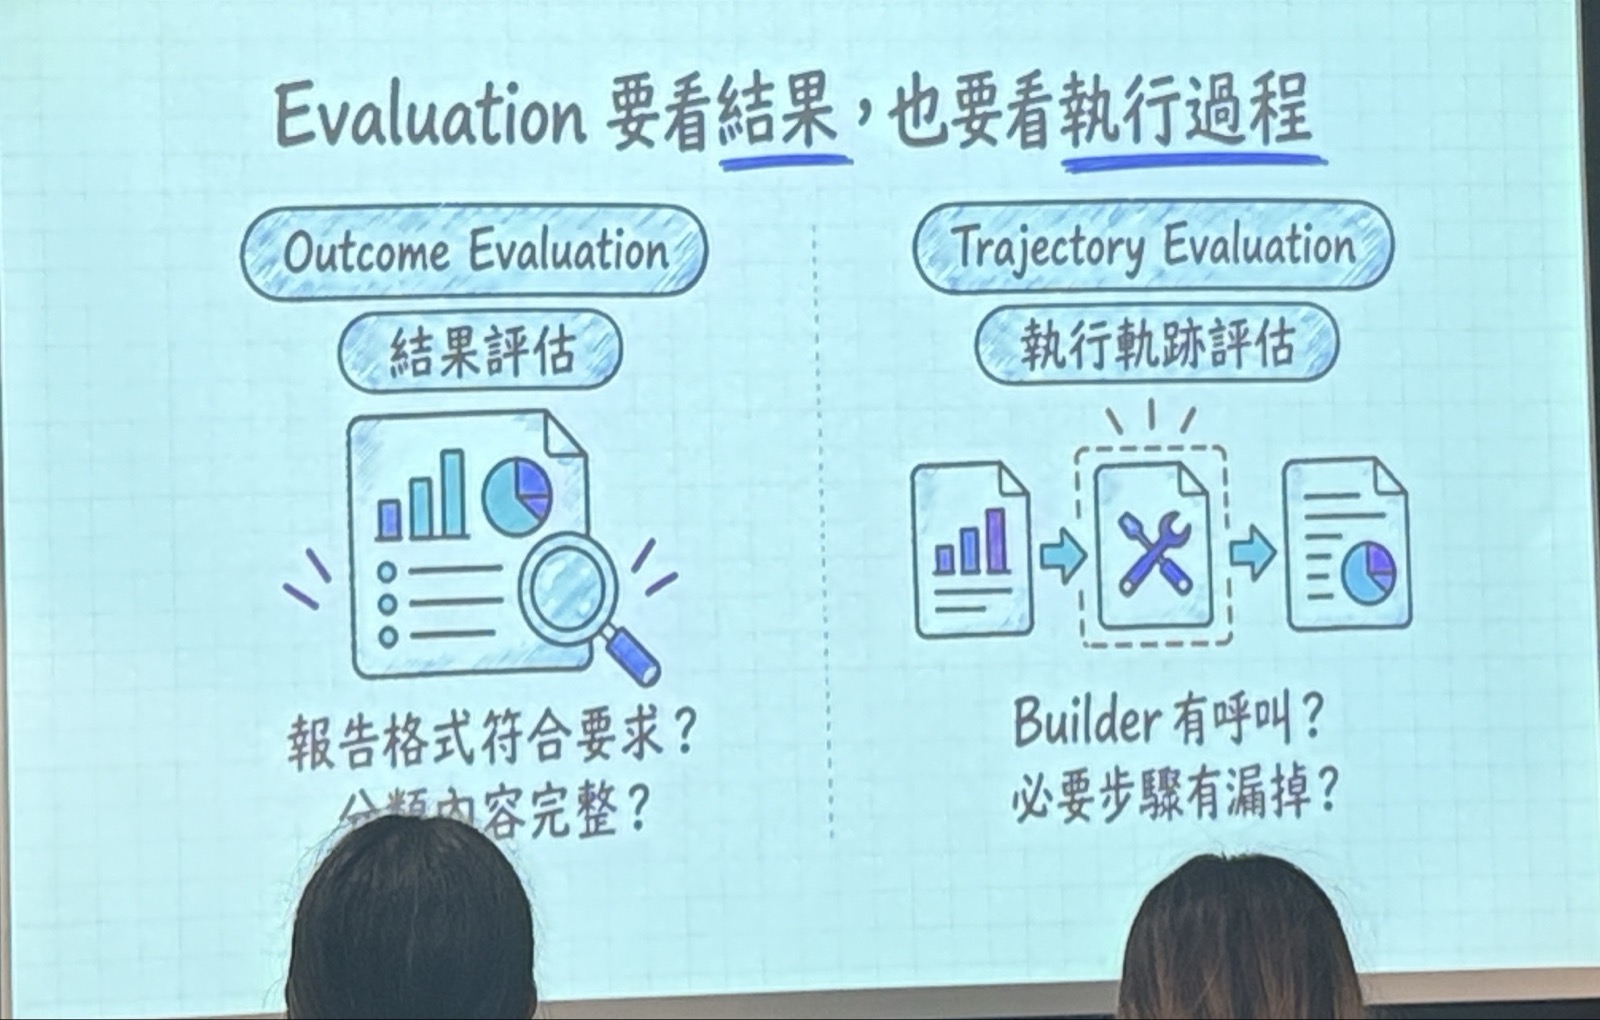
- 結果評測:確認報告是否產出、內容是否完整、格式是否符合交付要求。
- 軌跡評測:確認是否呼叫指定工具、工具呼叫順序與參數是否正確、是否遵守必要流程。
- LLM as a judge:以另一個模型判斷自由文本的品質與要求符合度,適合難以直接用程式規則判定的內容。
- 程式檢查:對工具紀錄、必要呼叫與明確軌跡規則進行驗證,可避免額外的 judge 模型費用。
- 固定 Skill、工具清單、模型設定與任務,多次重跑同一情境,以測量任務能力與穩定性。
LLM as a judge 的價值在於大規模測試:當需要檢查 100 或 200 次自由文本產出時,逐筆人工檢閱成本很高;另一個模型可協助打分或判斷。然而,工具軌跡這類明確條件更適合交由程式碼檢查。講者提醒,使用 judge 本身也有模型成本,應把它用在真正需要語意判斷的區域。
即使測試 100% 通過,也不等於線上永遠正確,因為 LLM 的輸出本質上仍具機率性。設計時應先做錯誤分級:若偶發錯誤只是逗號變句號,或許可透過 Skill 與 evaluation 降低發生率;若錯誤涉及退款判斷、權限、扣款或寫入,則一次也不能接受,必須以程式碼或 guardrail 阻擋。
- 日期區間計算等要求精確的邏輯,不應交由 LLM 心算,可交由 Tool 處理。
- 輸出結論必須可對應證據,避免模型補出未發生的因果關係。
- 權限不足不得放行;使用者身分與可執行動作應由程式碼驗證,而非由 LLM 判斷。
- 對資料寫入、扣款、通知等會影響資料或使用者的動作,需在執行前設置強制檢查。
evaluationevalsE2E測試LLM as a judgeguardrailPMss@kPMss^k回歸測試
錯誤防護與 Human In The Loop:先攔截,再重新確認
講者曾遇到 log 分析報告出現大量未發生事實:當 log 記錄有斷裂、因果關係不完整時,LLM 會「貼心」補成一個完整故事,但這個故事可能是幻覺。後續做法是要求正式報告中的每個結論都必須對應到 Tool Result 或 subAgent 的分析結果;若沒有可追溯來源,就不納入正式報告。這是一種以證據可追溯性壓低幻覺風險的 guardrail。
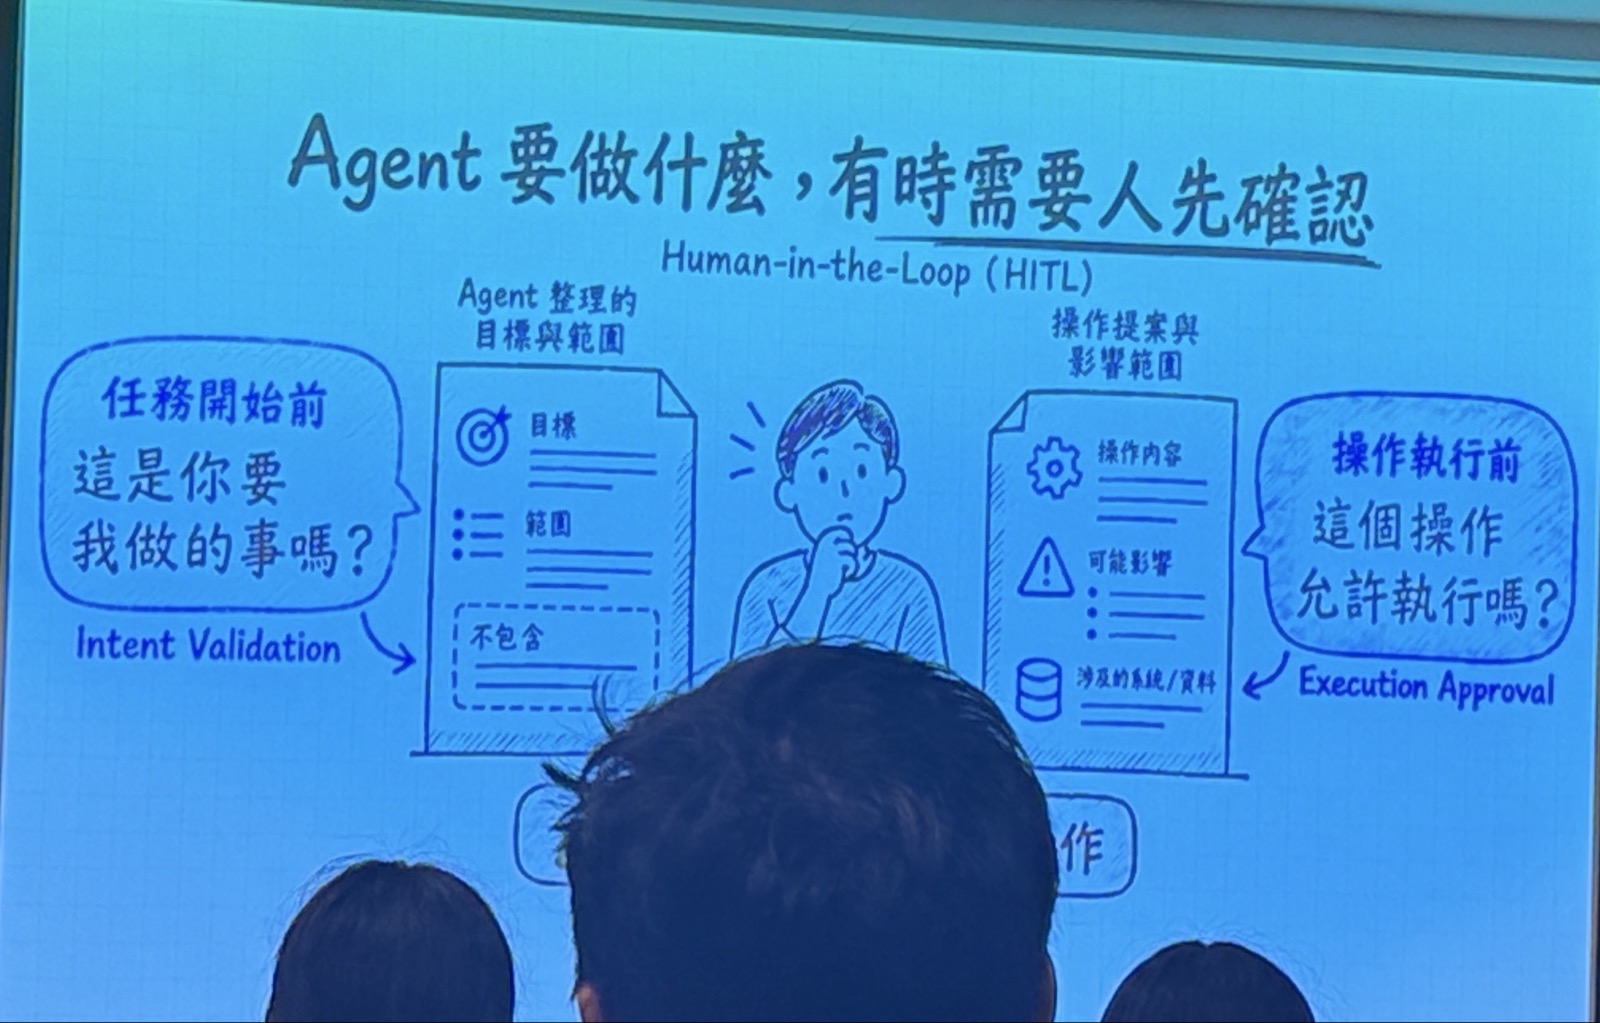
Human In The Loop 則將人工確認放在兩個關卡。第一,在執行前確認 Agent 對任務的理解是否正確,避免錯誤理解消耗大量 Token 後才發現方向偏離。第二,當 Agent 即將進行寫入、扣款、通知等影響資料或使用者的操作時,再次要求同意。這和 Codex、ChatGPT 常見的操作授權提示相似。
- 人工同意不是永久授權:等待確認期間,系統狀態可能改變。
- 在人按下同意後、真正執行前,仍要重新驗證當下狀態與條件。
- Human In The Loop 可降低錯誤理解與高影響操作的風險,但不能取代程式層的權限、狀態與資料檢查。
- 預防與追查必須並行;即使有確認與 guardrail,仍應假設偶發錯誤可能存在。
可追蹤性與回歸:無法重現時,更需要完整紀錄
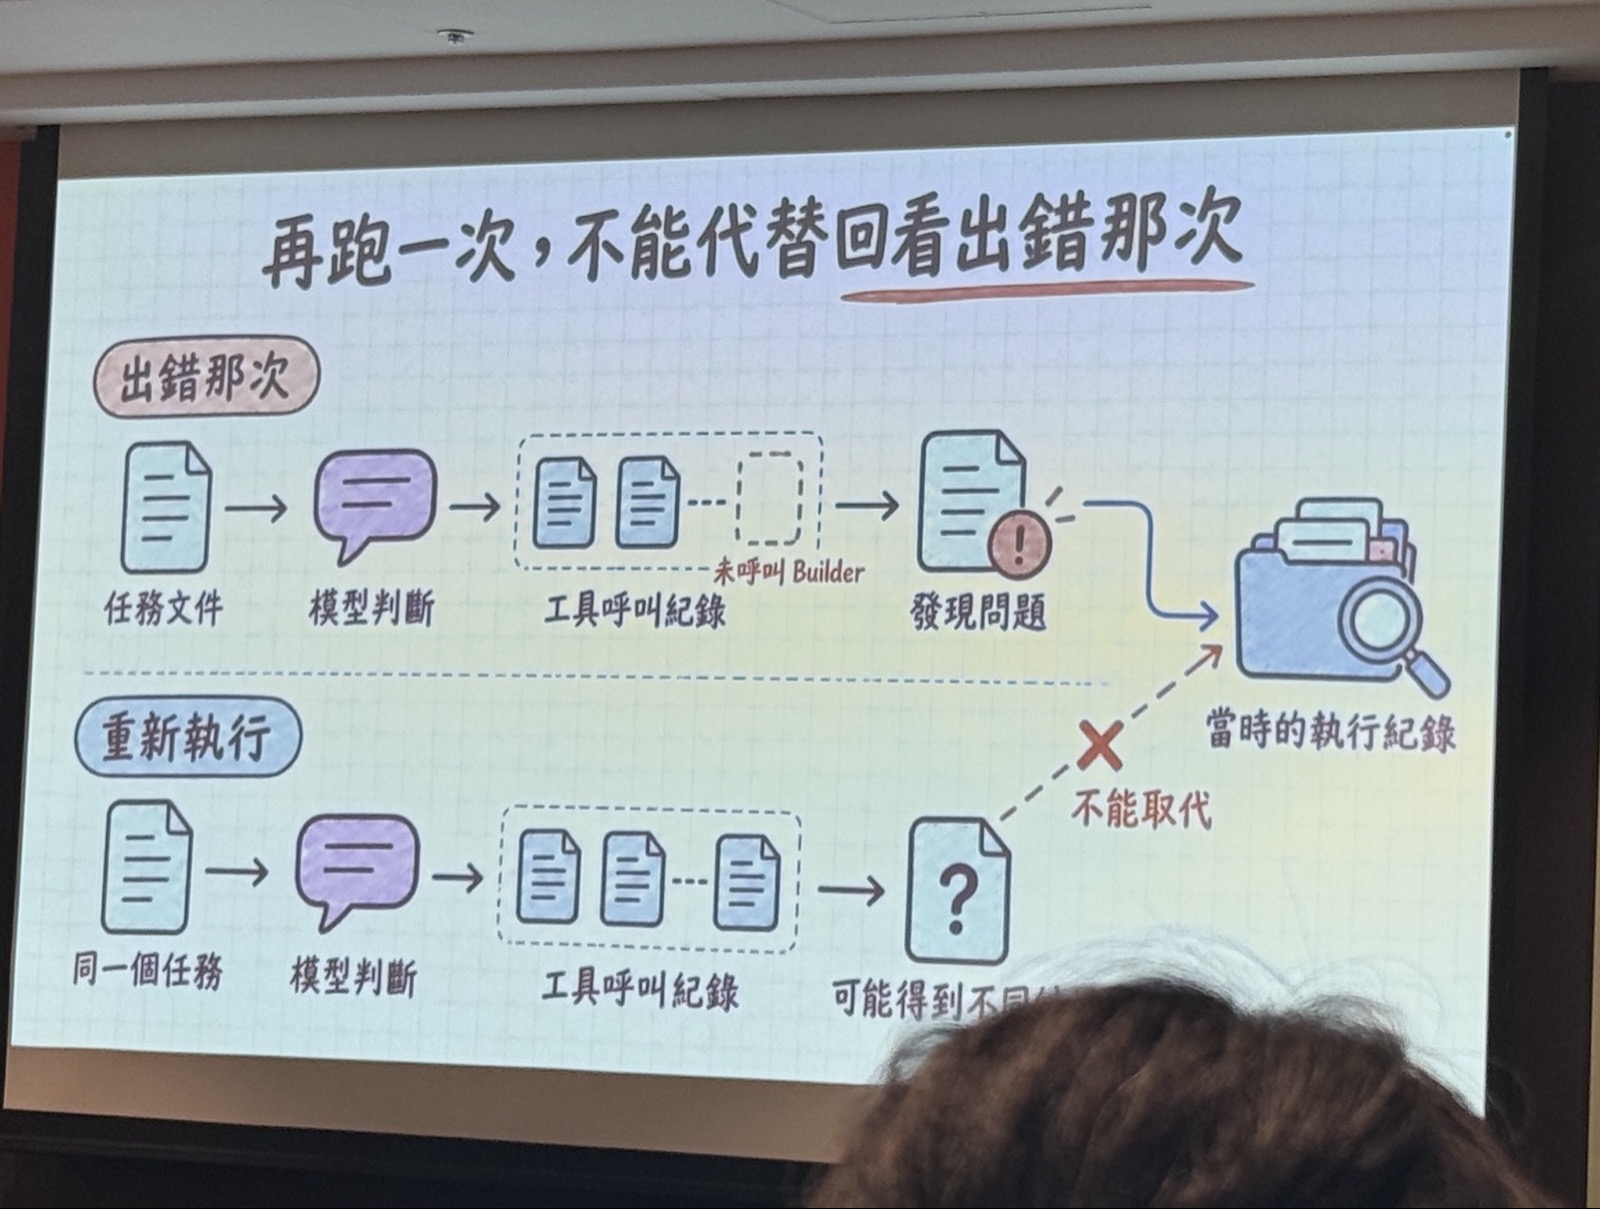
由於重新執行 Agent 未必會得到與失敗當次相同的結果,發生問題時不能只靠「再跑一次」。每一輪執行都應保存足以分析的資料,包括實際送給模型的 Context、模型回應、Tool Result、模型設定、Skill 版本與參數版本。這些資料讓團隊能回放當時的決策脈絡,確認是指令根本沒進入 Context、模型忽略了指令、工具沒被呼叫,或是程式整合層出錯。
這些執行紀錄也可交由 AI 協助分析,從中找出 Skill、prompt 或程式碼的問題;修正後再回到 evals 驗證。講者特別分享一個回歸陷阱:情境 A 原本失敗,調整共用 Skill 後 A 修好了,原本正常的情境 B 卻壞掉。原因是每輪推理帶入的是完整 Skill;即使只改了 A 相關的步驟,也可能改變模型對 B 相關步驟的整體理解。
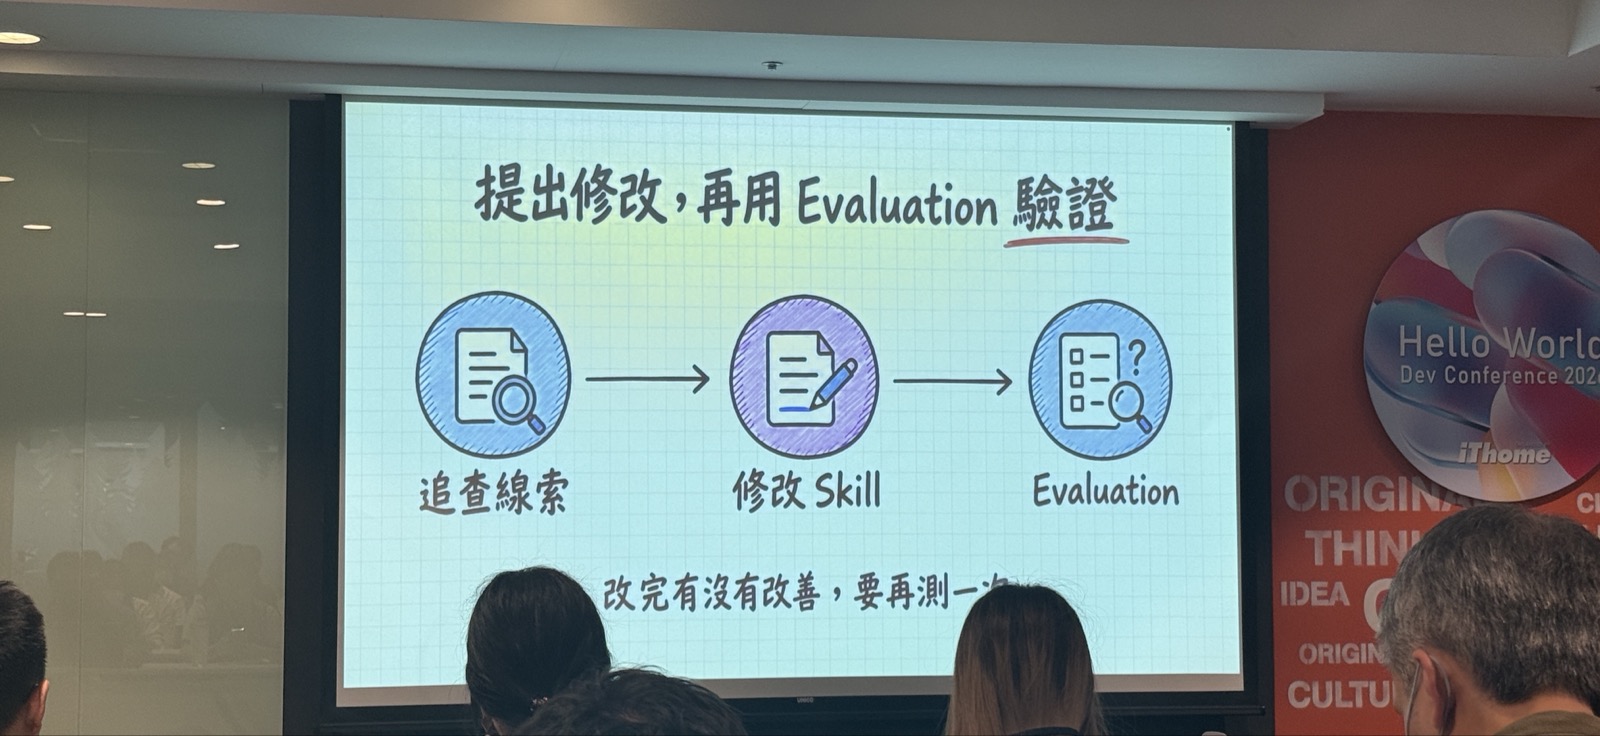
- 修正特定場景後,不只重跑該場景,也要重跑其他既有情境。
- 檢查 Agent 是否呼叫 builder,並確認傳入 builder 的資料是否正確。
- 以程式碼驗證參數、工具呼叫清單與固定規則;以 judge 檢驗輸出內容與格式。
- 將線上曾經發生的問題新增為 evals 場景,讓修復經驗轉化為未來的回歸防線。
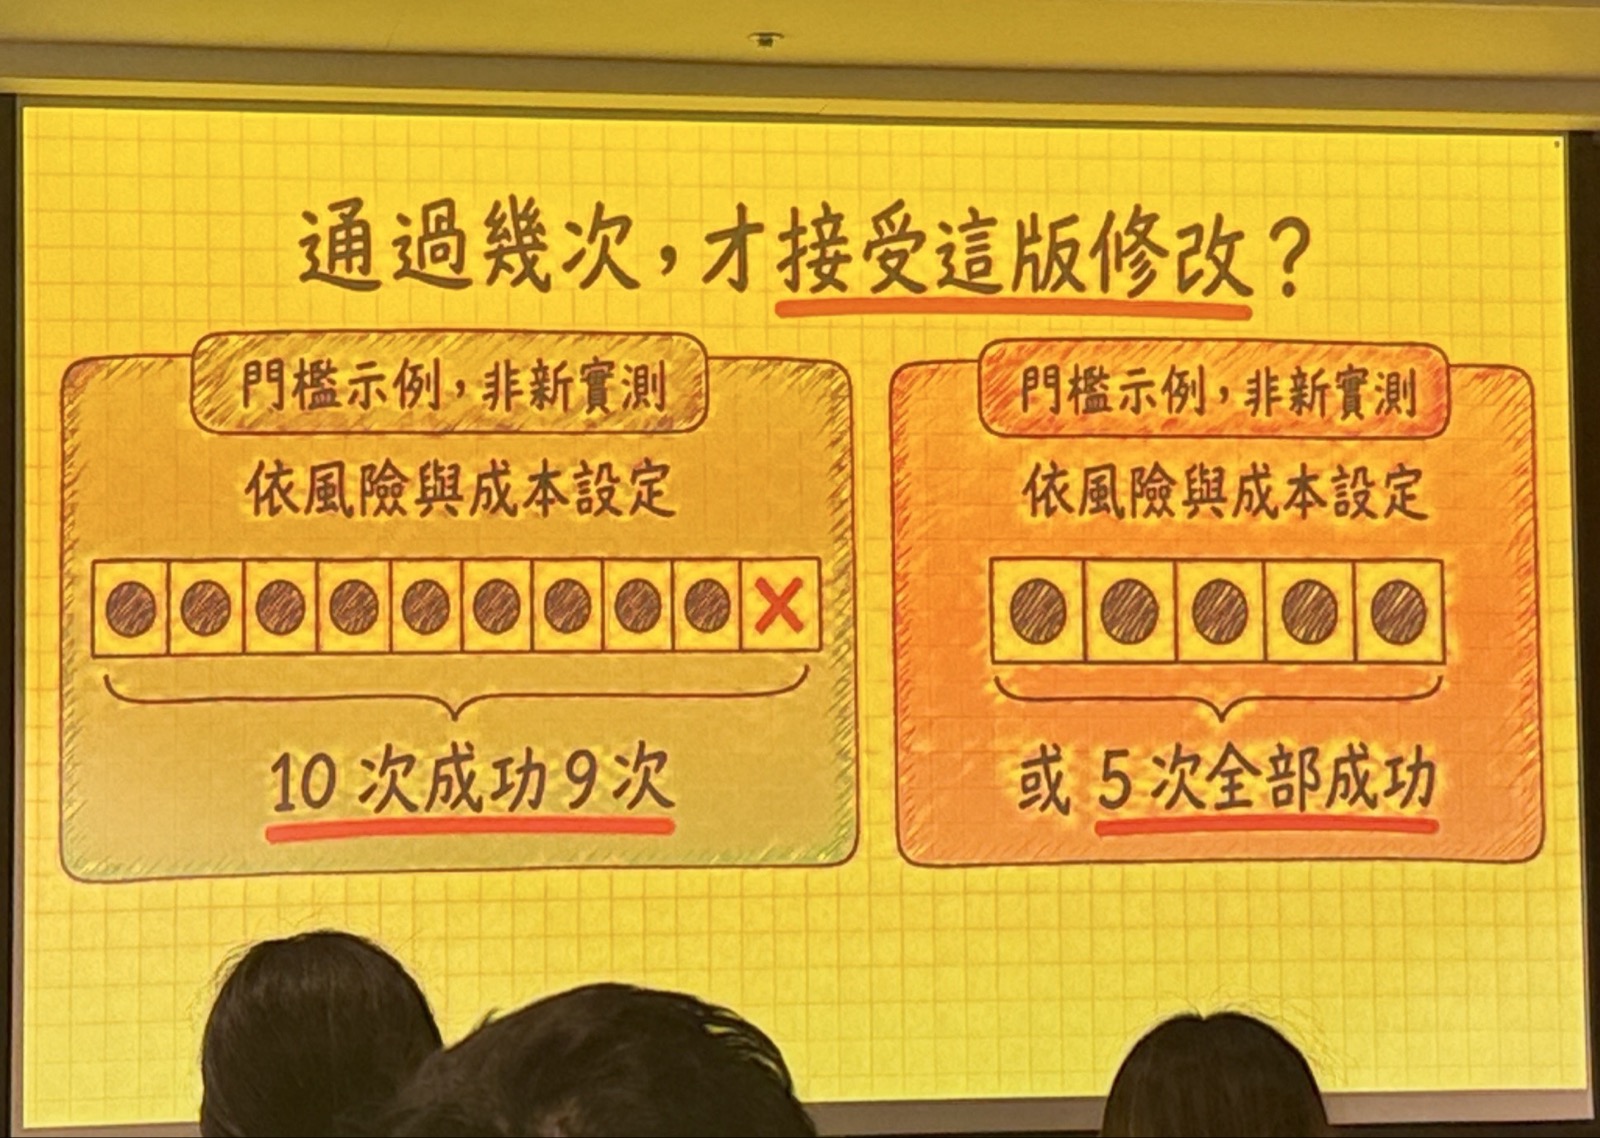
在重複測試的指標上,講者引用 Google 定義的 PMss@k 與 PMss^k:前者關心多次測試中是否至少成功一次,可用來看 Agent 是否具備完成能力;後者要求連續成功,用於檢驗穩定性。由於連續完全正確的門檻高,講者在實務上採用 10 次成功 9 次的 90% 標準,並人工檢視那一次失敗是否可接受。重點不在追求單次漂亮結果,而在用重跑次數與成功比例評估可上線程度。
用 AI 開發 Agent:人定義成功,AI 迭代 Skill
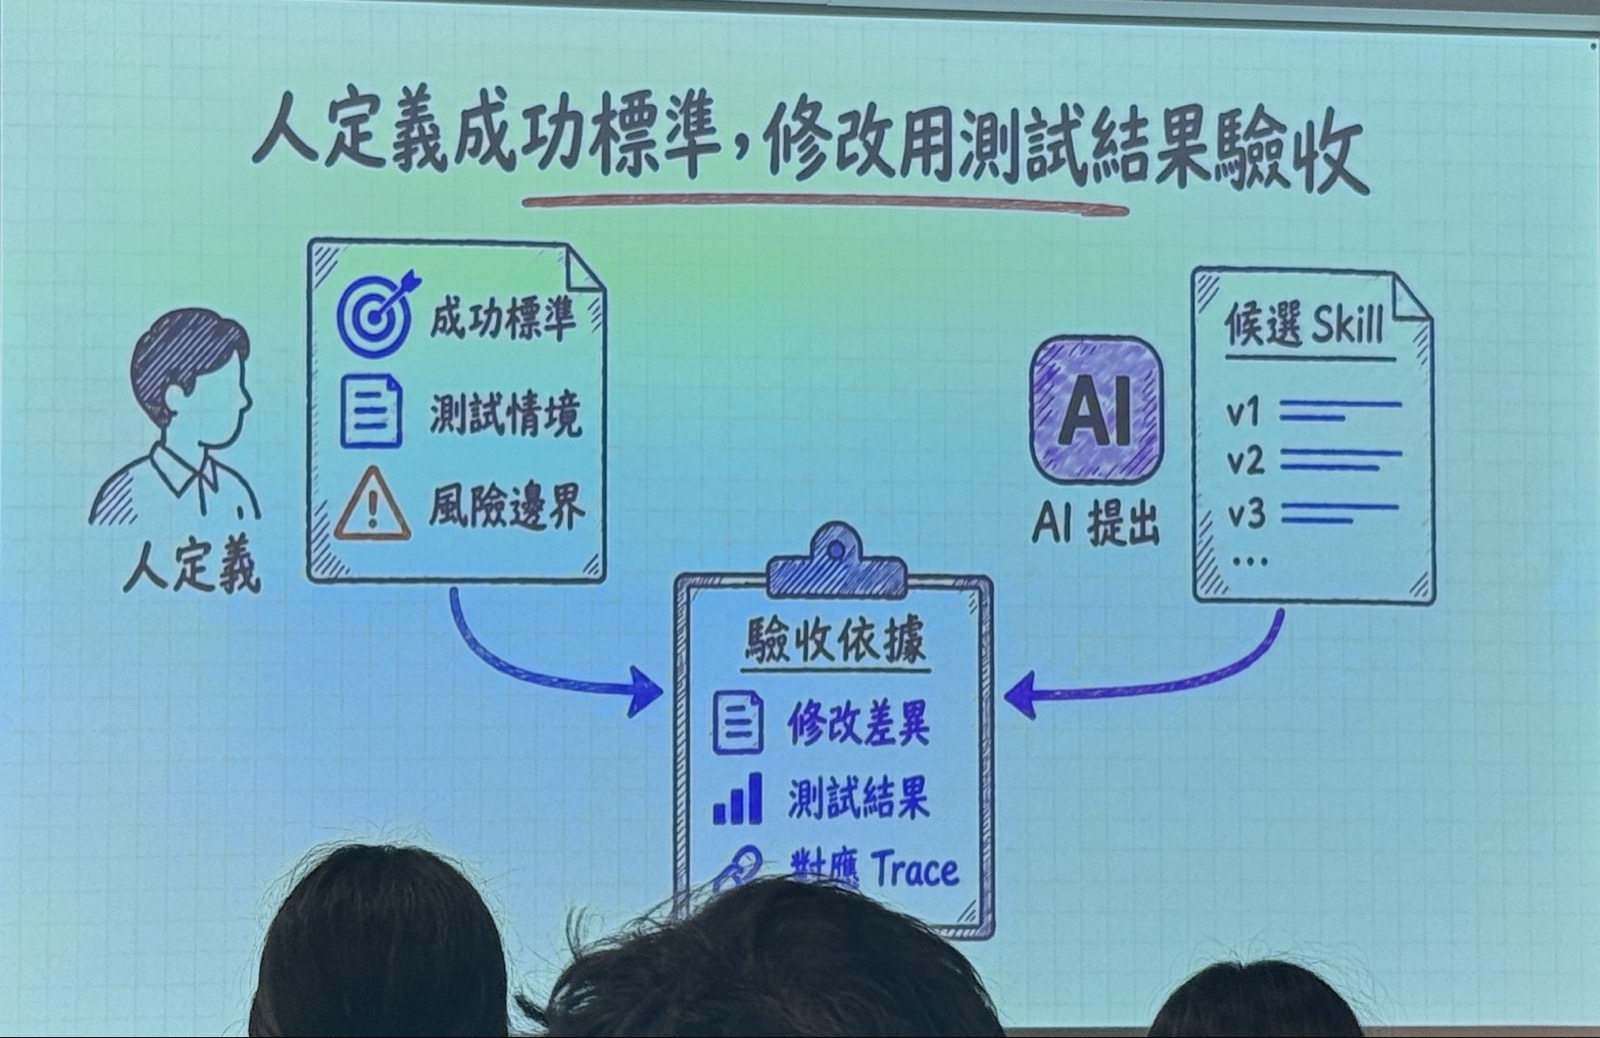
分享後段提出一個值得討論的開發方式:講者表示,從第一版 Skill 到功能完成,prompt 都由 AI 撰寫。人的工作不是逐字手寫 prompt,而是提供規格、SOP 與程式碼,定義成功標準;AI 產生 Skill,再由 evaluation 驗證。若測試失敗,就依紀錄找問題,把問題交回 AI 修改 Skill 或 prompt,反覆測試與分析,直到符合驗收條件。
這個做法的前提並不是取消工程判斷,而是把人的注意力從 prompt 措辭移到規格、驗收、錯誤分類與風險邊界。若成功標準不清楚,AI 寫出的 Skill 也沒有可靠的判定依據;若沒有 evals,即使某次結果看起來很好,也難以知道能否穩定交付。
成本紀錄與最後提醒:更聰明的模型也更昂貴
成本不應等到上線才估算。講者建議在每輪測試與修正過程中記錄 Token 成本,包含 Cache、非 Cache 與 Output Token。因為 evals 使用的是接近線上的設計資料,推理 Token 與成本通常也接近真實運行,因而能在上線前回答管理者:這個 Agent 大致需要多少費用。
最後,Jamis 將焦點拉回模型能力與成本的取捨。更聰明的模型或許能改善部分任務品質,但不能替代 Context 管理、流程驗證與 guardrail;而且高能力模型通常更昂貴。相較於把所有問題都交給模型能力升級,先把框架的資料邊界、驗收條件、追蹤能力與成本量測做好,才是讓 Agent 能被企業長期使用的工程基礎。這也是全場最具延展性的結論:Agent 的競爭不只在模型多聰明,更在系統能否以可接受成本持續正確地完成任務。
「模型會越來越聰明,但是你的口袋也越來越深。」
— Jamis Liao
重點回顧
- Agent POC 的 loop 很容易建立,但產品化難題在於資料、流程、可靠性、可觀測性與成本。
- Context 應採取最小必要資訊原則:完整資料留在系統端,模型只拿推理所需內容或 reference。
- Context 過大會同時傷害成本與流程遵循能力;先過濾上下文,再考慮升級模型。
- Agent 評測必須同時檢驗最終產出與執行軌跡,不能只看答案看起來是否合理。
- 可接受的機率性錯誤可用 Skill 與 evals 降低;不可接受的錯誤必須以程式碼與 guardrail 強制阻擋。
- 每輪都要留存 Context、回應、工具結果、模型與 Skill 版本,才能追查不可穩定重現的失敗。
- Skill 是整體推理的一部分,局部修正可能破壞其他情境,必須建立回歸測試集。
- 以 evals 驅動 AI 撰寫與修正 Skill 是可行工作流,但前提是人先定義清楚規格與成功標準。
- 將 Token 成本納入測試紀錄,才能在上線前建立可信的模型與營運成本估算。