于浩军談金融監管AI治理
TL;DR:在金融監管場景導入 AI,核心不是讓模型更會「自由發揮」,而是讓它能在明確口徑、受控資料與可稽核流程中穩定完成任務。中軟融鑫總工程師于浩军以 Harness 實踐說明:以知識底座與數據底座承接監管規則和業務事實,再結合權限、評測、審計、異常處理與血緣追溯,才能讓 Agent 的輸出可驗證、可解釋,也可在問題發生時回到源頭修復。
金融監管強監管AI治理與控管口徑漂移幻覺可解釋性知識底座數據底座數據血緣異常處理權限與審計Harness
從強監管出發:AI 要面對的是高後果的數據任務
講者將金融監管界定為金融機構依規定報送相關資訊、供監管審查的工作。這類工作以大量資料、指標與報表為基礎,資料處理並非只求效率,更要求結果能被檢查、重現與說明。換言之,金融監管中的 AI 比較像在軌道上行駛的列車:可以加速,但軌道、號誌與行車紀錄都不能缺席。
這也是本場分享的治理主軸。面對監管資料,系統需要把規則、資料來源、取數過程與輸出結果串成可管理的鏈路;若任一環節出現偏差,後續的報送、分析或複核都可能受到影響。
三個常見陷阱:口徑漂移、幻覺與不可解釋
講者特別點出金融監管 AI 的三個核心難題。第一是口徑漂移:同一項政策、指標或業務定義,在不同時間、不同人員或不同系統的解讀下可能產生差異,最後反映為資料結果不一致。第二是大模型可能依自身理解生成看似合理、實則不存在的內容。第三是不可解釋:若無法回答「這個數字為什麼是這個數」,就難以在監管場景中建立信任。
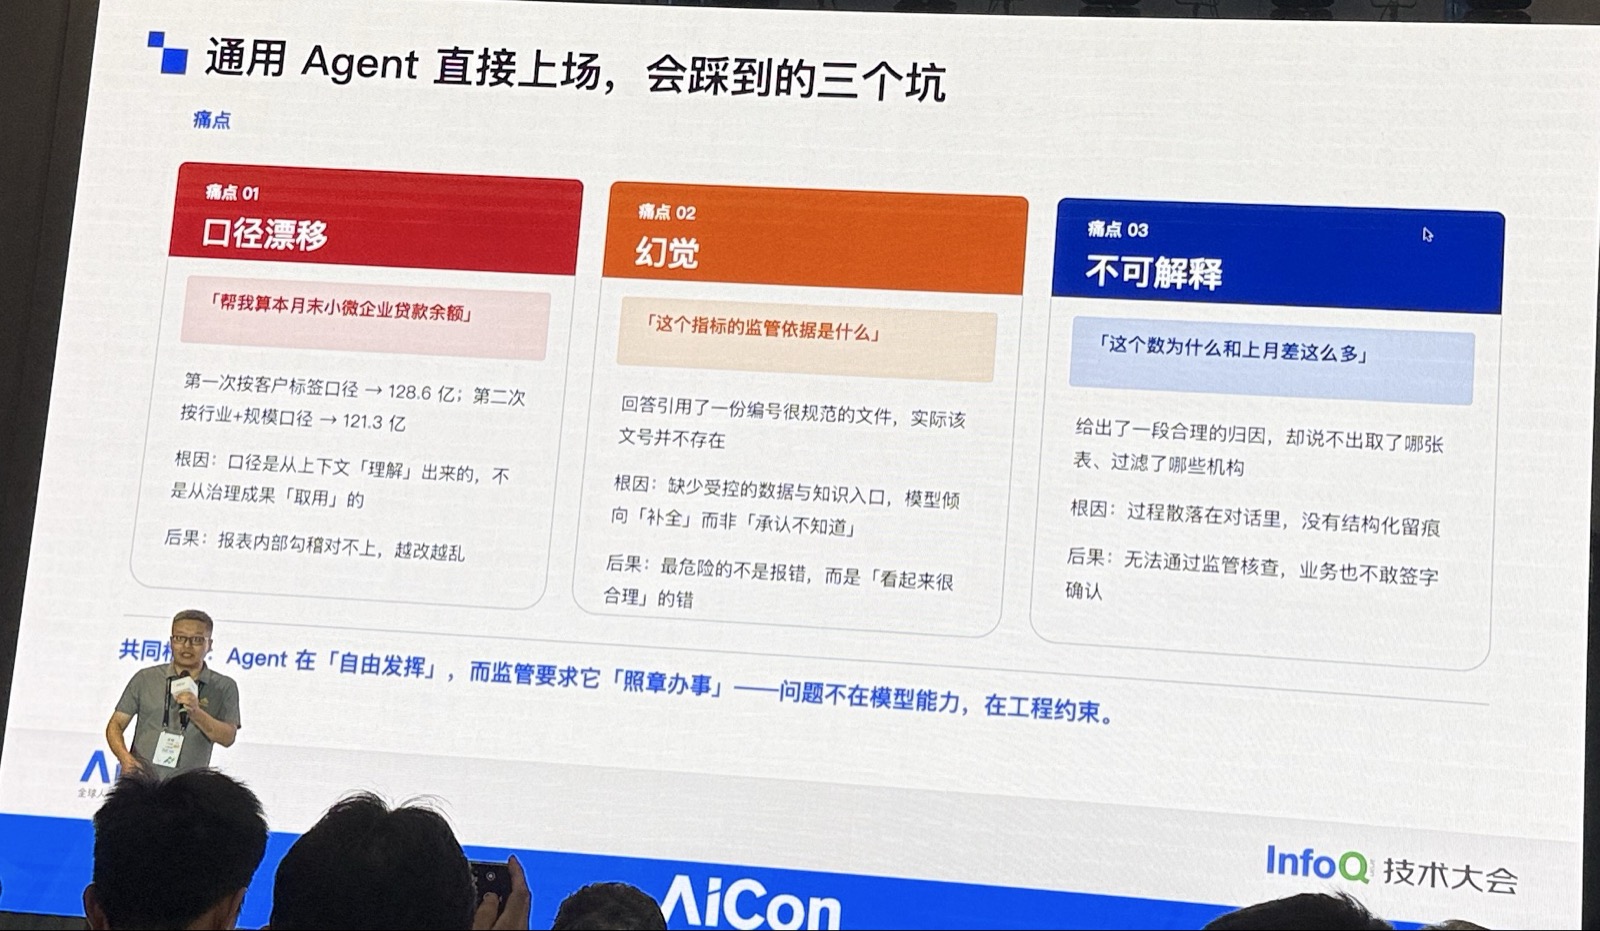
- 口徑漂移:規則或指標定義被不同方式理解,導致取數與計算結果分歧。
- 模型幻覺:模型可能「一本正經地胡說八道」,產生未被規則或事實支持的內容。
- 不可解釋:輸出若不能回應資料來源、計算規則與採用理由,便難以通過監管檢視。
- 一致性風險:同一口徑與同一資料條件下,系統應產出一致結果,而非每次重新推測。
「就是一本正經的胡說八道的內容。」
— 于浩军
「它的自由發揮在監管場景下,只能要求它能夠照章辦事。」
— 于浩军
治理原則:讓 Agent 受控,而非任意發揮
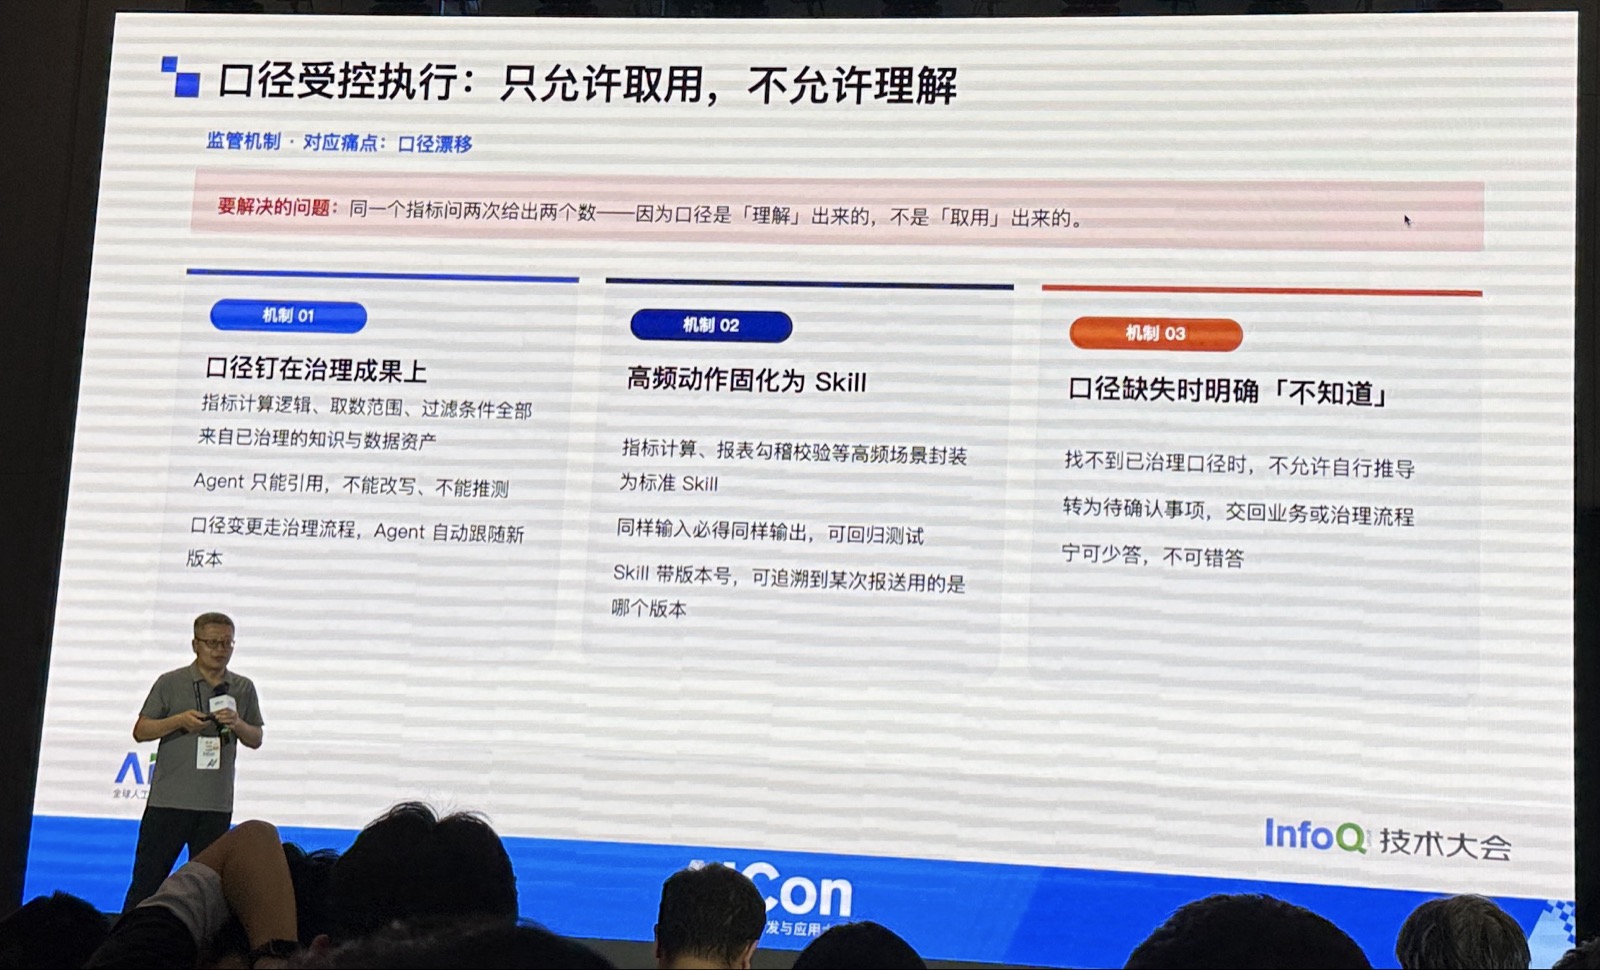
講者的立場很清楚:監管場景並不追求讓 AI 無限制地自行推論,而是要在已定義的規則、資料與權限範圍中執行。這不代表完全排除 AI 的能力,而是把它的能力放進可驗證的作業邊界:能查規則、能取資料、能做檢核、能提出建議,但不應自行改寫口徑或越過授權範圍。
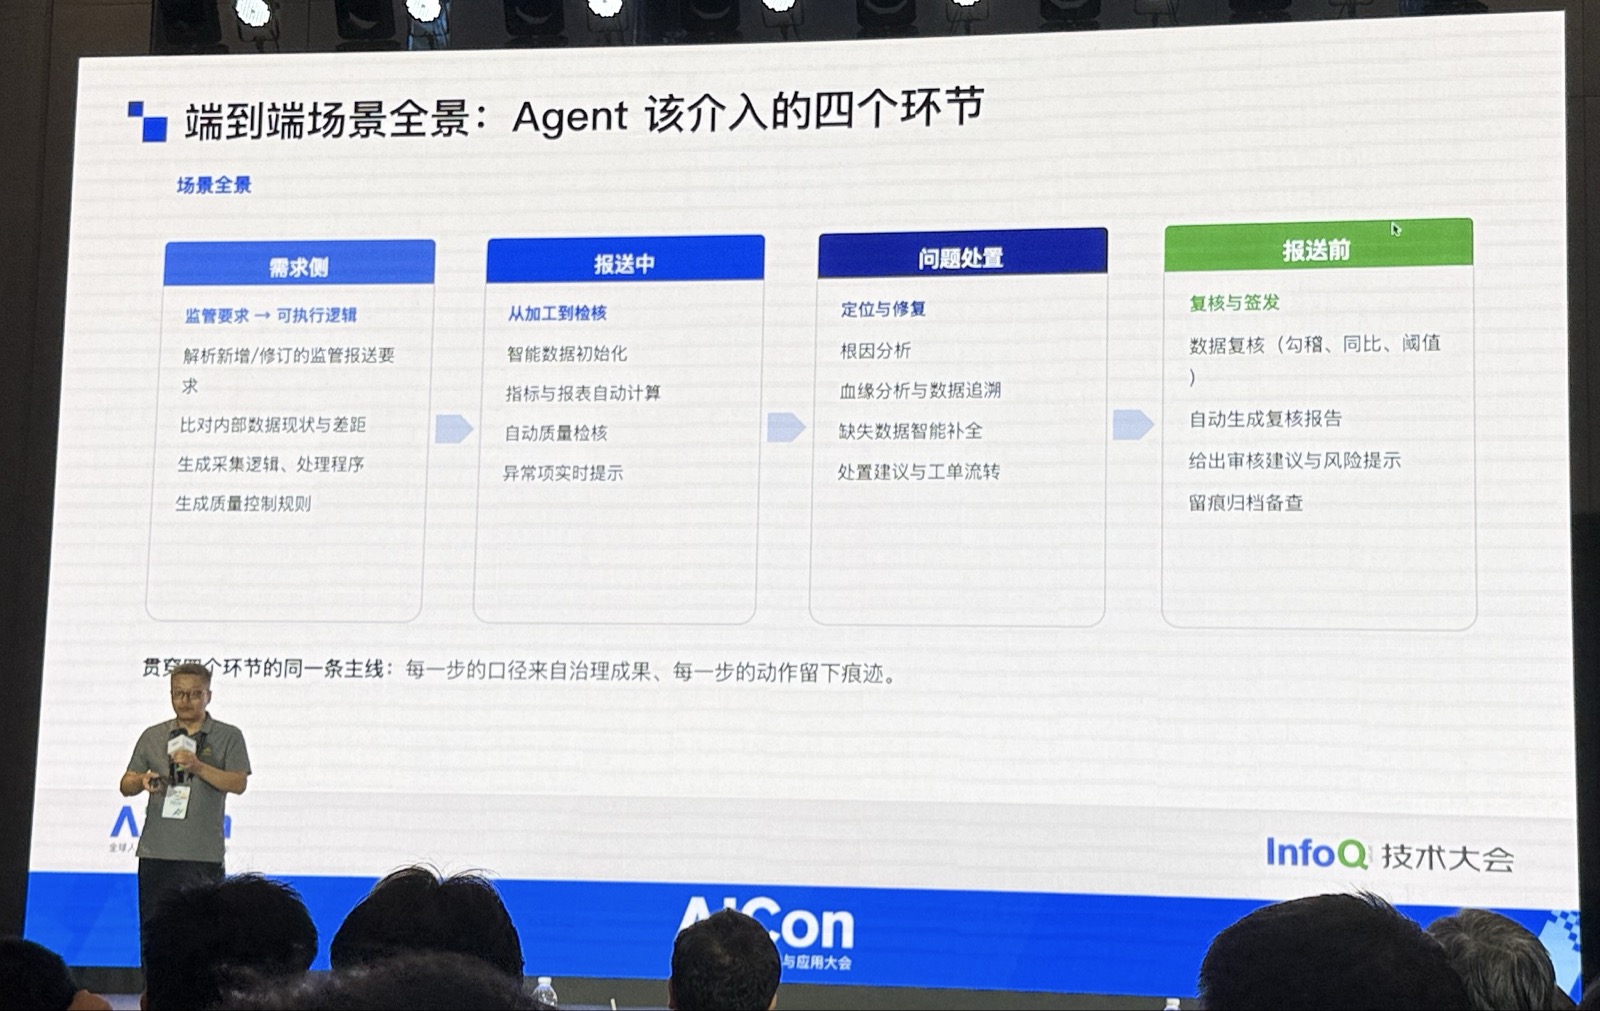
對於處理中發現的錯誤,分享提出「定位、修復、分析、追溯」的閉環。資料血緣與追溯不是額外報表,而是讓團隊能沿著資料加工路徑找出問題位置、評估變更影響,並對後續結果進行修正的重要能力。講者也坦言,業界要把追溯與血緣做到非常完整並不容易,因此需要持續建設。
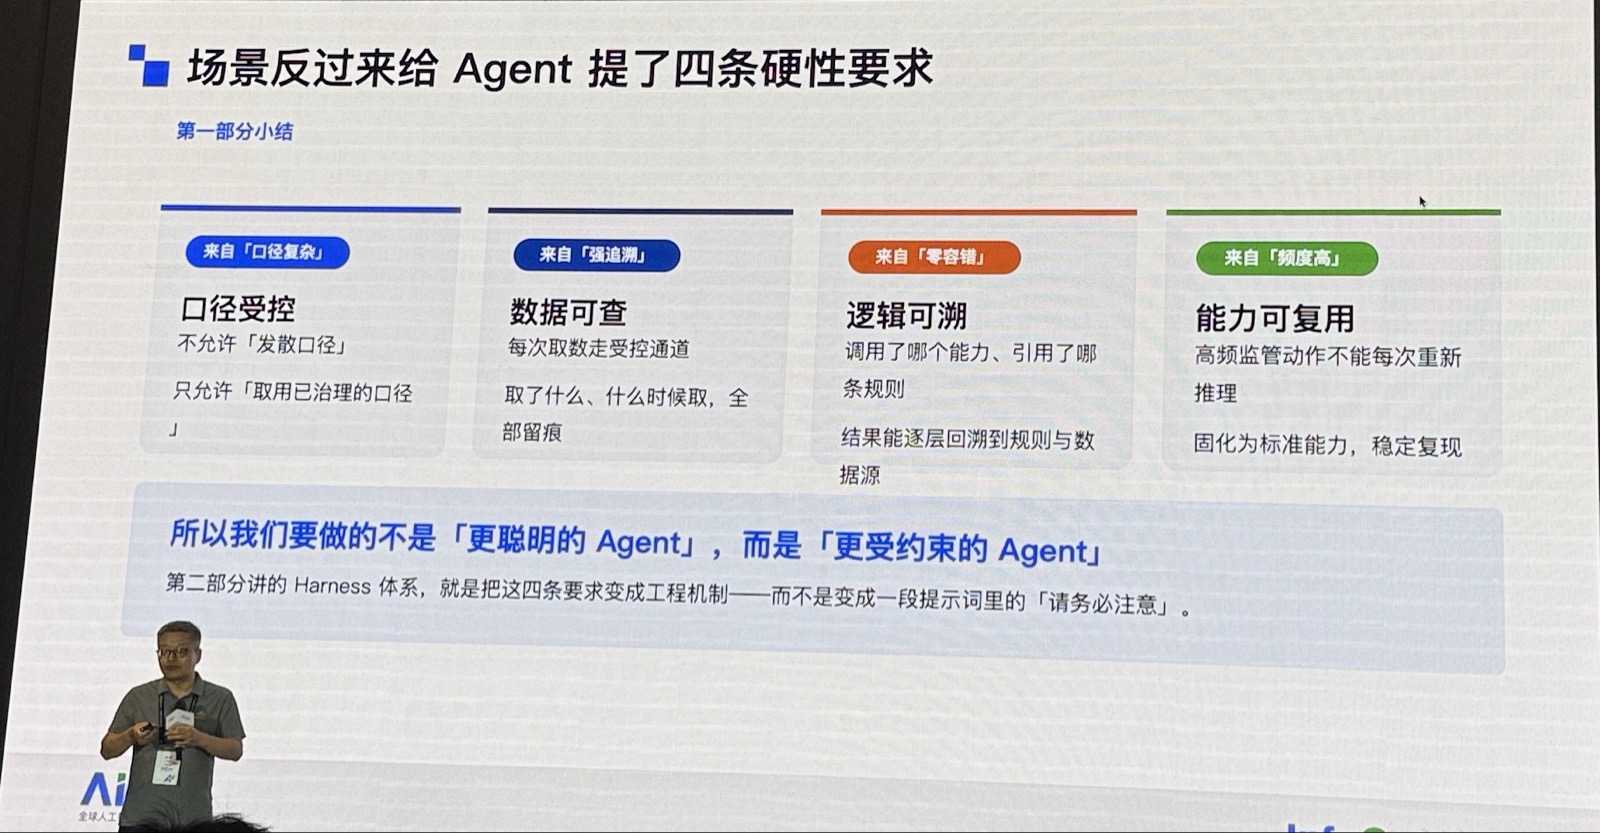
Harness 架構:以知識與數據雙底座支撐 Agent
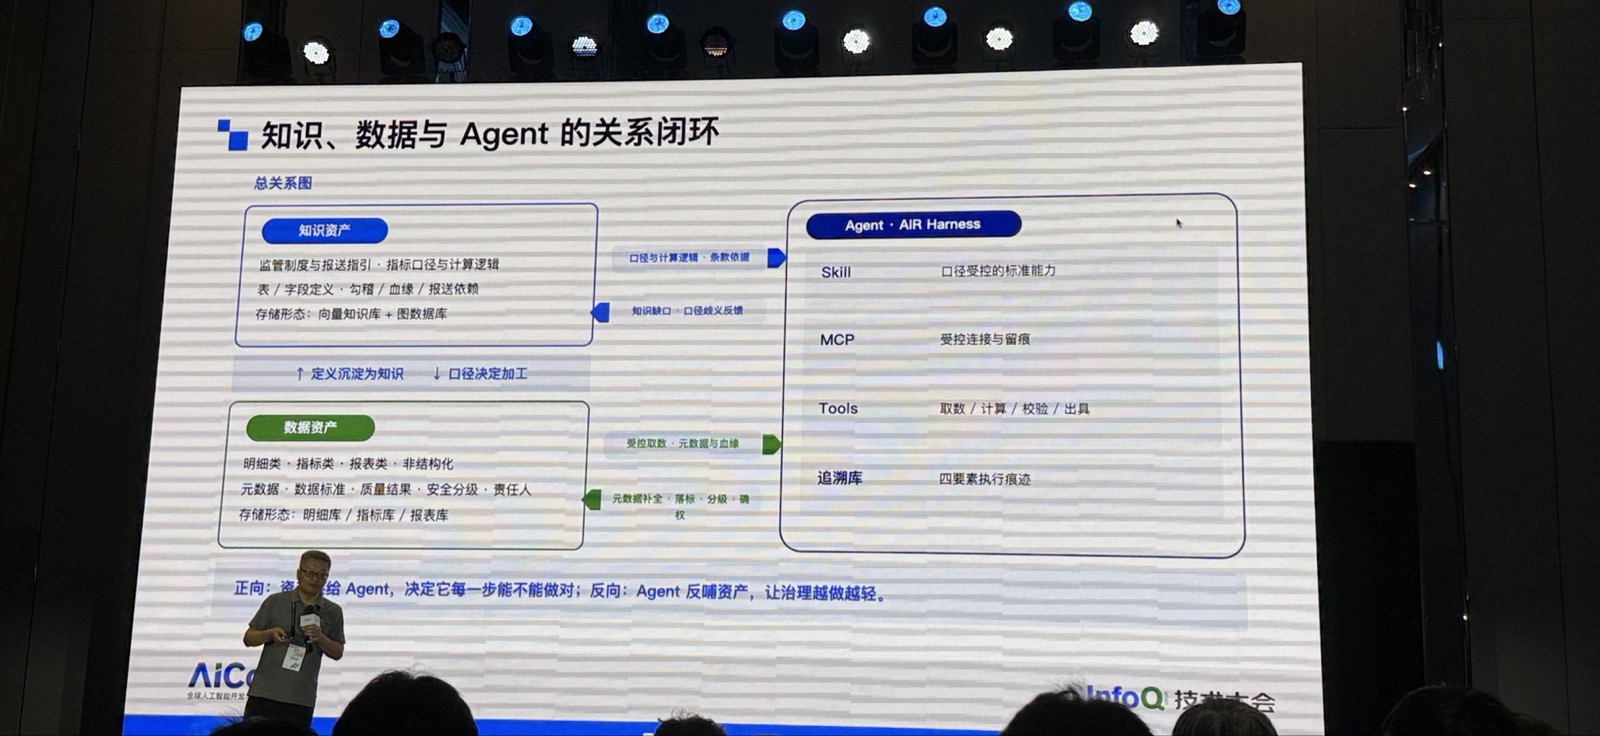
為了落實上述目標,講者介紹自主研發的 Harness 架構,並將其核心概括為知識底座與數據底座。前者用來沉澱監管機構發布的規範、制度、指標口徑、業務規則與流程等內容;後者則承接監管事實、業務資料、指標資料及可供分析的資料資產。兩者分工如同「法規與帳本」:知識底座回答應如何做,數據底座回答事實上發生了什麼。
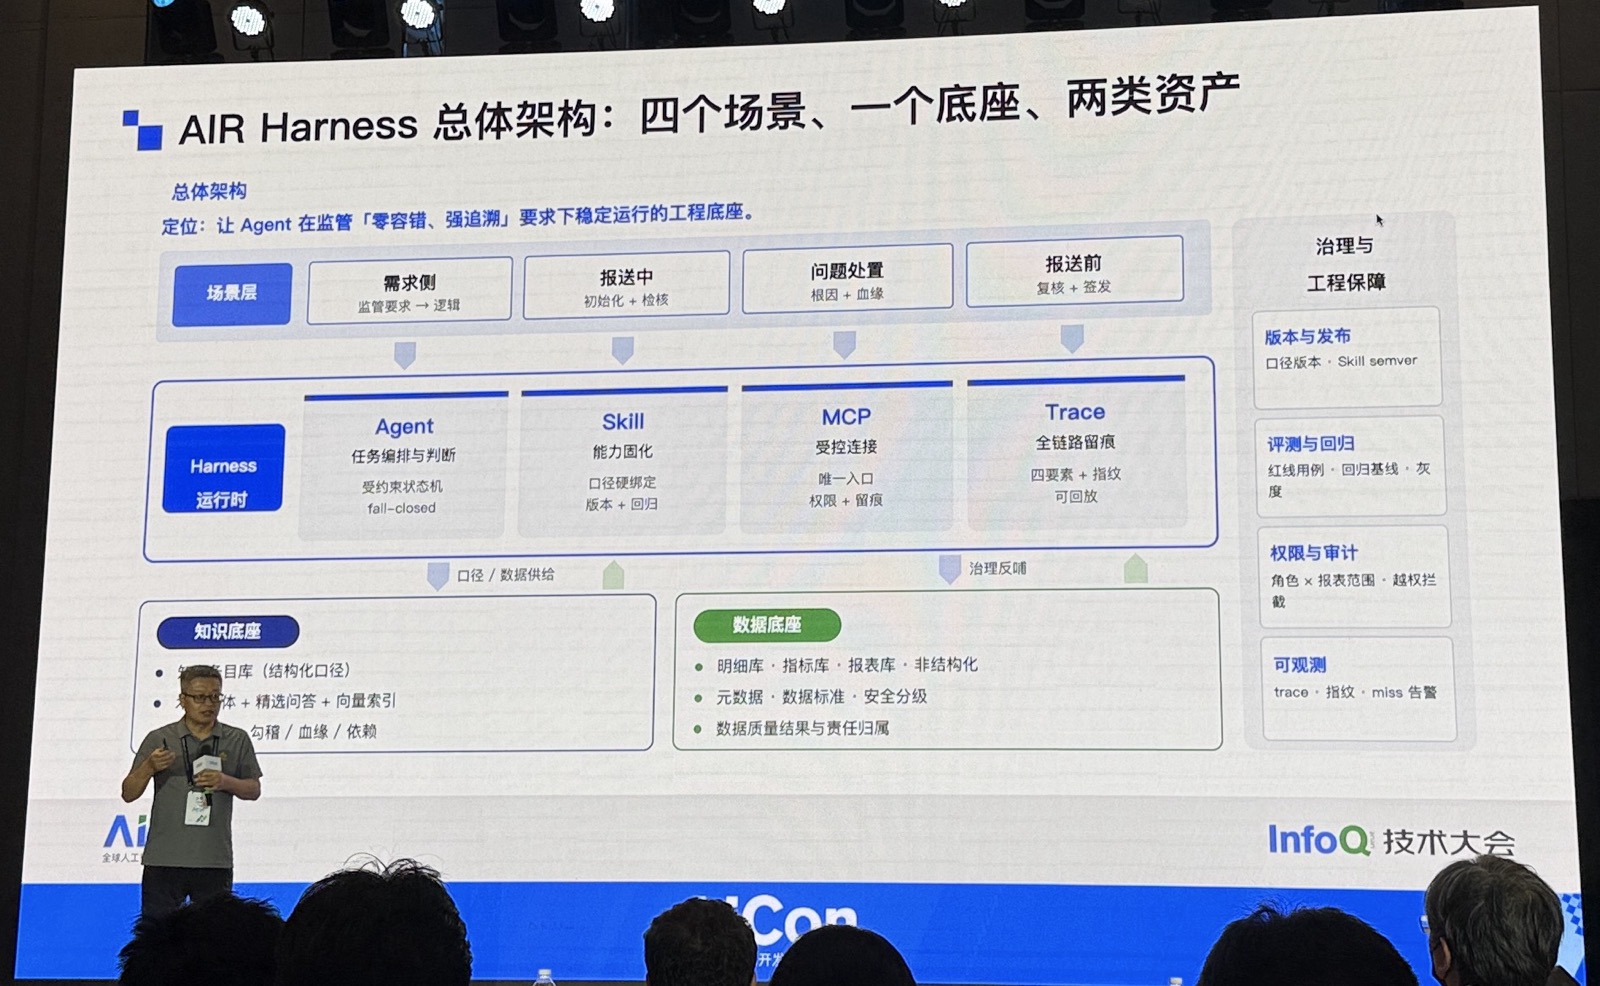
- 知識底座:彙整制度、政策、監管口徑、業務規範與流程,並對知識內容進行選擇與組織。
- 數據底座:保存原始資料、指標資料與可分析資料,作為計算、檢核與事實比對的依據。
- 事實導向:系統須以可取得的資料和明確規則為依據,避免只靠模型語言能力推測結論。
- 安全分析:資料使用需兼顧資料安全與可分析性,並與企業及銀行使用者的需求結合。
把控管做進運行:權限、評測、審計與回歸
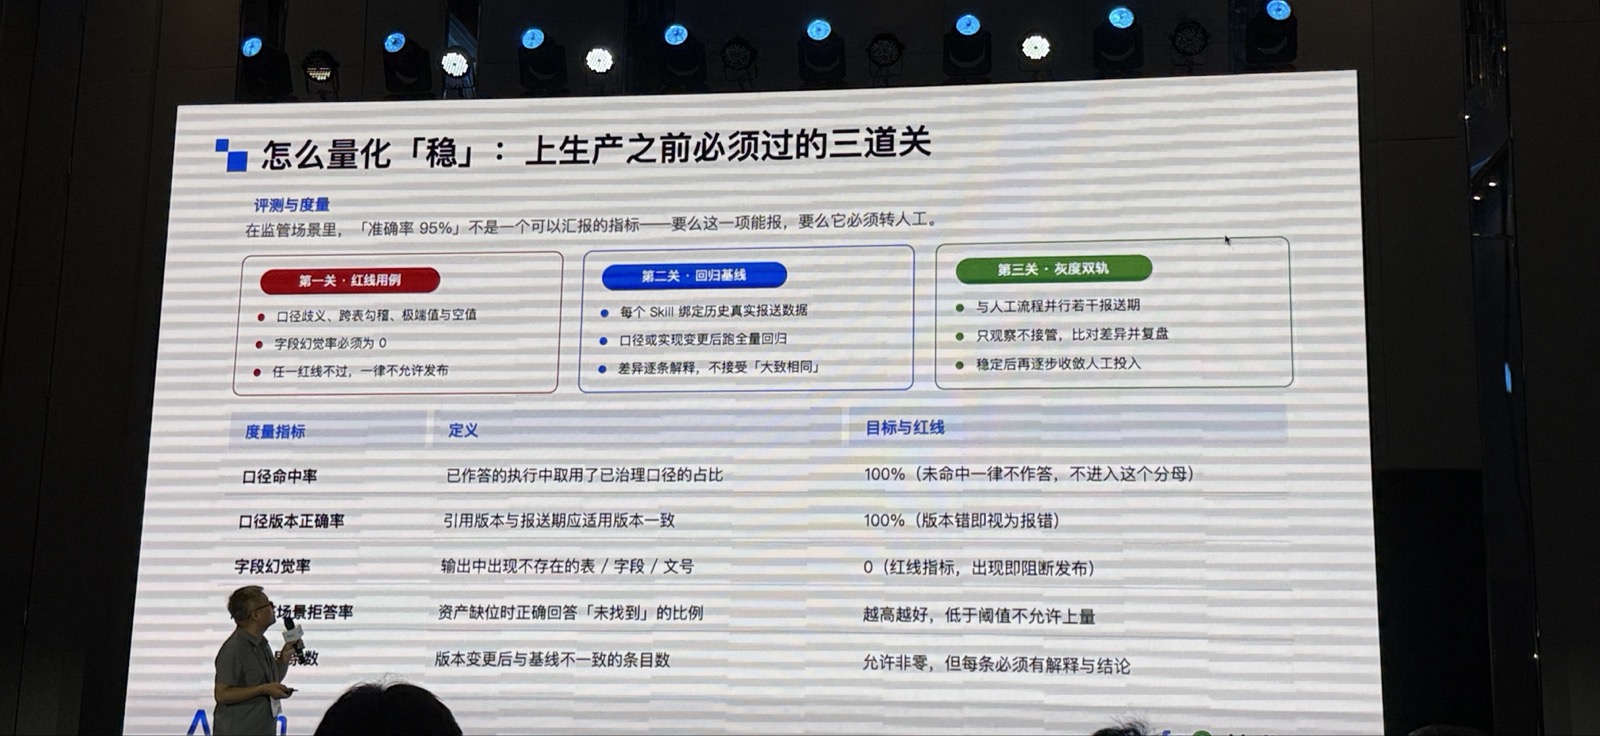
講者指出,底座之上還需要持續運行的治理機制。首先是權限與分工:以控制規則限制 Agent 可操作的方向與範圍。其次是評測與回歸:當知識、資料或流程調整時,需透過測試確認既有能力沒有被破壞。最後是運行後審計:定期檢視其執行與合作過程,辨識是否發生不應出現的異常。
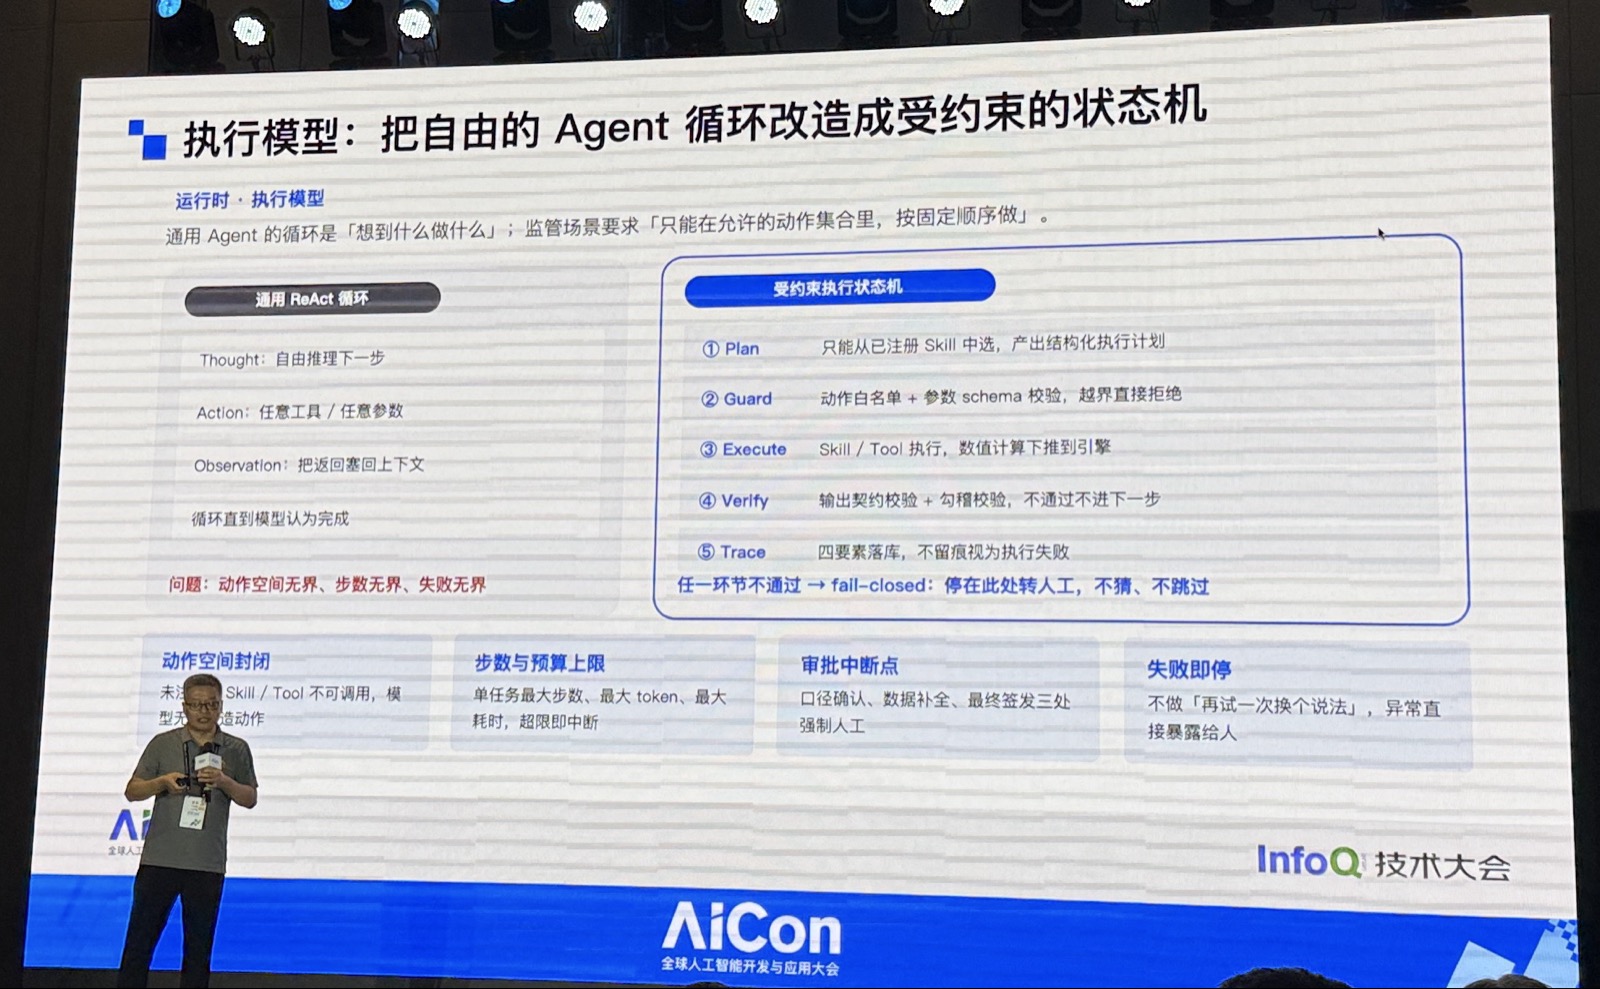
- 以權限與規則約束 Agent 的操作範圍,避免跨越既定任務邊界。
- 以測試、評測與回歸機制檢驗知識或流程變動後的穩定性。
- 以審計單元回看運行紀錄,針對異常行為進行辨識與處置。
- 對高成本或不合理的運行狀況設置提示與限制,避免資源使用失控。
從任務拆解到複核報告:異常處理的閉環
在具體流程上,講者描述了由任務拆解、規則與知識檢索、取數、資料檢核到異常處理與複核輸出的路徑。先把接到的需求拆成報表項目與清單,再依口徑描述連結知識底座與資料來源;資料取得後,透過關聯、差異或合理性檢查尋找問題。若發現異常,便轉入圖譜、規則文件與相關資料的比對,以協助定位原因。
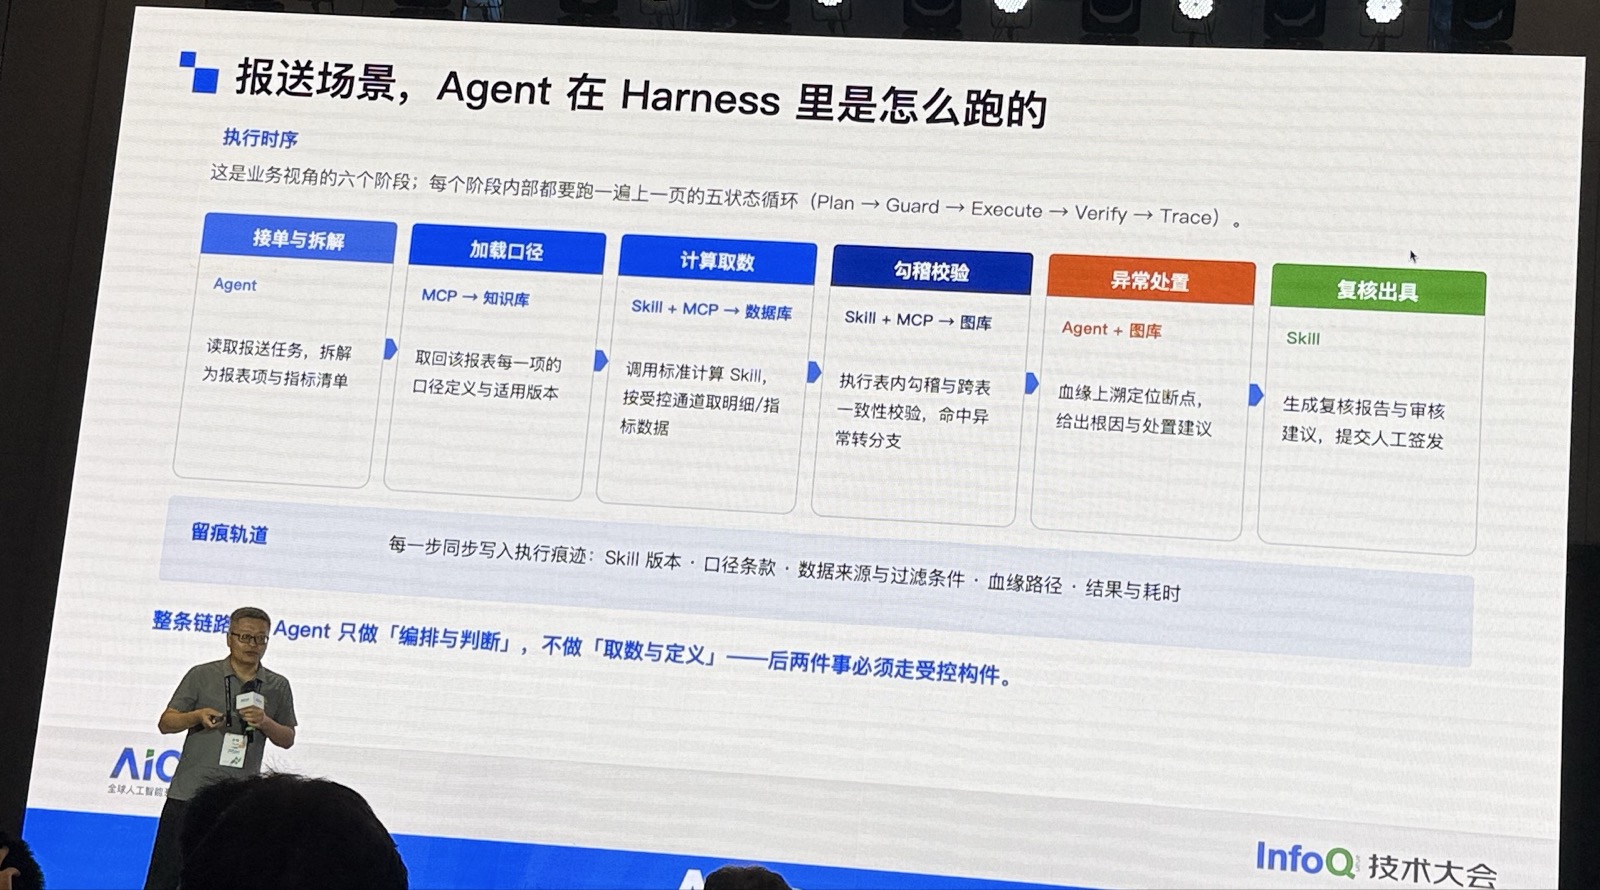
重要的是,異常不等於立刻判定資料錯誤。講者提到,系統需要進一步辨別問題來自原始材料、資料加工、取數規則或口徑理解,並在完成處理後生成複核報告。報告應呈現異常指標、處理結果與相應說明,使結果能被後續人員檢視,而非只留下單一結論。
數據與事實:可追溯性是監管輸出的共同語言
監管資料處理的可追溯性,涵蓋的不只是資料表之間的關係,也包含取數 SQL 或其他取數方式、規則版本、口徑變動、加工步驟與輸出理由。當指標或規則變更時,團隊需要能分析影響範圍;當結果被質疑時,則需要能回望整個取數和計算過程。這讓「數據」不只是一個結果,而是具備來龍去脈的事實鏈。
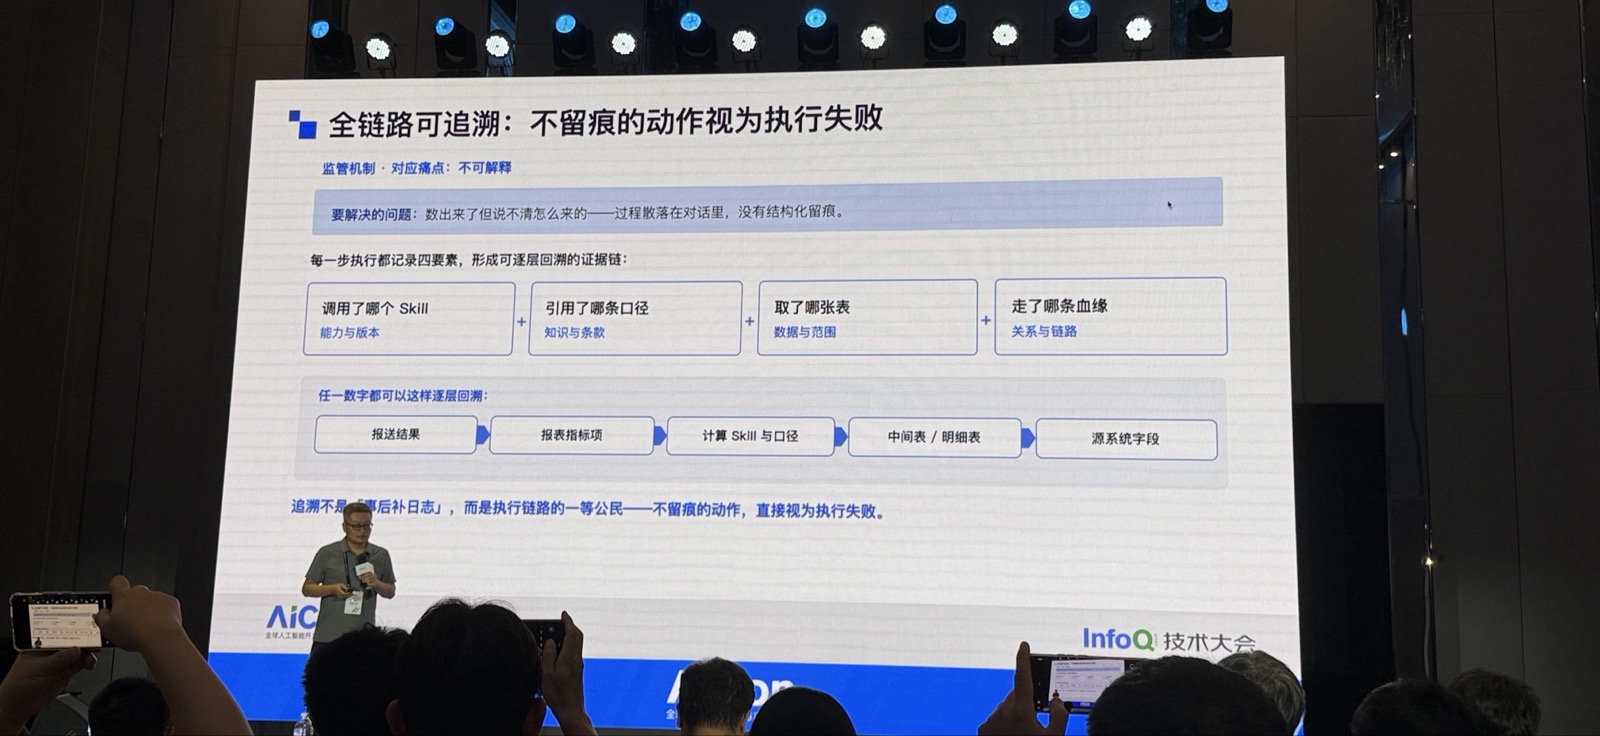
- 血緣分析:重建資料如何從來源經過加工、計算而形成指標或報表。
- 根因分析:當發現結果異常時,協助判斷問題是否源自原始資料、加工過程、規則或口徑。
- 影響分析:當監管體系、指標或資料邏輯變更時,評估其對下游結果的影響。
- 取數回望:讓複核報告、校驗報告與處置建議都能對應回原始取數過程。
結構化知識與版本管理:對抗口徑漂移
分享後段再次回到口徑漂移。講者提出,監管相關文件、規則與知識需要以結構化方式管理,並保留版本與指向關係。對 AI 而言,口徑不是可以隨語意自行補全的模糊描述,而是必須被明確引用、核對與執行的依據。這種做法可降低不同人員、不同時間或不同模型版本對同一問題產生不同解讀的風險。
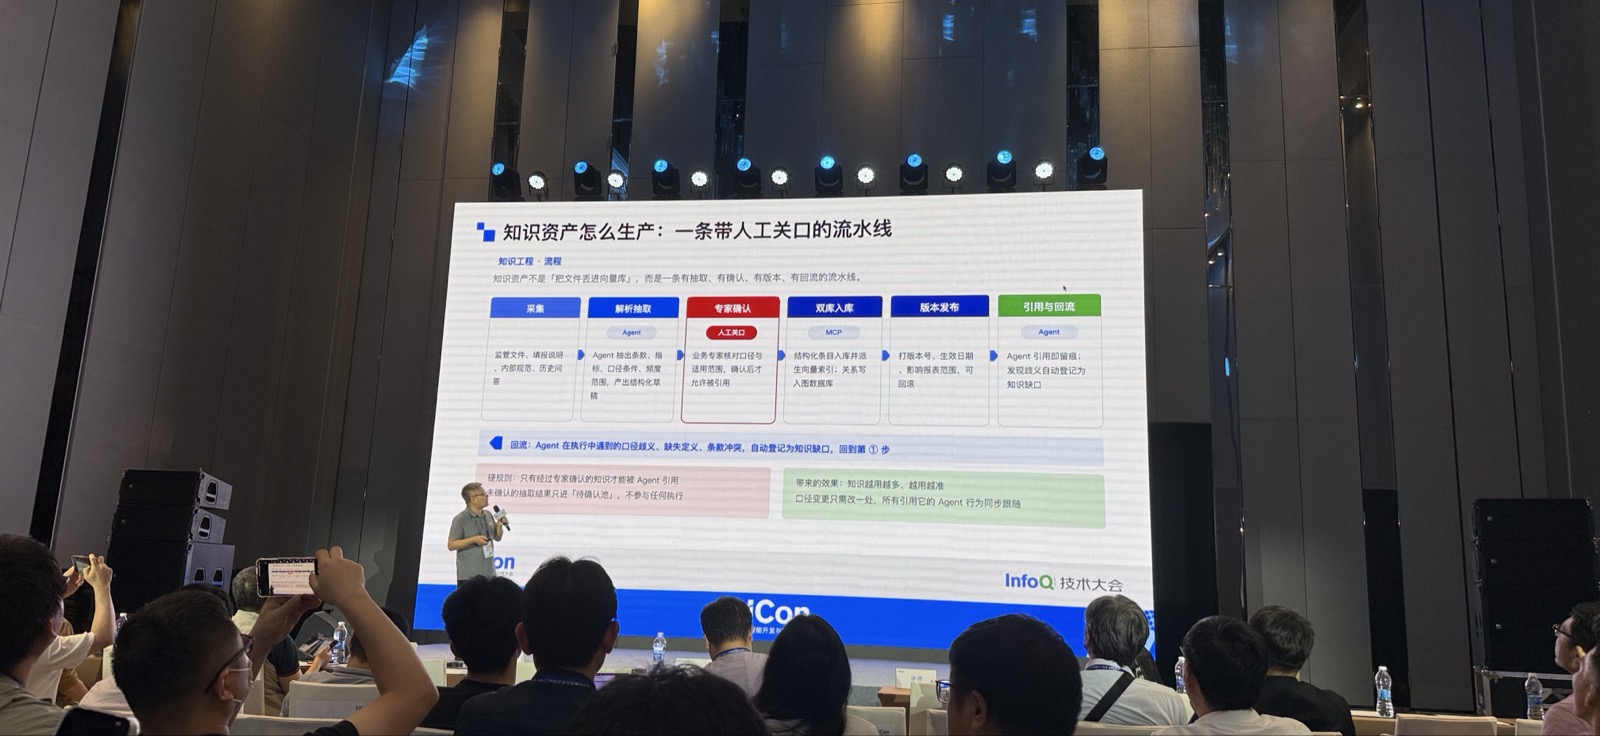
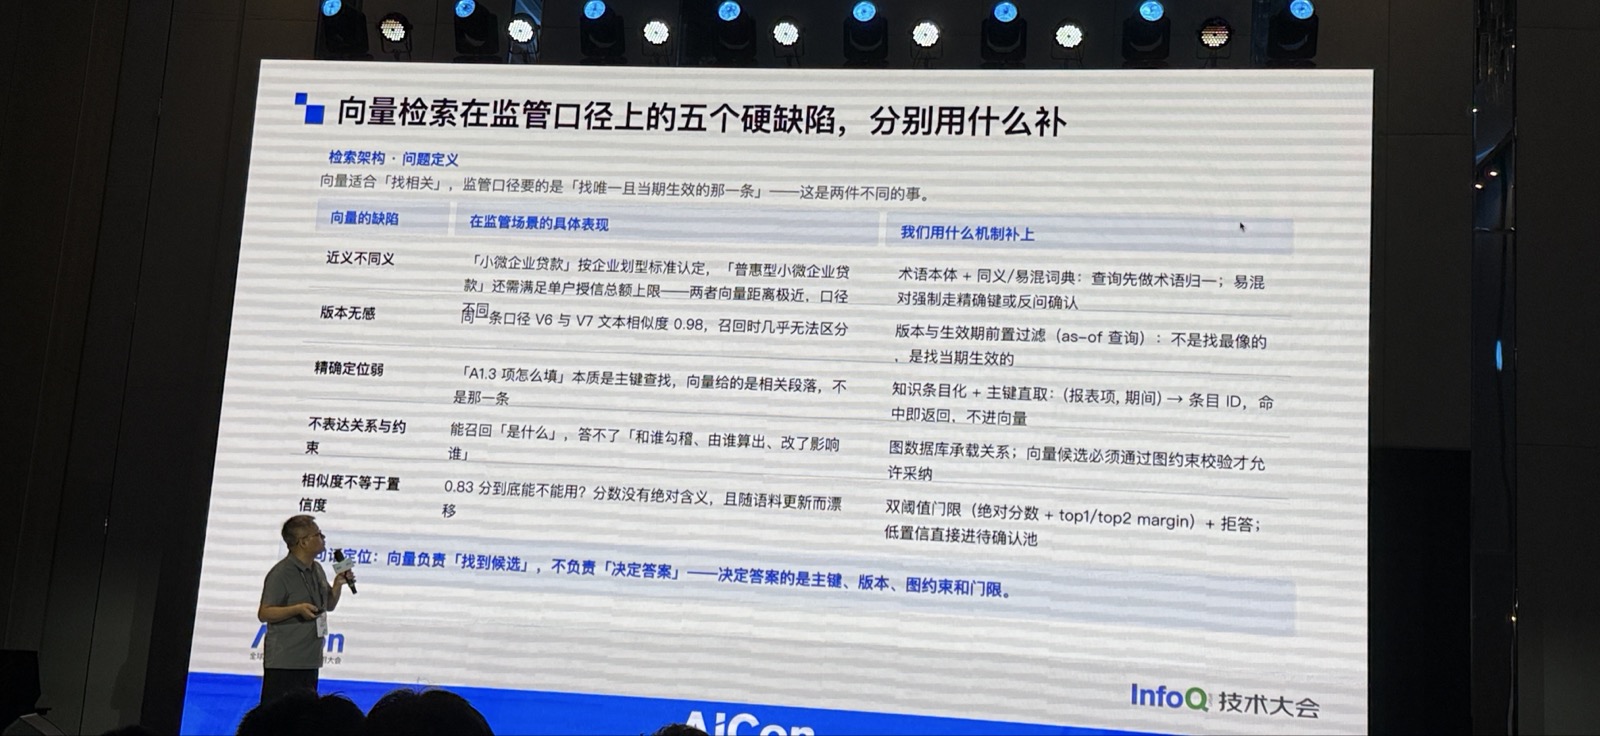
講者也談到,自動化品質檢核適合用在相對固定、規律清楚的監管資料情境;若核心規則頻繁變動,則需要以版本、回歸測試與變更影響分析相互配合。這反映出治理不是一次性的系統功能,而是伴隨資料與規則演進的持續工程。
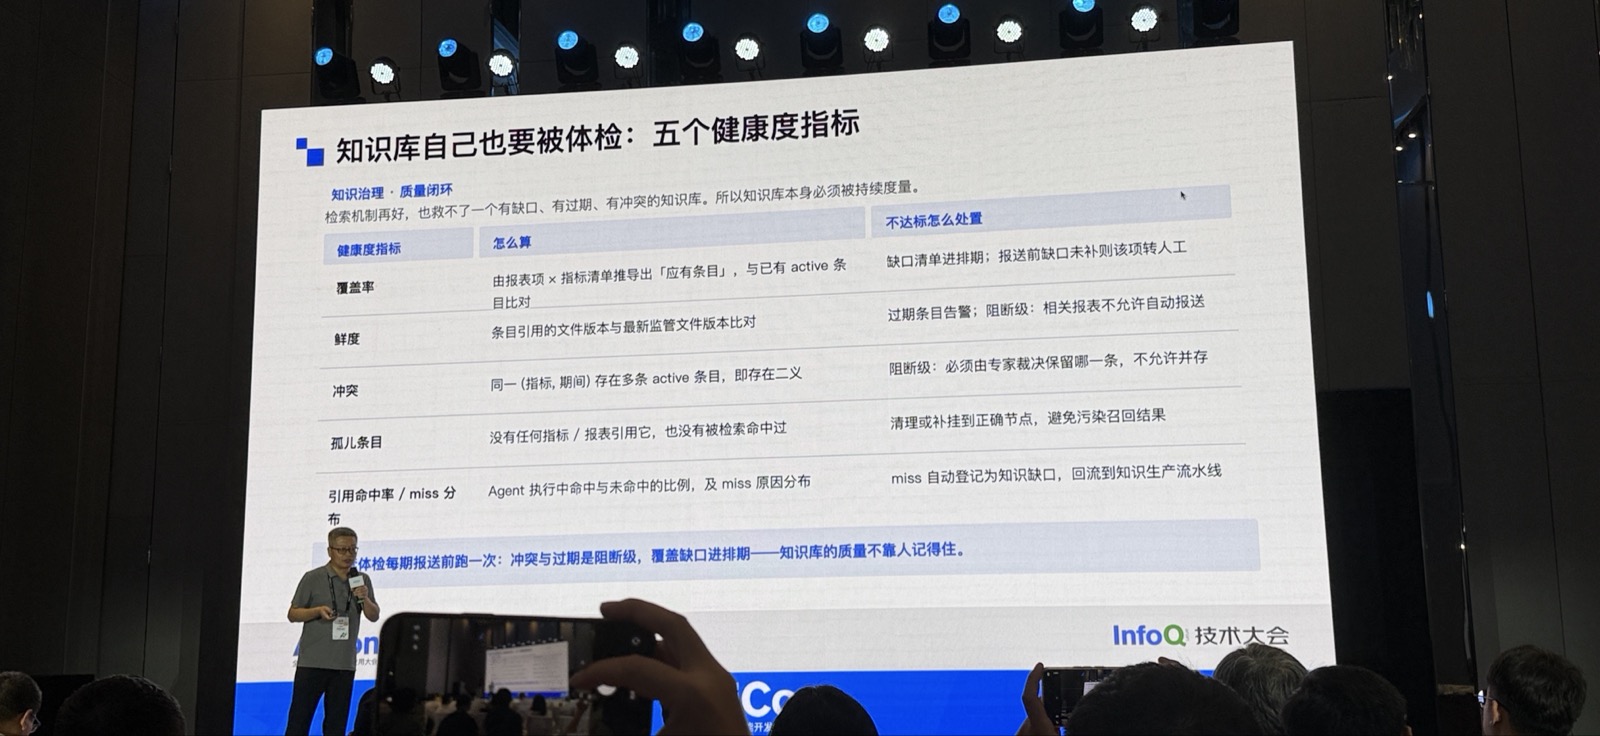
重點回顧:可用的監管 AI,必須能被控制與證明
- 金融監管是強監管場景,AI 的價值必須建立在穩定、可追溯與可稽核的資料處理上。
- 最值得優先治理的三個風險是口徑漂移、模型幻覺與不可解釋;一致性則是貫穿全流程的要求。
- Harness 以知識底座與數據底座支撐 Agent,讓規則、業務流程、資料事實與分析任務能夠連結。
- 權限、評測、回歸、審計與成本限制,將 Agent 從「能做事」推進到「能被安全地使用」。
- 異常處理應形成閉環:發現、定位、分析、追溯、修復、複核,並以報告留下可檢視的說明。
- 真正可靠的輸出不是只有答案,而是能回答資料從哪裡來、依什麼規則計算、發生異常後如何處理。