從 Token 到狀態預測的世界模型路徑
TL;DR:AICON 講座中,智象未來(HiDream.ai)技術合夥人兼算法科學家潘滢炜博士,從大型語言模型延伸到影像、影片與世界模型的發展脈絡,主張生成式 AI 的下一步不只是預測文字 Token,而是理解並預測世界狀態。分享將影片生成的關鍵瓶頸指向時空一致性,並把多模態模型、互動、物理理解與 AGI 願景放在同一條技術演進軸上。
大型語言模型(LLM)世界模型Token 預測狀態預測原生全模態影片生成時空一致性AGI
從語言模型到世界模型:預測目標正在改變
潘滢炜博士以近數十年的模型發展為背景,先從大眾熟悉的 GPT 等大型語言模型談起,再轉向影像與影片等生成模型。若說 LLM 擅長依上下文接續下一個文字單位,世界模型所追求的則更像是替 AI 建立一個可持續更新的「內在模擬器」:它不只產生內容,也要表徵世界如何變化、物件如何互動,以及下一個狀態可能是什麼。
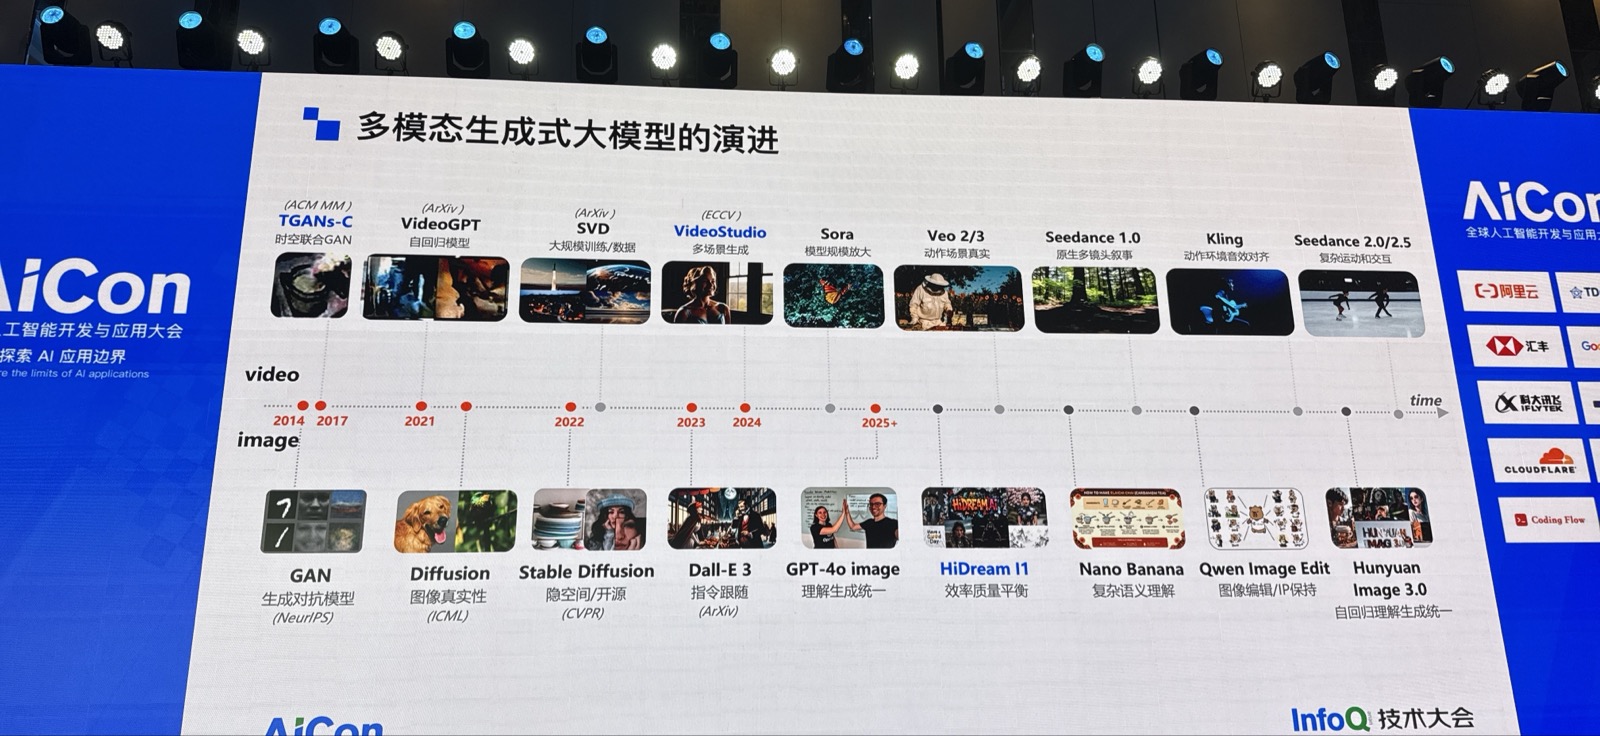
演講將模型架構的演化描述為逐步收斂的過程:不同任務的模型技術與架構,正朝向更通用的生成式網路靠攏。這不代表所有能力已經統一,而是指出一個方向——文字、影像、影片等資料型態,將在更共同的表徵與推理框架中被處理。
影片生成進步快,難題仍在時間與空間
分享中多次提及 Sora 與近年影片生成的進展:模型已能產出更好的畫質與更長的內容,但生成影片的核心挑戰並未消失。尤其當鏡頭、角色與物件持續變動時,模型必須維持前後畫面的連續關係;否則單張看似合理的影像,串成影片後仍可能失真。
「這個其實是最後主要的一些瓶頸。」
— 潘滢炜博士
- 畫質提升並不等同於理解世界:模型還要讓物件、角色與場景在連續畫面中保持合理關係。
- 時空一致性是影片生成的重要門檻,可理解為 AI 不能只畫好每一格,還得讓每一格接得起來。
- 講者將此問題連回世界模型:若模型能掌握狀態如何演進,生成內容才更可能穩定地延續。
原生全模態:把生成能力推向可理解的狀態
在後段技術說明中,講者觸及全模態經驗、模型架構與工具使用等概念。雖然逐字稿部分辨識不完整,但可辨識的主軸是:模型不應只分別處理文字、圖片或影片,而要能在多種模態之間建立可用的共同理解,進一步支援對環境、動作與任務的判斷。
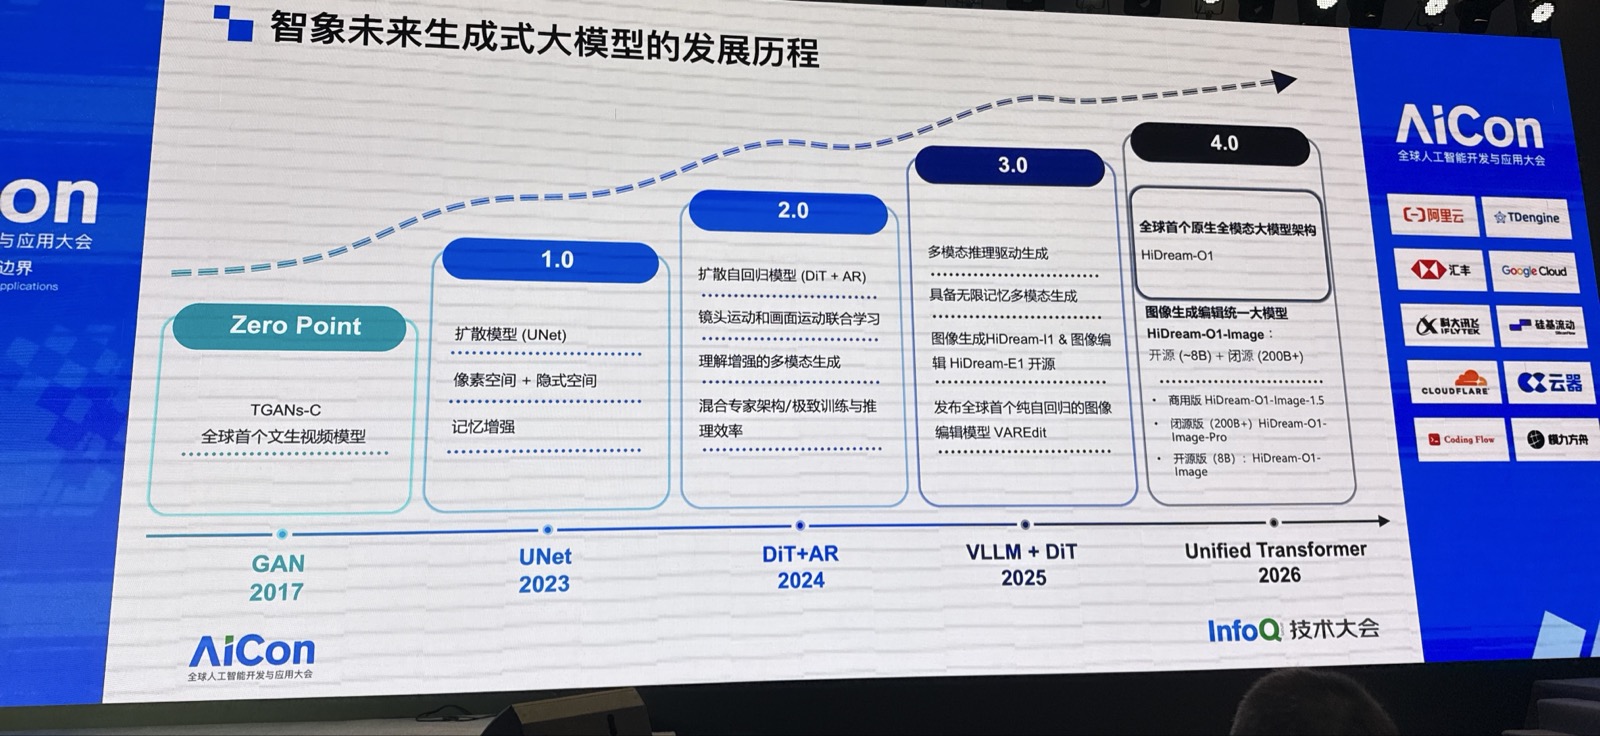
這種轉變可用「背台詞」與「理解場景」來比喻。前者能根據前一句接出下一句;後者則知道人在何處、物件如何移動、做出某個動作會帶來什麼後果。講座所說的狀態預測,正是希望模型具備後一種能力,讓多模態生成不只是輸出媒材,而能對世界變化形成更連貫的表徵。
競逐生圖與影音,能力之外也看定位
個人筆記在約 5 分 56 秒標註,市場上又有業者投入生圖與影音競爭。這也呼應演講對影像、影片與全模態生成的持續著墨:當基礎生成能力快速普及,差異化將不只在能否產生內容,還在於內容是否可控、可延續,並能否與更完整的世界狀態理解結合。
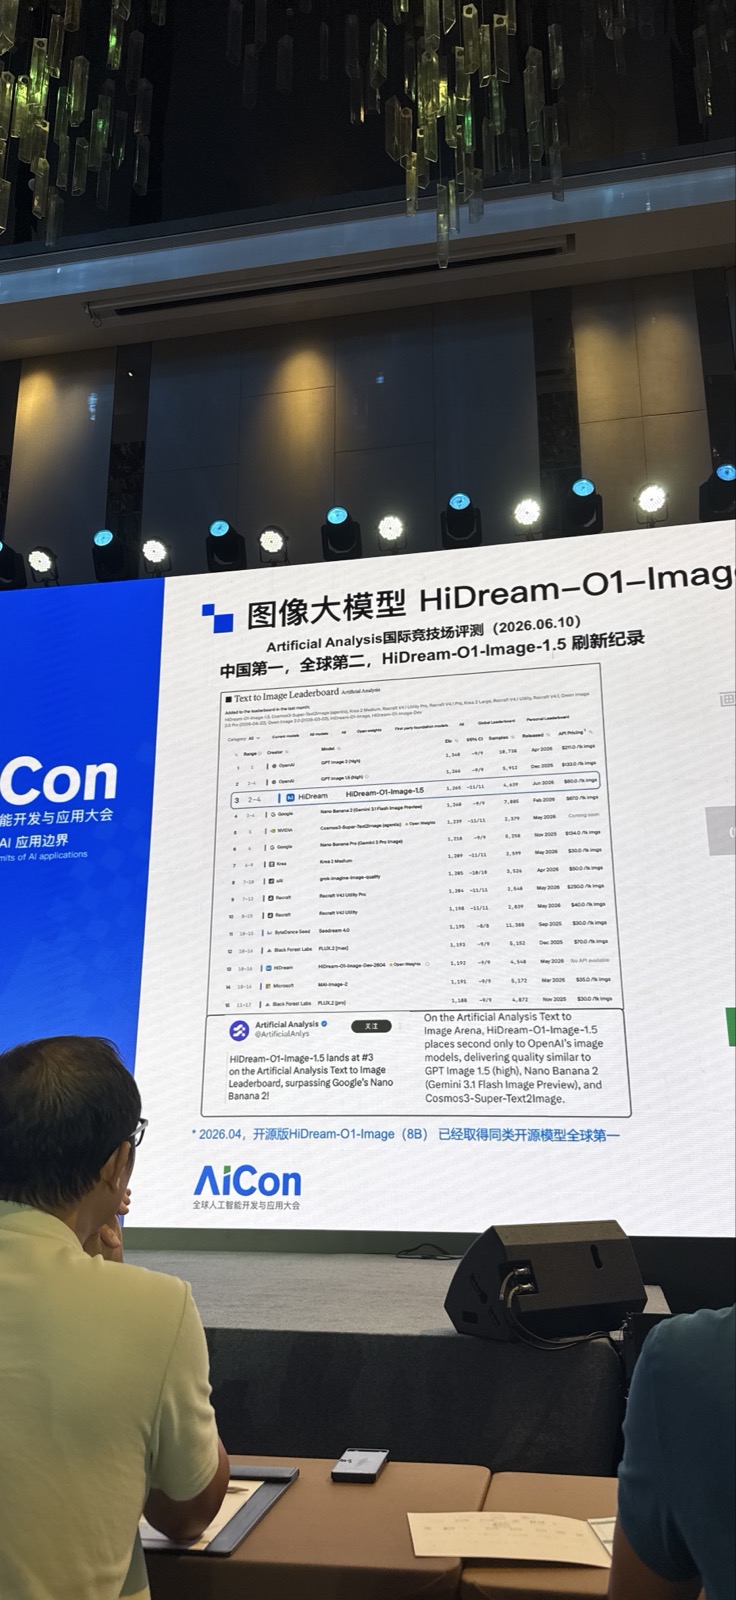
約 13 分 10 秒的個人筆記記錄了簡報中「自己排第一」的訊息。由於對應逐字稿未能完整辨識其比較指標或排名範圍,較適合將其視為講者對自身定位的強調,而非可供外部驗證的客觀排名結論。
從互動與物理理解,延伸到 AGI 的討論
約 21 分鐘處,講者將話題推向世界模型與更廣義的智慧能力,提及物理交互、角色與判斷等面向。個人筆記也特別標註此處「硬要講到 AGI」,顯示 AGI 是這段論述的重要延伸:世界模型被放在通往更通用智慧的框架中,而不只是影片或影像生成的升級版。
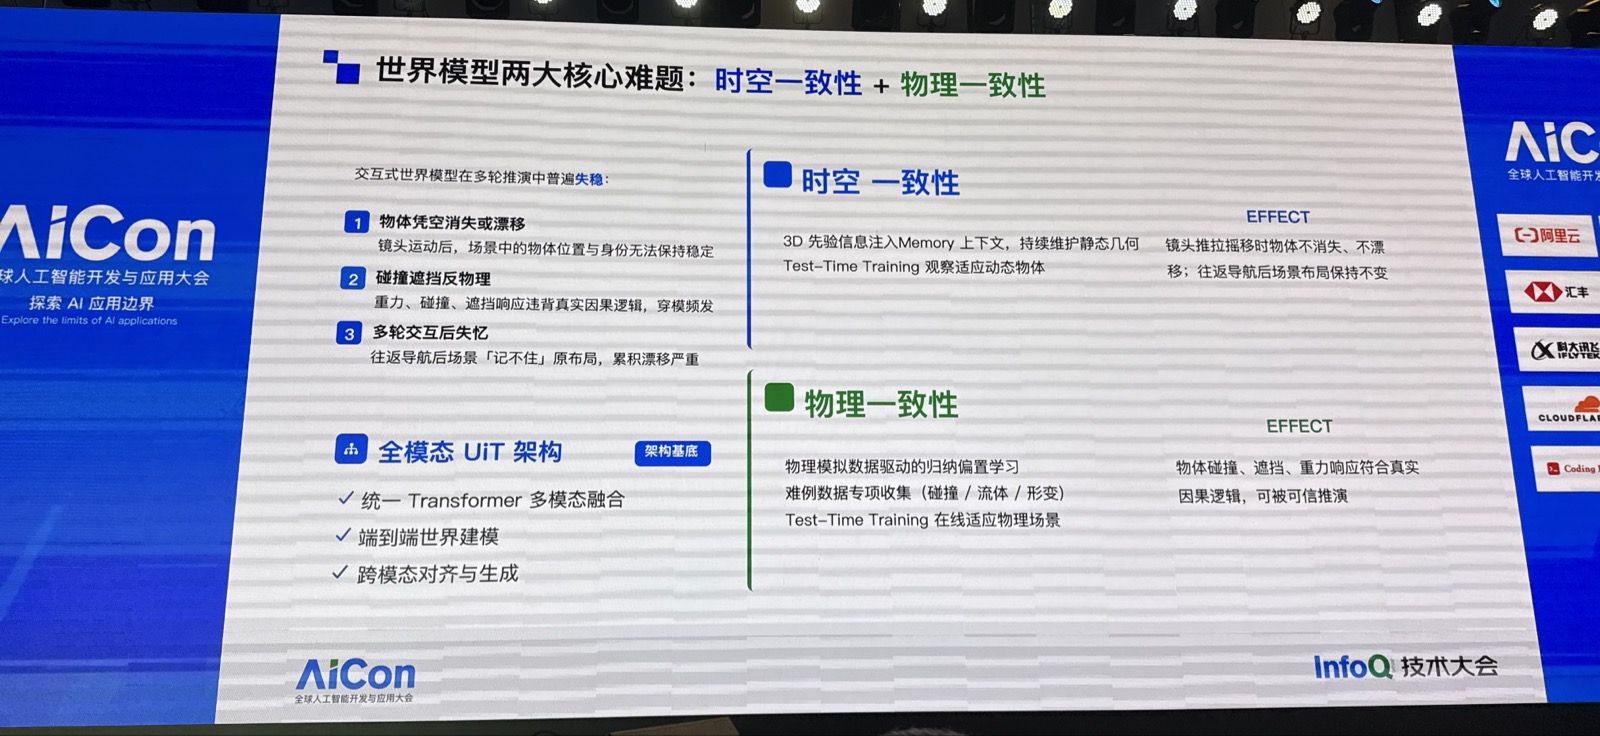
不過,講者也明確指出,若要讓模型真正進入可感受、可交互的世界,物理互動與角色判斷仍「都還沒到」。因此,AGI 在此更像技術路線的遠方座標,而非已完成的產品宣告;眼前的實作仍需回到狀態表徵、時空一致性與多模態整合等具體問題。
重點回顧
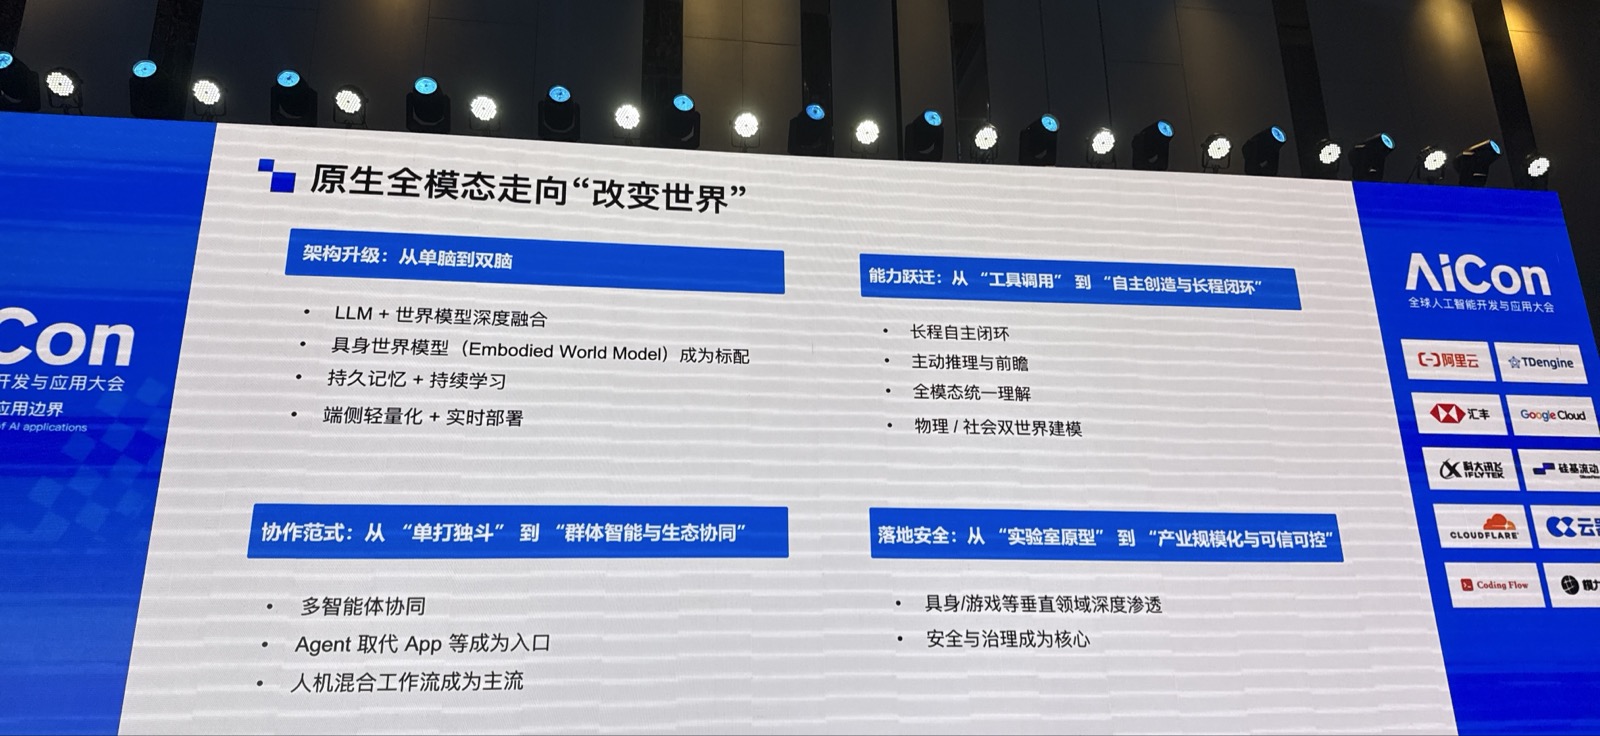
- 世界模型的關鍵,不只是把文字、圖片與影片做得更像,而是由 Token 預測走向對世界狀態的預測。
- 影片生成已快速改善,但時空一致性仍是影響可用性與真實感的主要瓶頸。
- 原生全模態的目標,是讓模型跨越媒材邊界,將視覺、語言、動作與環境訊號納入共同理解。
- 生圖與影音競爭持續升溫;未來差異化將更依賴可控性、持續性與互動理解。
- AGI 是本次分享的延伸願景,但物理交互與判斷能力仍有待突破。