OPPO端側多模態模型工程實踐
TL;DR:余席宇博士分享 OPPO 將多模態大模型部署至手機端的工程方法,核心是在記憶體、時延與功耗限制下,透過量化感知訓練、稀疏化、KV Cache 管理、投機解碼與自動化部署平台,讓模型可在端側落地;同時也探索以零階優化支援資料不出設備的輕量個人化訓練。
端側大模型多模態量化感知訓練(QAT)稀疏化KV Cache投機解碼端側訓練
端側落地的核心:先解記憶體、時延與功耗
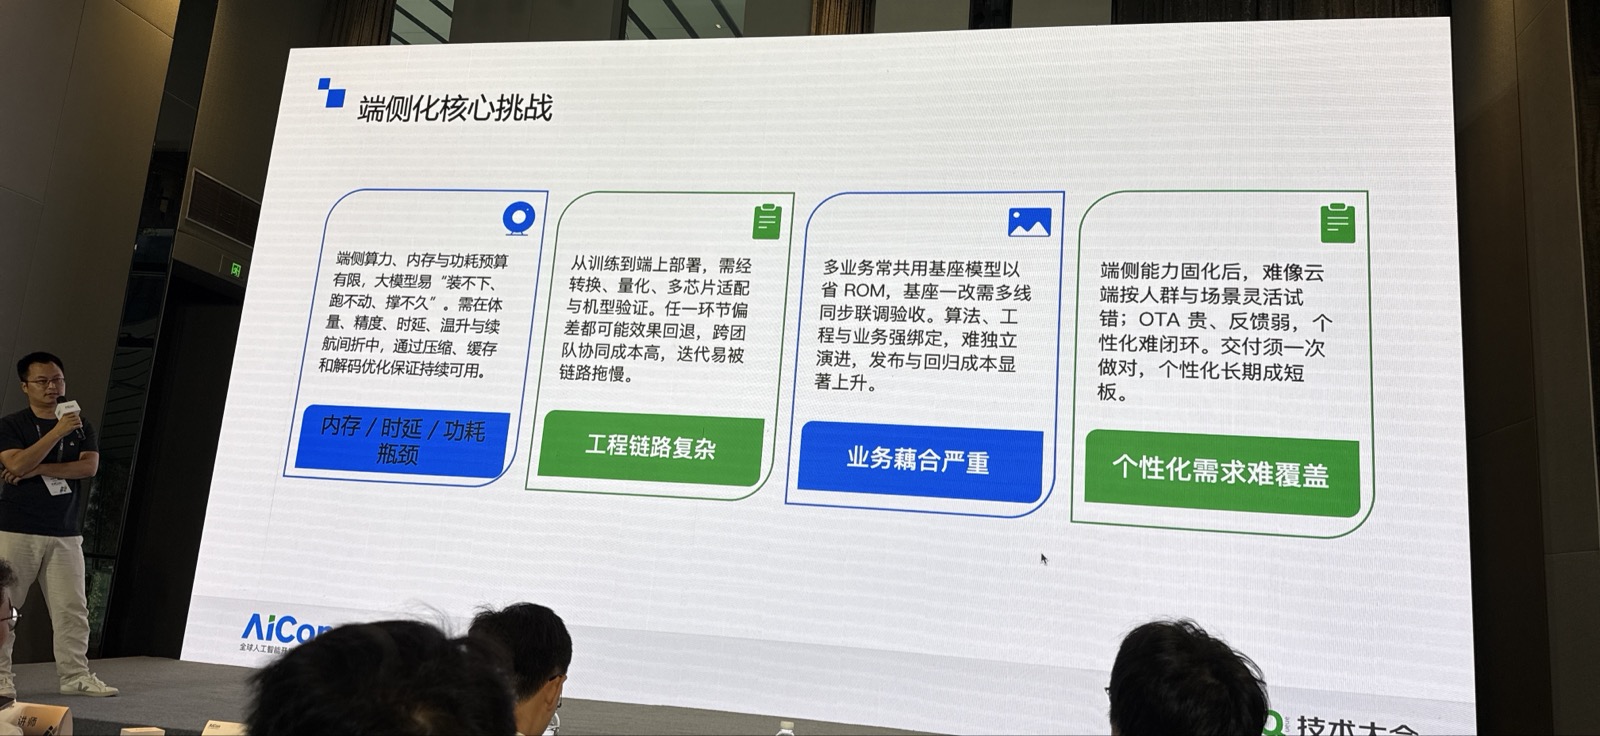
將大模型放進手機,首先不是單一模型能力問題,而是資源平衡問題。端側模型必須在嚴格的記憶體、算力與功耗限制下,同時做到「裝得下、跑得動、跑得久」。此外,從訓練、量化到編譯部署的鏈路繁複,基礎模型與各業務 LoRA 的相依關係,也使更新與維護成本升高。
「真正要端側它落地,部署到手機端其實還有很多的難題要解決。」
— 余席宇
- 模型壓縮需兼顧精度、記憶體占用、推理時延與功耗。
- 訓練、QAT、PTQ、編譯與部署流程長且碎片化,工程成本高。
- 共用基礎模型搭配多個業務 LoRA,會因任一模型變更而產生部署耦合。
- OTA 與後續更新成本高,面向智慧體需求需要更具彈性的更新方式。
從浮點模型到 Runtime:建立端側化 Pipeline
OPPO 的端側化流程以浮點教師模型微調為起點,接續量化感知訓練,整合低比特量化、稀疏化與編譯解碼加速;之後依不同晶片商 SDK 進行 PTQ 與必要微調,產出可編譯部署的量化模型,並在端側 Runtime 以平行解碼等方式加速推理。
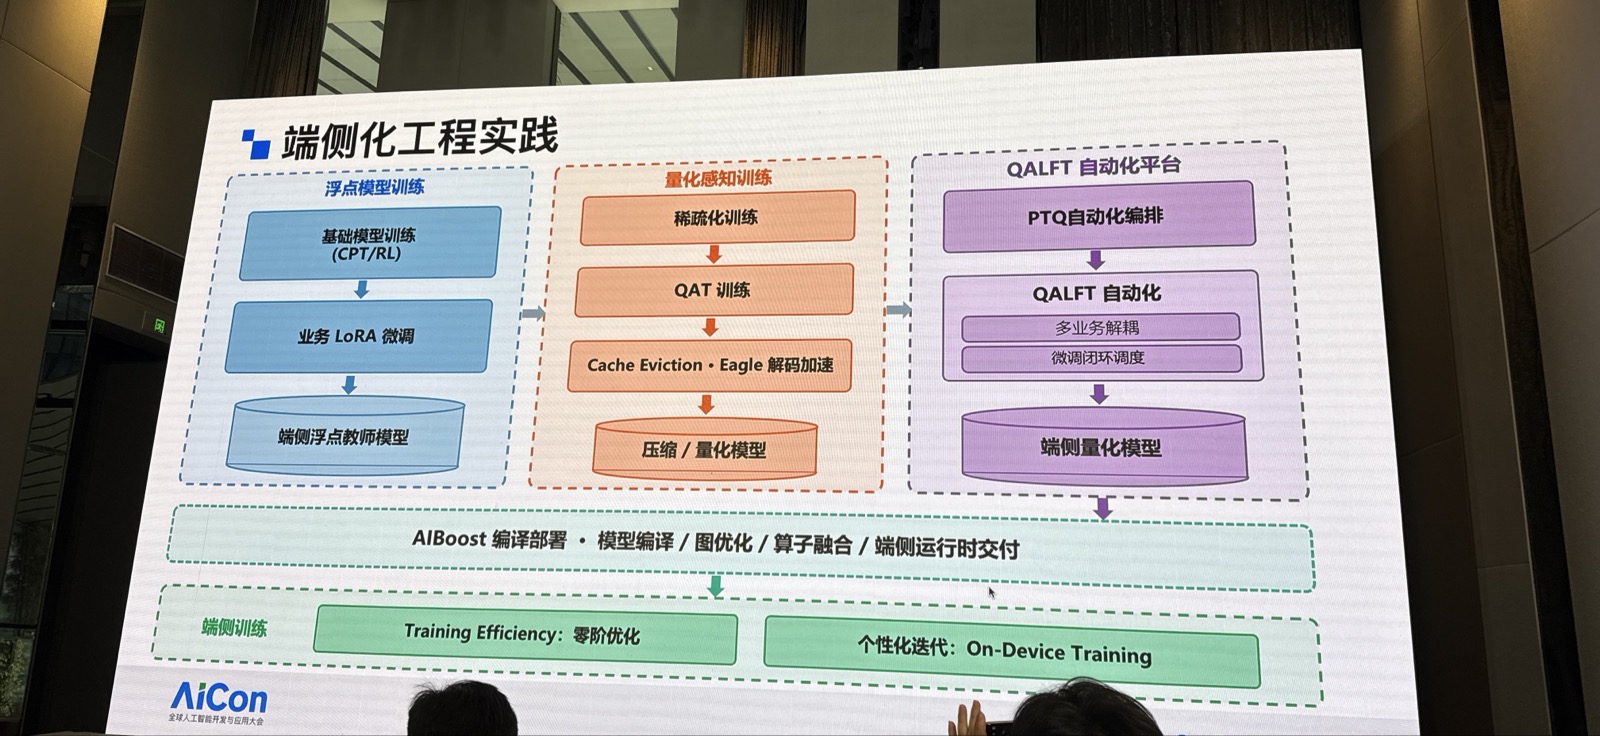
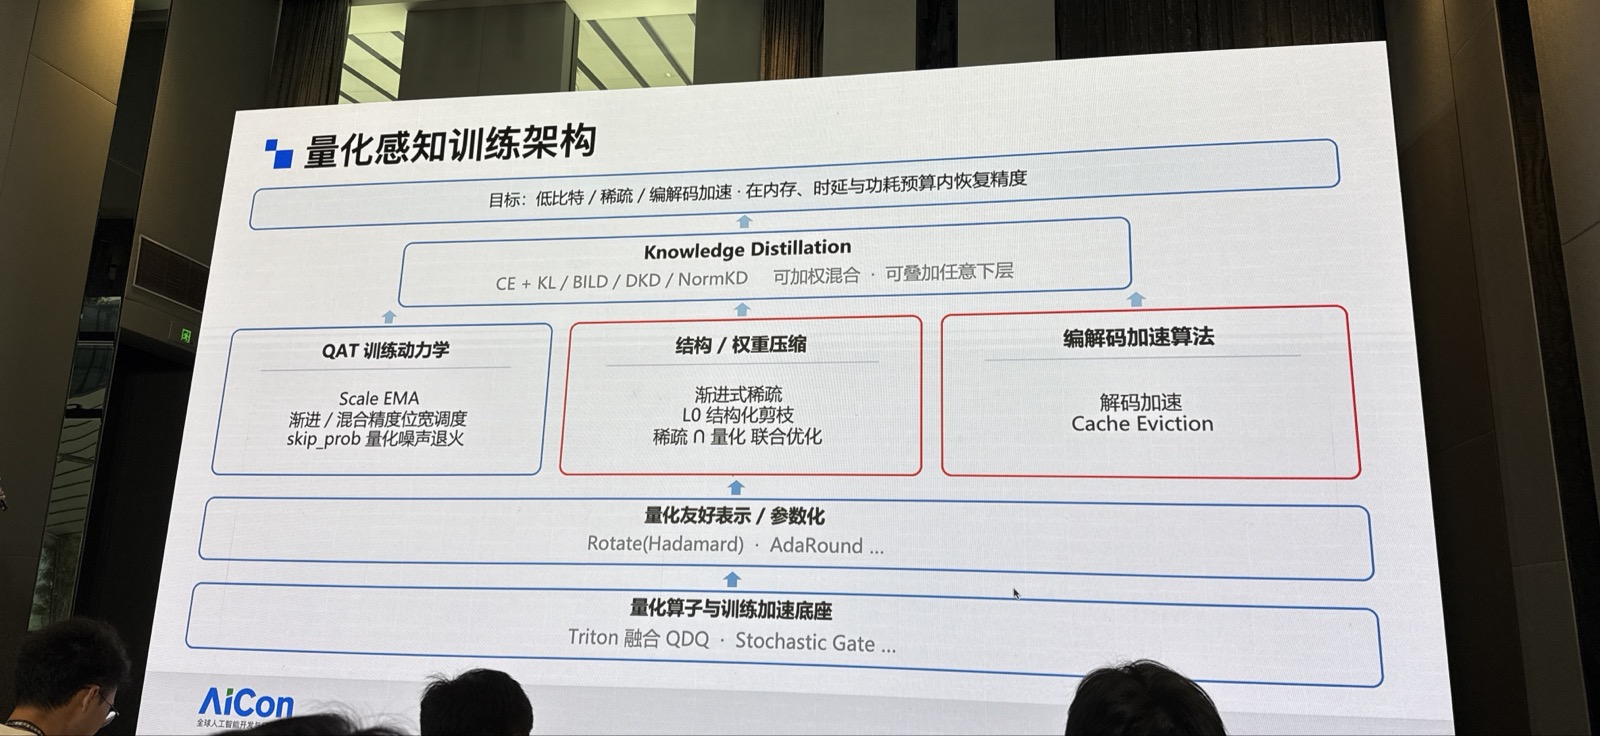
其中,量化感知訓練架構是技術核心:以協同式方法結合知識蒸餾、低比特量化、結構化與非結構化稀疏化,以及投機解碼,目標是在資源預算內盡量恢復浮點模型精度。分享中也提及以量化友善表示與量化算子,提升 QAT 訓練的穩定性與效率。
稀疏化與 KV Cache:壓低記憶體瓶頸
稀疏化訓練用以降低模型記憶體容量與快取頻寬壓力。其做法包括由低到高逐步調升稀疏度、依各層對稀疏化的敏感度自適應配置,以及動態調整掩碼更新頻率。實際落地還需結合晶片商對稀疏編碼的支援,才能把模型稀疏性轉化為位元占用與頻寬效益。
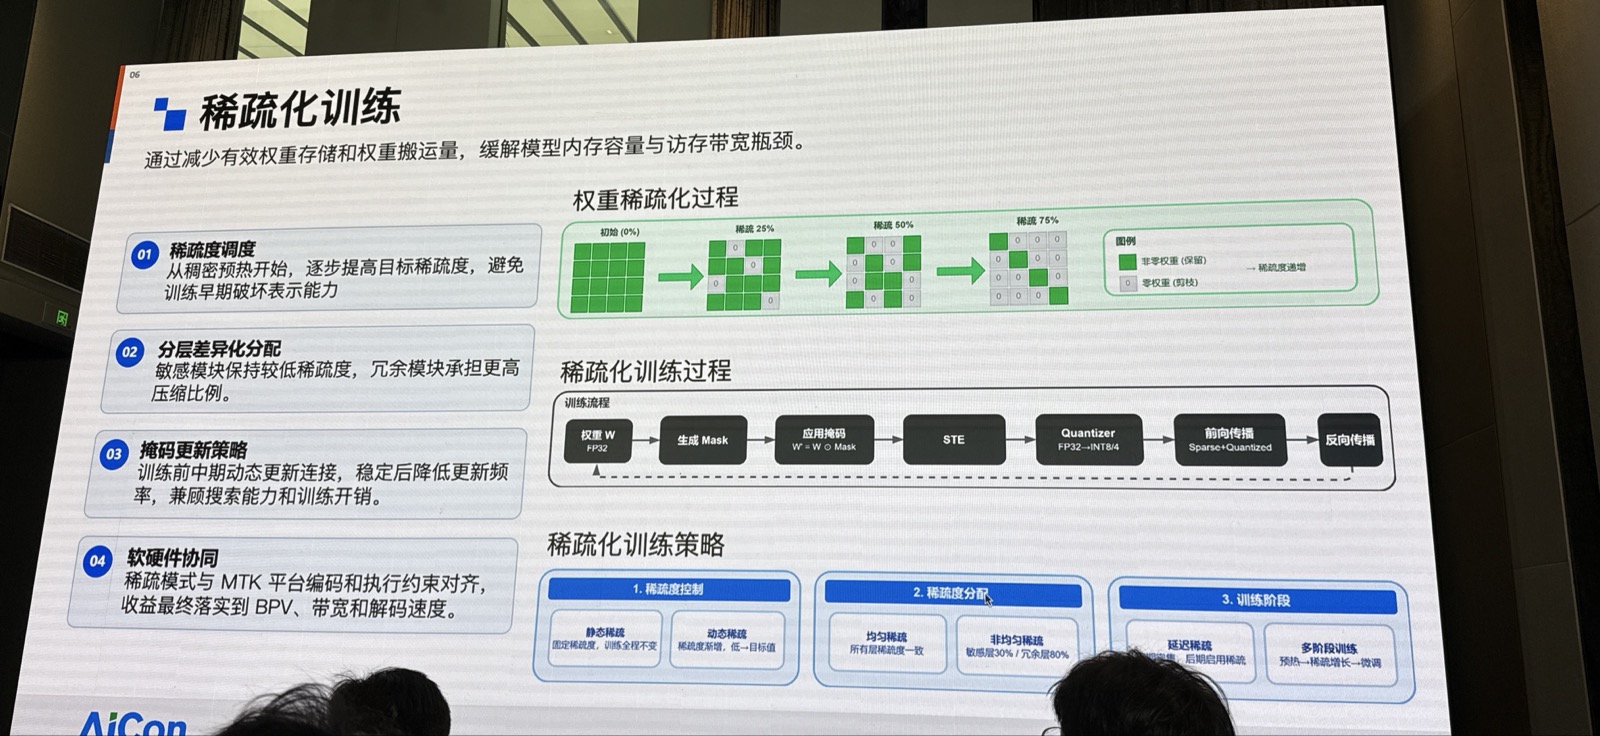
- 分享案例中,在 75% 稀疏模型條件下,記憶體占用可降低約 33% 至 67%。
- 與 MTK 合作的案例中,解碼速度提升 40.6%。
- 不同層對稀疏度的容忍度不同;例如分享指出 LM Head 在高稀疏設定下可能需要保留較低稀疏度。
- 待釐清:稀疏模型在不同晶片商與 SDK 上可獲得的實際編碼、頻寬與速度收益。
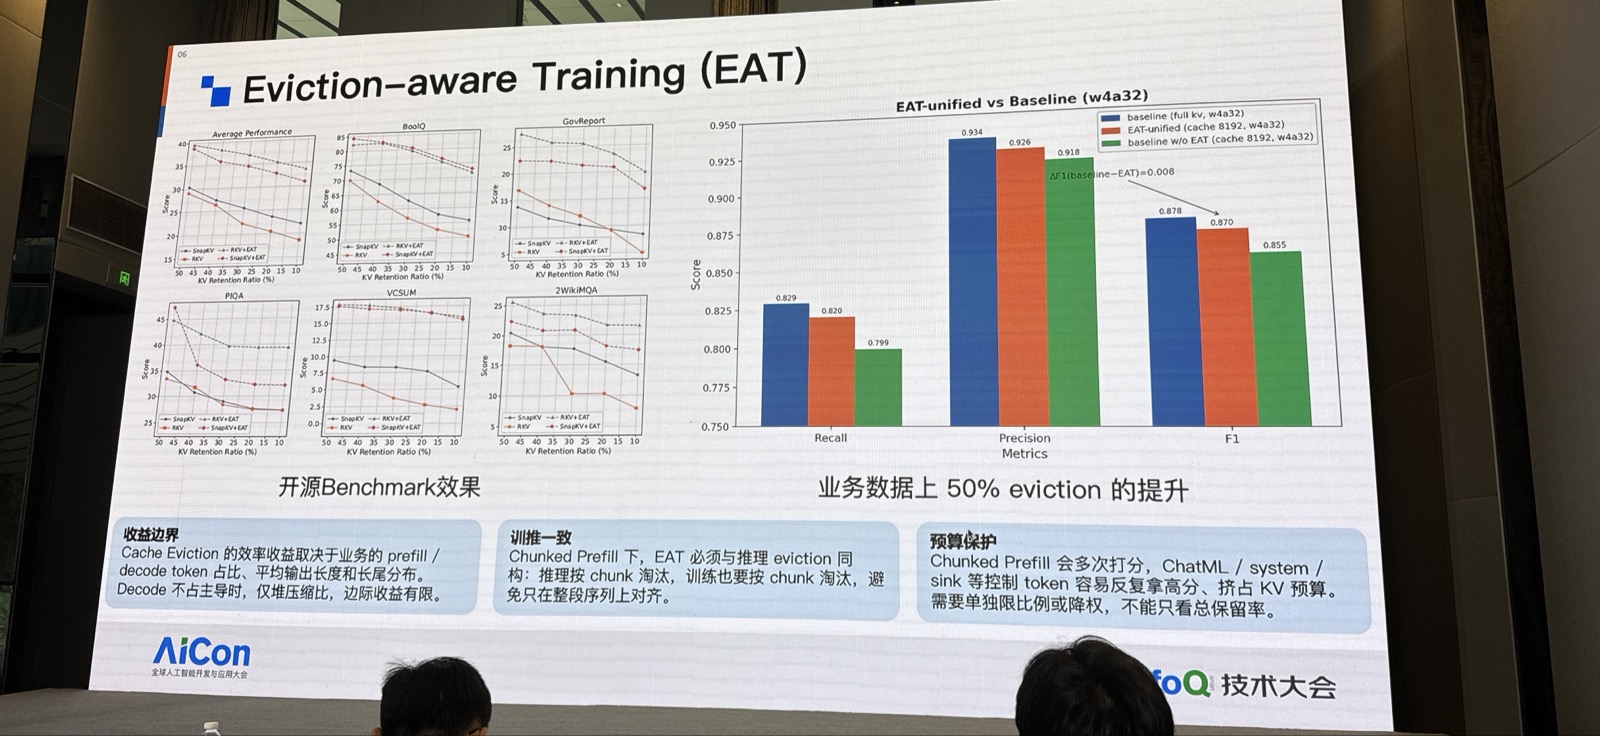
面對長上下文,KV Cache 會隨序列長度線性成長,快速擠占端側記憶體並增加頻寬開銷。團隊以 Attention Score 等重要性設計選擇保留關鍵 Token、淘汰非重要 Token;並注意到 QAT 噪聲可能改變注意力分布,因此將 Cache Eviction 納入 QAT 訓練迴圈,使模型適應快取淘汰帶來的影響。
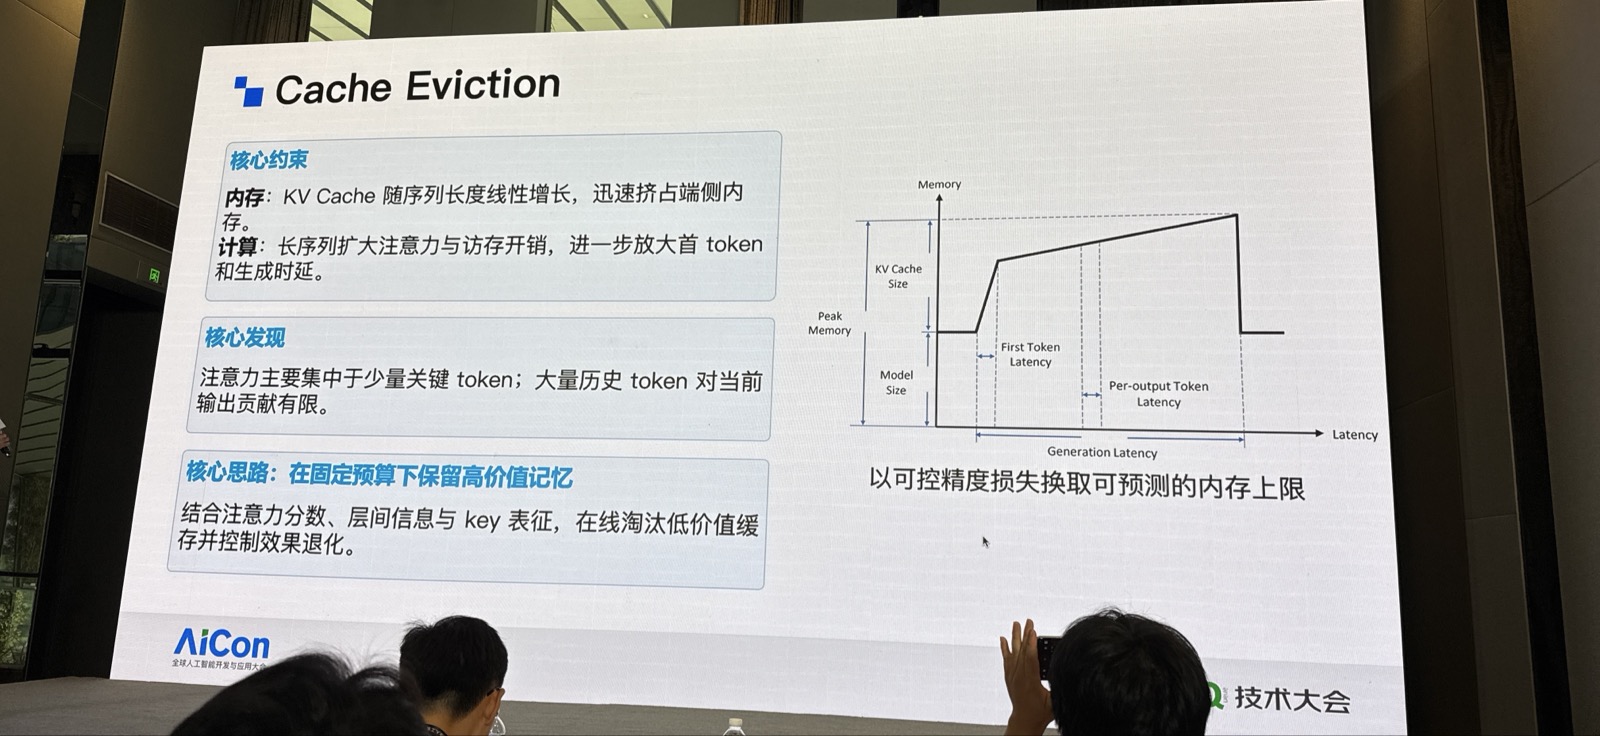
- 訓練與推理中的快取淘汰策略應盡可能一致,以發揮實際端側效果。
- 僅採全域預算可能誤刪語義重要 Token,因此需設計預算保護機制。
投機解碼:以草稿模型換取推理速度
投機解碼以較小的草稿模型預測多個 Token,再由大模型一次推理驗證,可減少大模型的推理次數。關鍵在於提高草稿結果的接受率與接受長度,同時壓低草稿模型本身的推理成本。
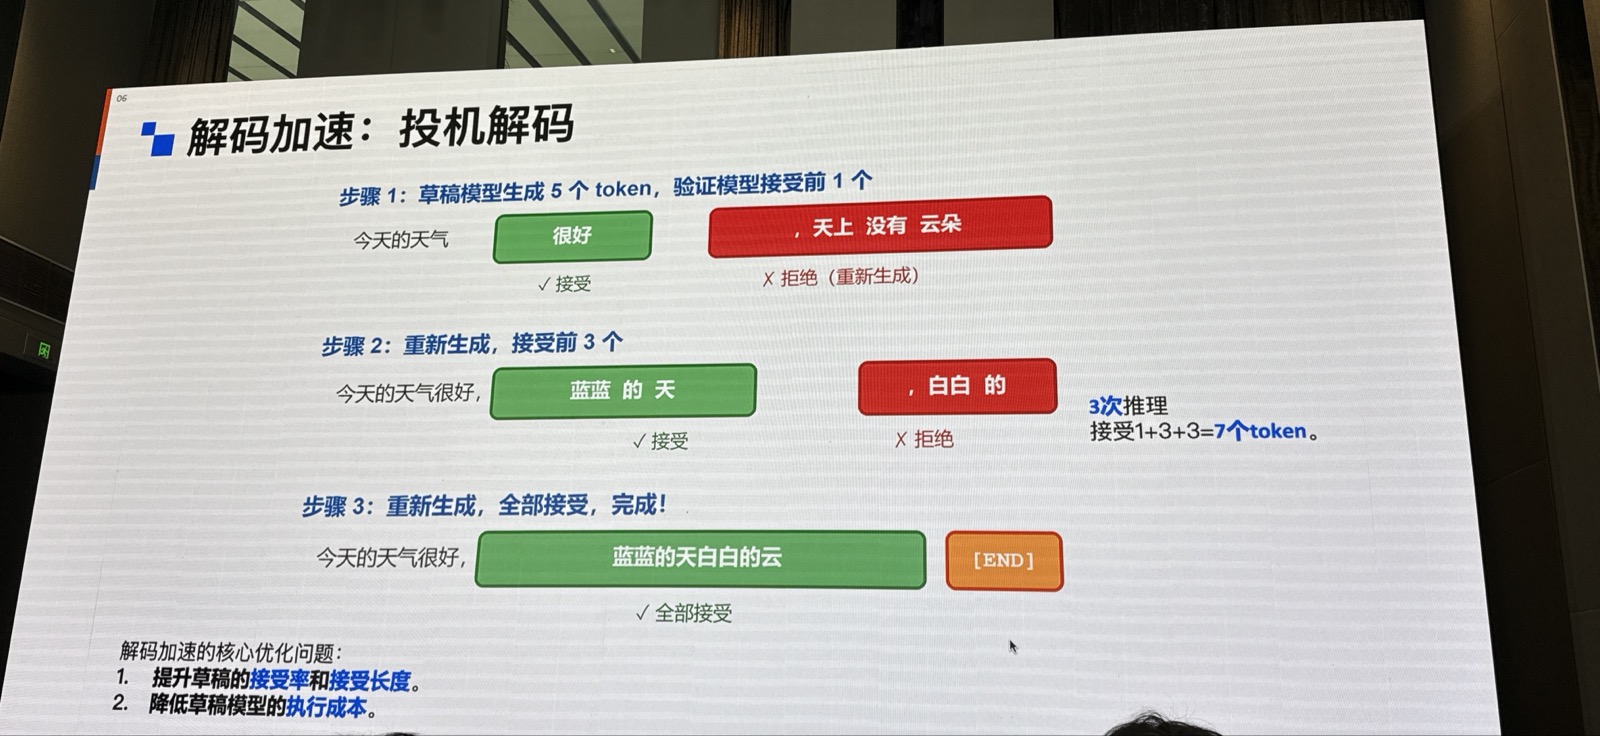
針對草稿模型可能過度自信、過早投注運算在錯誤 Token 路徑的問題,團隊設計 tree loss,提升正確路徑的預測、抑制錯誤路徑。多模態輸入端則需處理圖像與文字 embedding 數值範圍差異,以避免影響草稿模型收斂與精度。
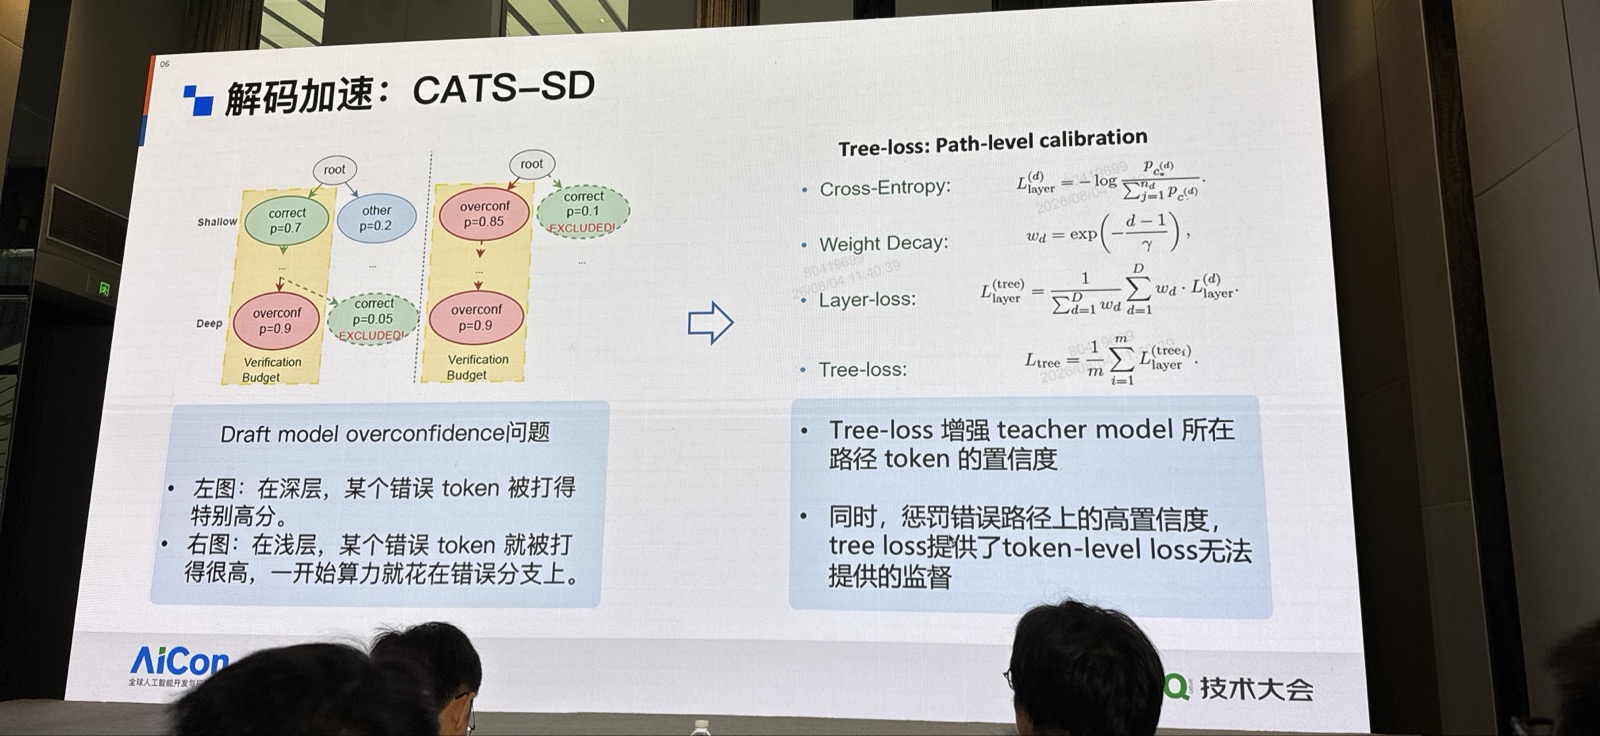
「投機解碼其實就是用一個小的草稿模型去做大模型結果的推測。」
— 余席宇
解除多業務耦合:部署流程走向自動化
過往採共用基礎模型與多業務 LoRA 的方式,若基礎模型或任一 LoRA 更新,可能牽動整體重新編譯。團隊改為先完成基礎模型 PTQ,再基於該量化基礎模型微調 LoRA,以降低多業務部署耦合。
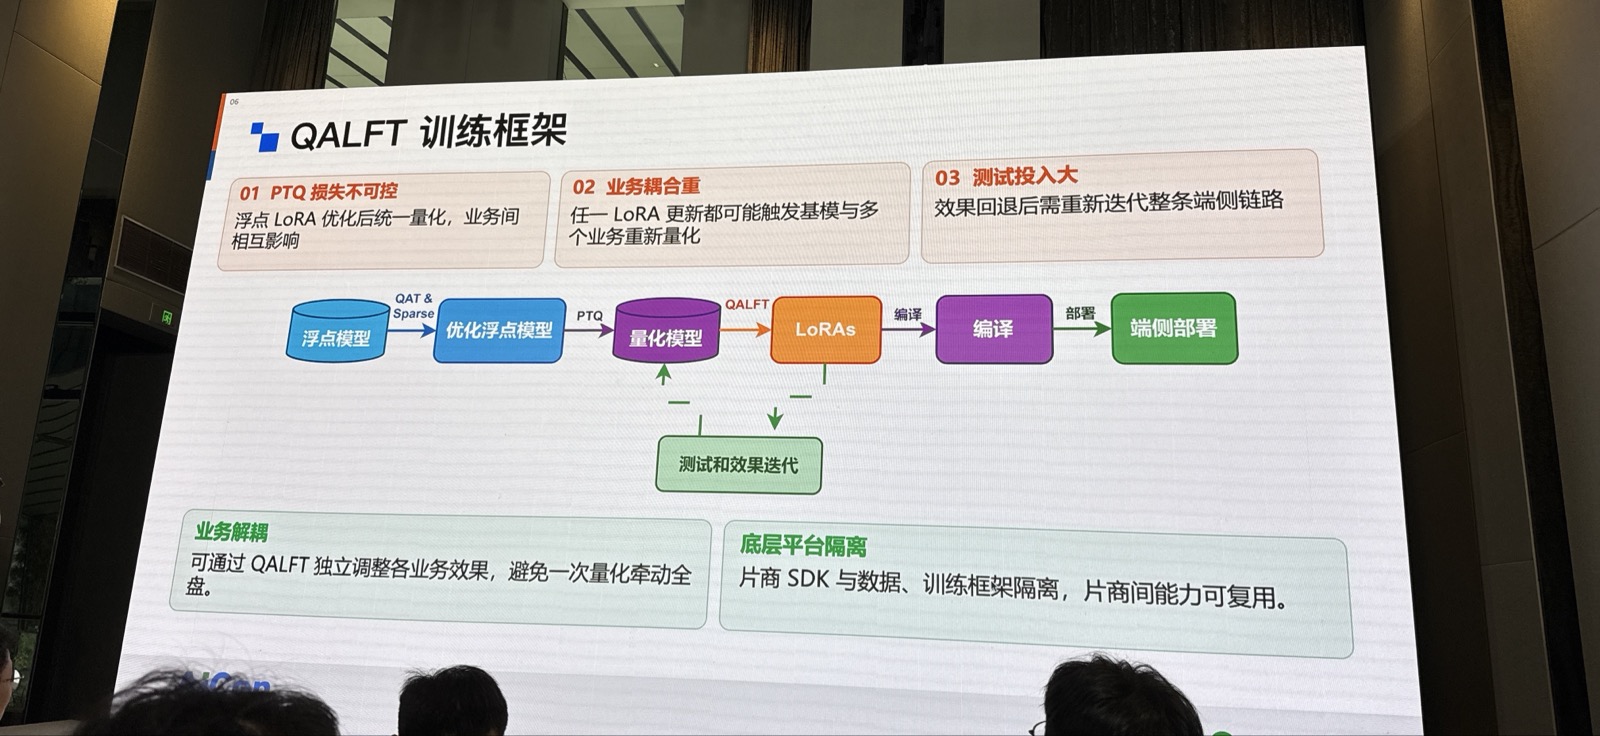
為縮短高度依賴人工串接的流程,OPPO 建置 QFT 自動化平台,提供一鍵配置、資料系統串接、平行調度與局部重跑能力。分享指出,流程週期已由天級縮短至小時級,並支援兩個大版本、10 多個業務的交付;相關業務指標損失控制在一個百分點以內,部分情況在 QFT 後有所提升。
端側訓練:以零階優化支援個人化
端側訓練旨在以輕量微調滿足個人化需求,並讓資料留在設備內,以回應隱私考量及減少全量部署流程成本。然而,傳統反向傳播需儲存梯度與中間計算量,對手機的記憶體、算力及既有推理架構都是挑戰。
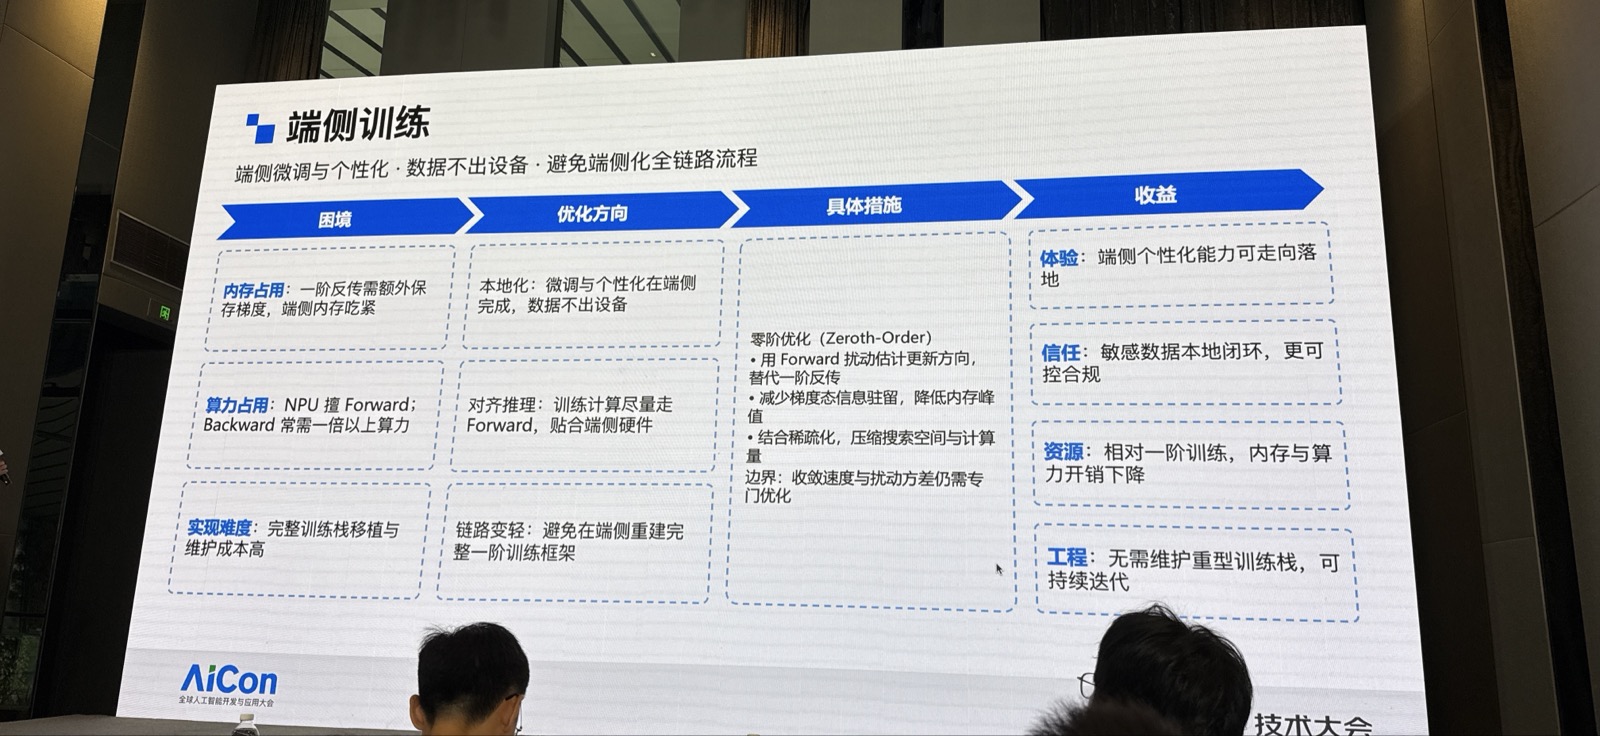
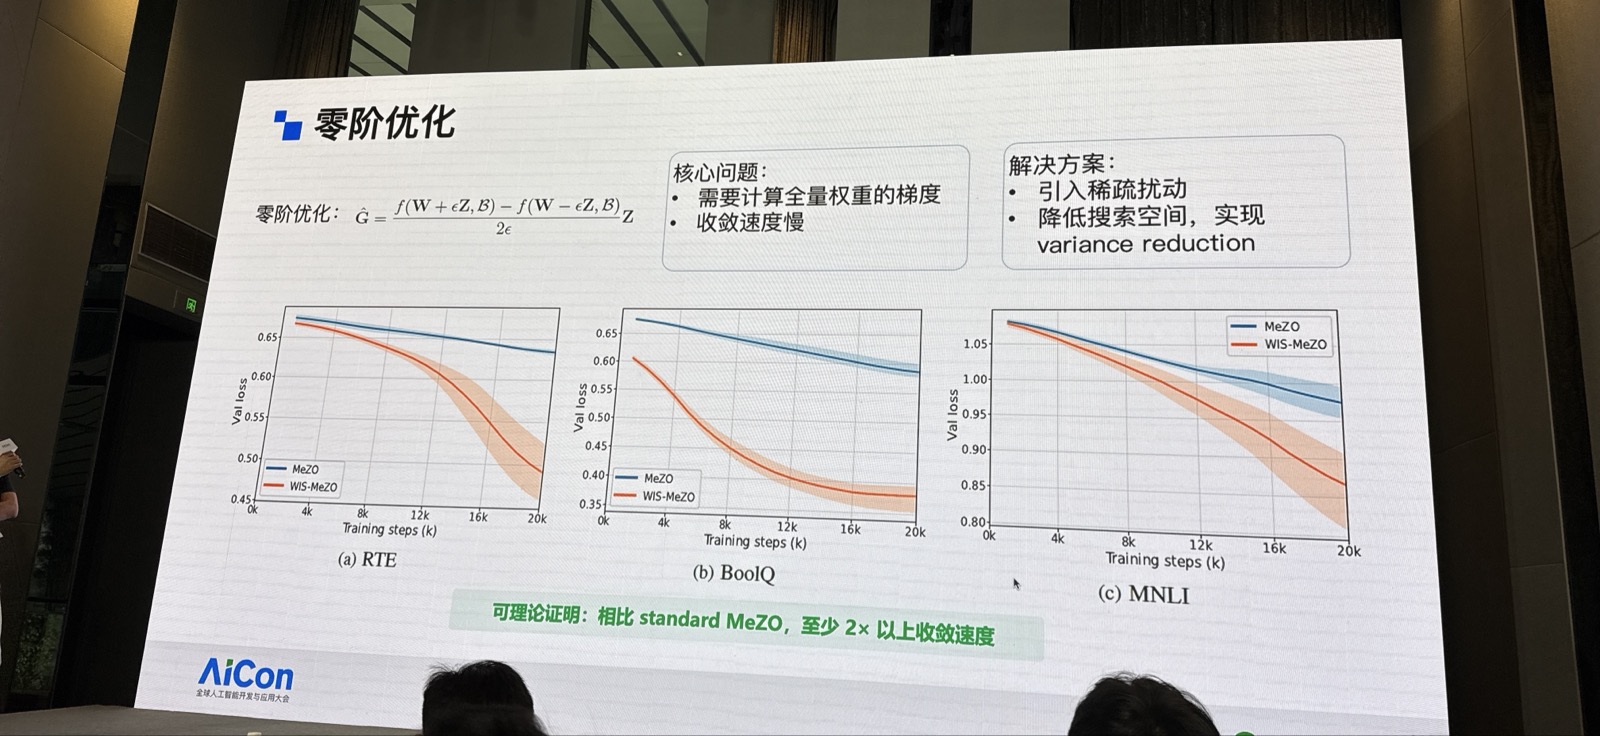
團隊嘗試零階優化,以兩次 forward 取代一次反向傳播,並透過稀疏擾動與重要性分數選擇權重進行近似梯度更新,降低訓練期間的記憶體與算力峰值。分享表示,該框架在理論與實作驗證中,收斂速度相較標準方法可提升至少兩倍。
已展示的端側能力與後續方向
分享列舉三類已落地或展示的端側能力:一鍵閃記可記錄如取件碼等資訊;端側摘要支援長文本及會議等內容,並可延伸至資訊與待辦挖掘;自研投機解碼則在 MTK D366 平台、全功耗開啟條件下,達到每秒 220 Token 的推理速度。
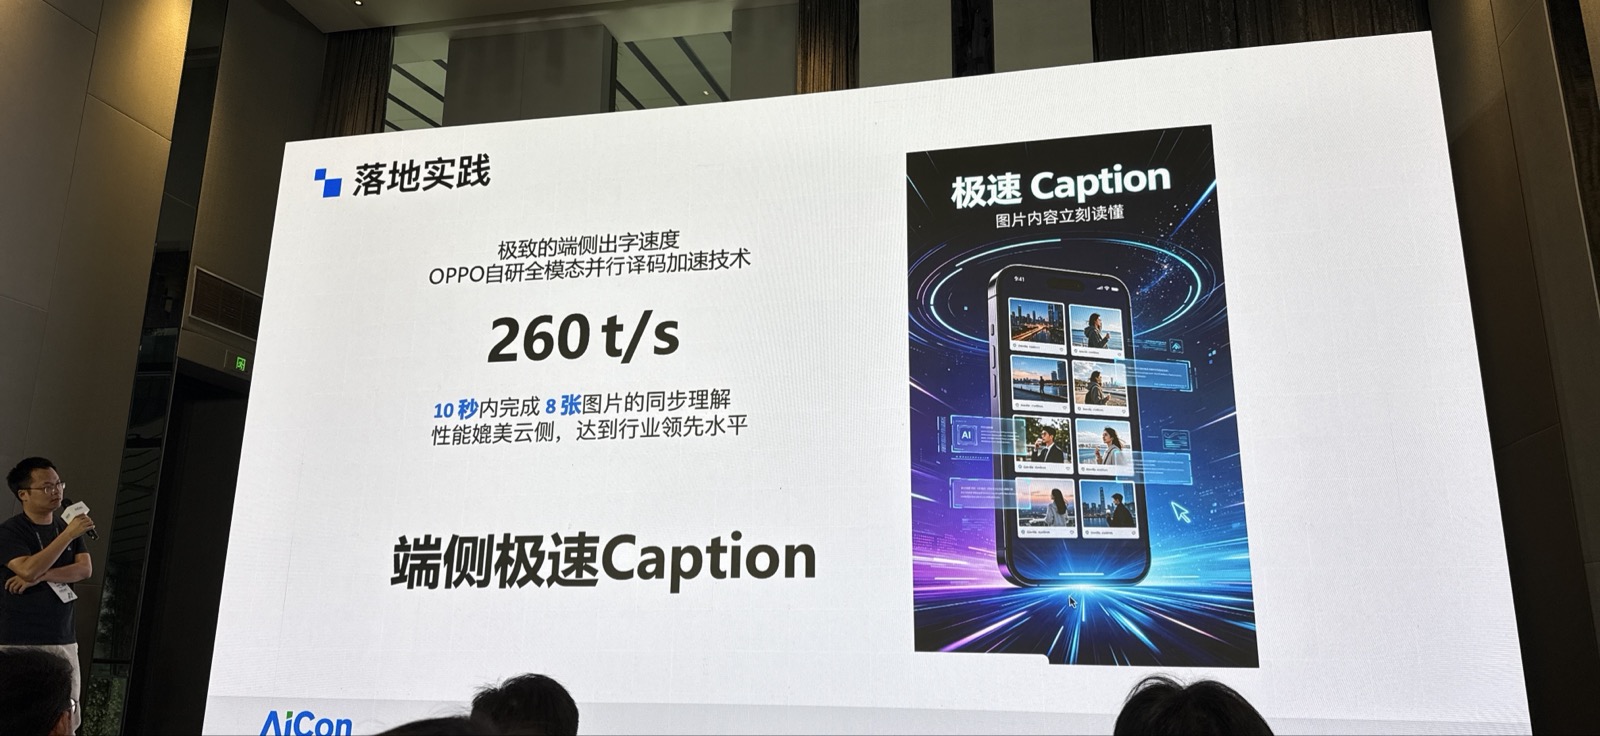
- 待釐清:每秒 220 Token 推理速度所對應的任務設定、模型精度與正確性評估方式。
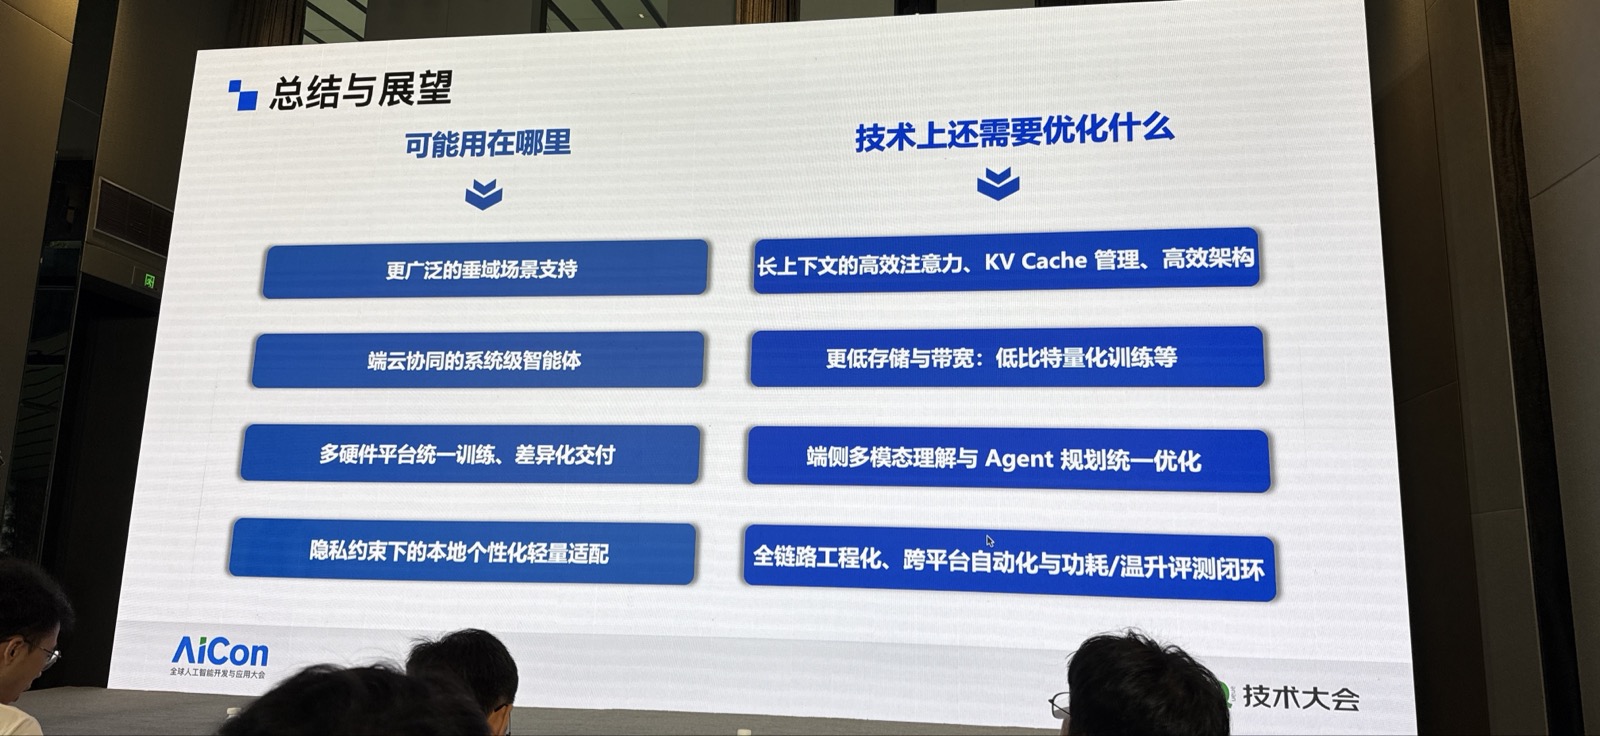
後續研究聚焦四個方向:長文本下的高效注意力與 KV Cache 管理、更低比特的純屬壓縮、端側動態理解與智慧體規劃執行,以及訓練與評測平台的進一步自動化。
重點回顧
- 端側大模型工程化的底層約束,是記憶體、時延與功耗的平衡。
- QAT、稀疏化、KV Cache 淘汰與投機解碼須協同設計,不能各自孤立優化。
- 面對多業務與多硬體環境,流程解耦與自動化平台是規模化交付的關鍵。
- 端側訓練仍在探索階段,零階優化提供在有限資源下支援個人化的一條路徑。