AI效能工程:從省資源到自動優化
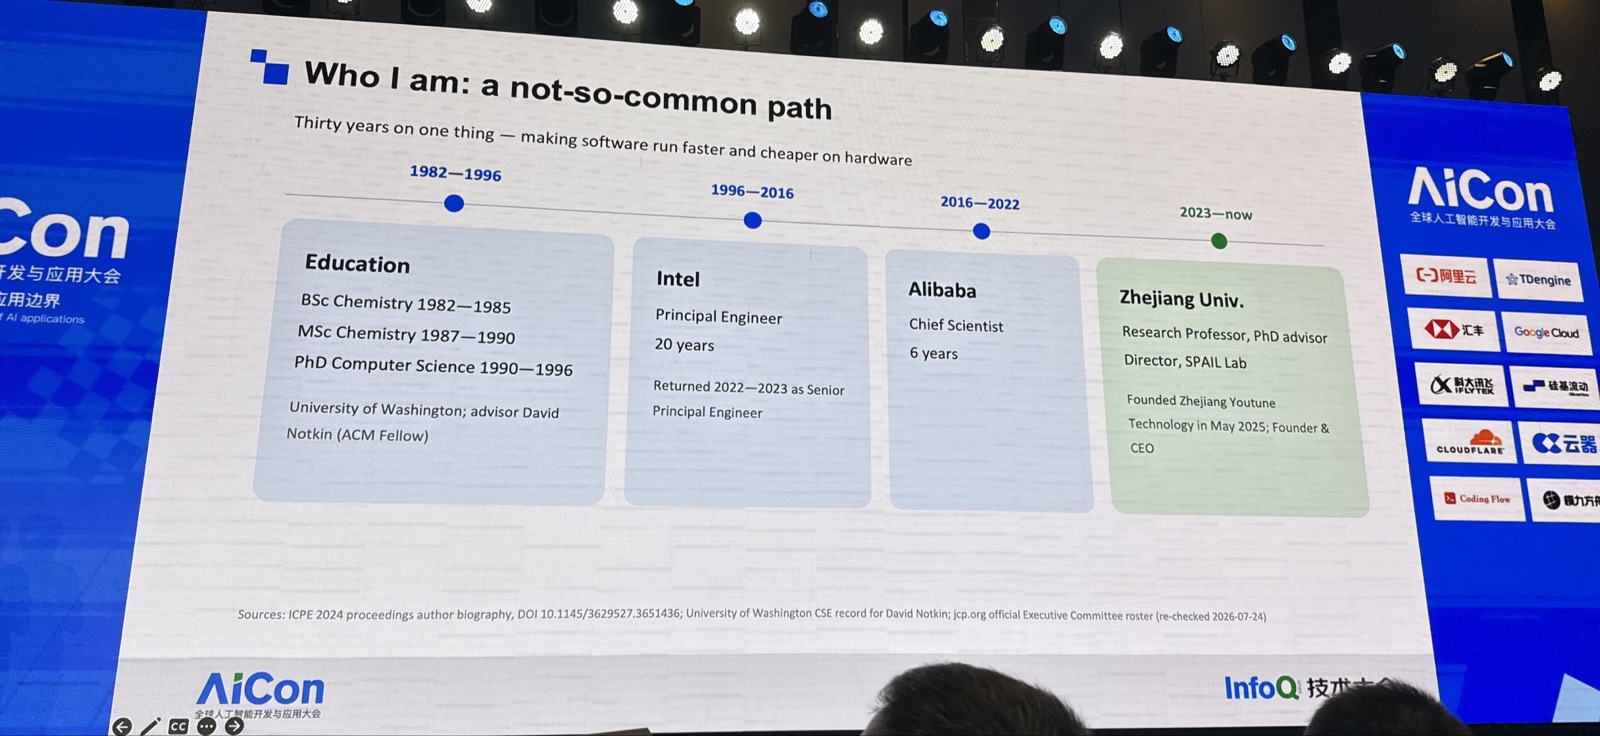
TL;DR:在 AICON 的演講中,浙江大學軟體學院周经森(Kingsum Chow)博士指出,AI 模型規模與推理使用量持續推升算力、記憶體與能源需求;效能工程的任務不只是「跑更快」,更是以更少資源完成同一件事。要做到這點,必須同時處理模型、執行期與硬體三個層面,並建立可信、可比較的效能資料,讓優化能從依賴個別專家經驗,逐步走向資料驅動與自動化。
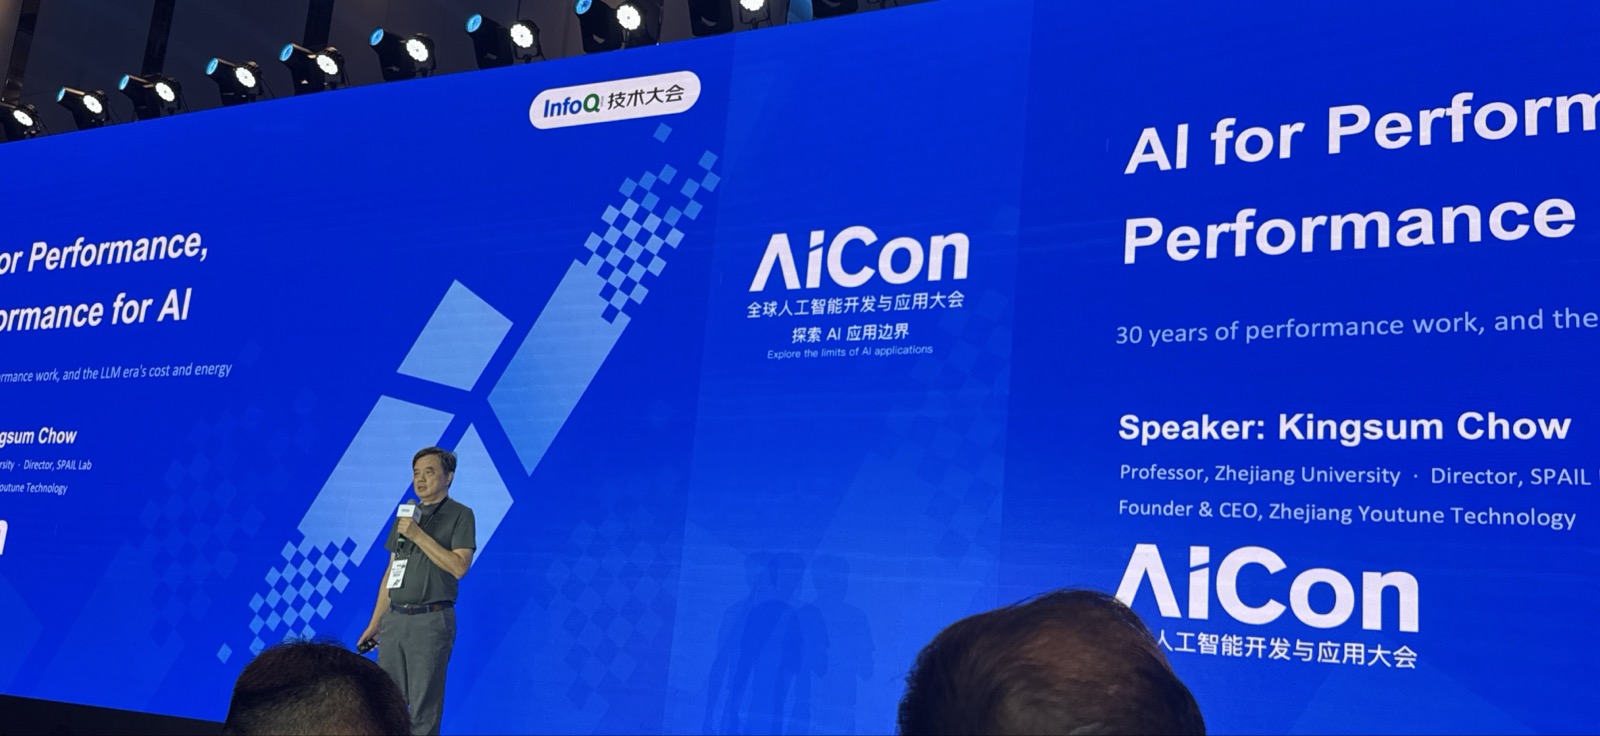
效能不只是速度,而是AI的資源帳本
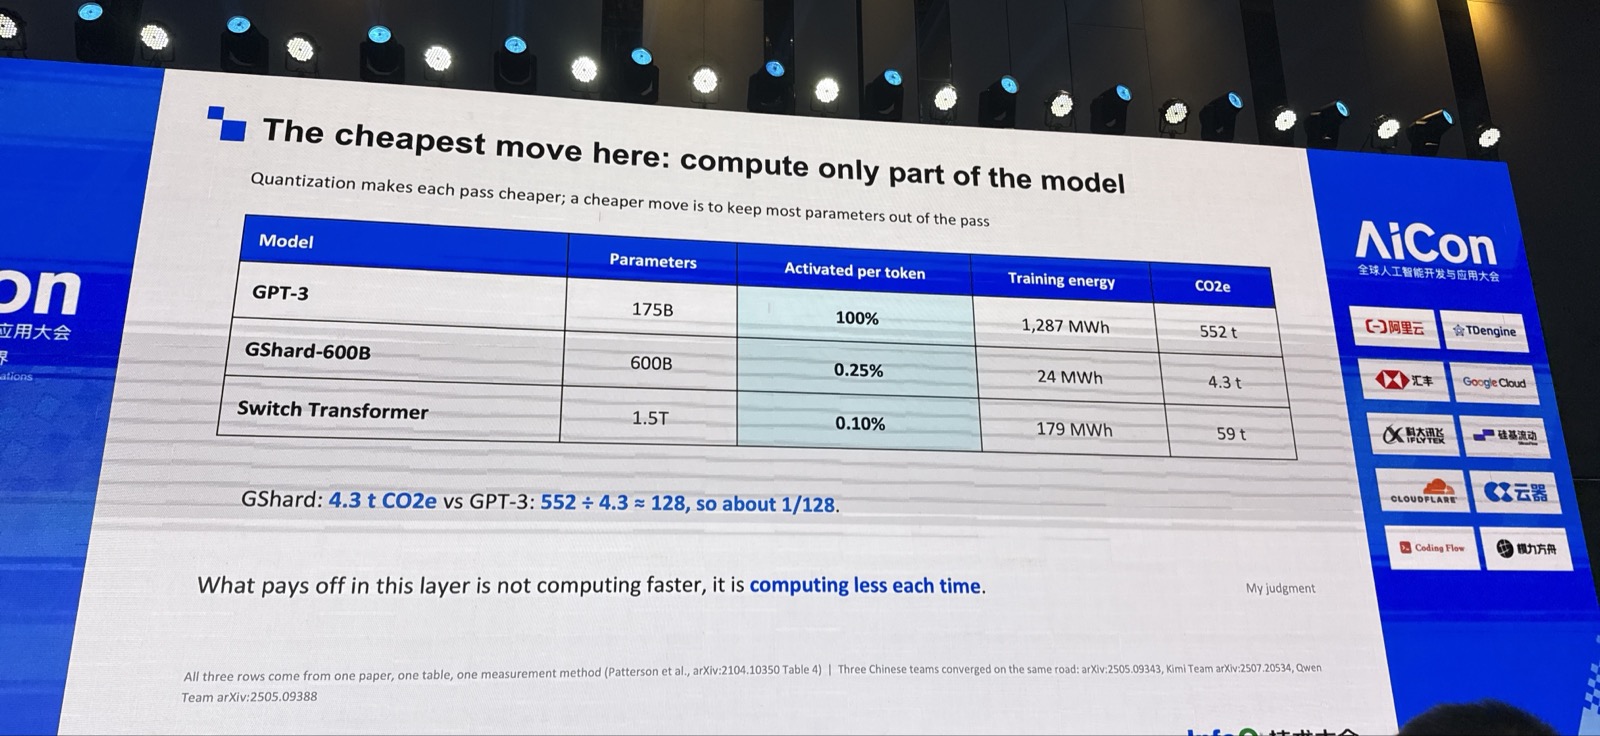
周博士以長期從事效能優化的經驗切入:常見目標包括讓系統更快、以更少資源完成更多工作,或使用較低成本的硬體。但面對大模型,這些短期指標必須放進更大的資源帳本來看。模型訓練與大量推理會消耗電力、硬體與記憶體;演講以碳排放作為理解資源耗損的視角,提醒AI的效益不能脫離環境代價。
效能優化AI推理資源消耗碳排放吞吐量延遲
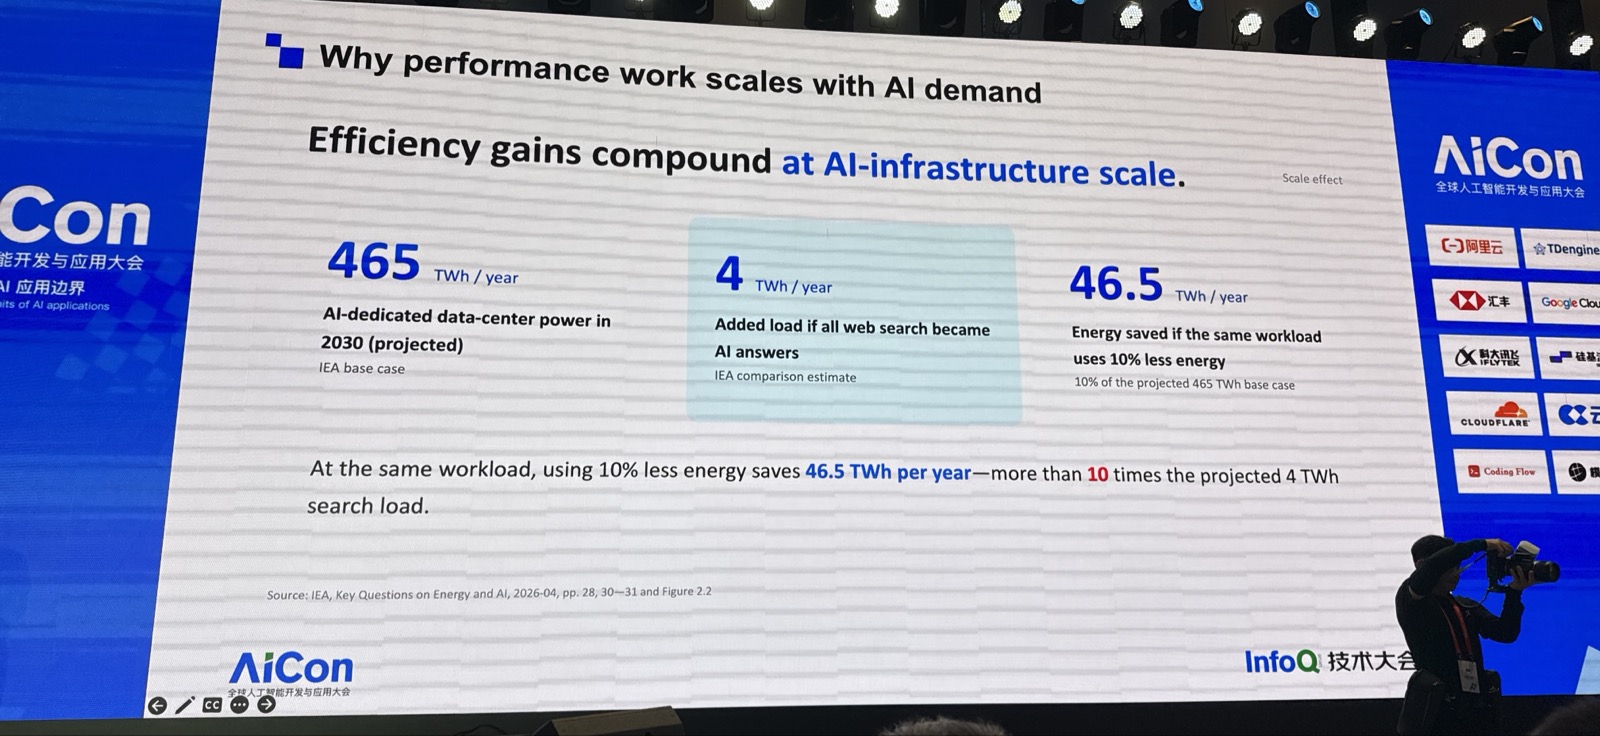
演講中特別比較了傳統網路搜尋與直接使用大模型回答問題的資源意涵:當使用習慣全面轉向生成式回答,累積的基礎設施需求可能十分可觀。因此,推理端的優化具有槓桿效果——即使單次請求只省下一小段計算,乘上大規模使用量後,仍可能轉化為可觀的能源節省。
「我們是不希望 AI 對地球產生很多的傷害。」
— 周经森博士
三層優化:模型、執行期與硬體協同
AI效能優化不是單一旋鈕,而比較像調校一套彼此耦合的傳動系統。周博士將問題拆為三層:模型層可調整模型結構與參數規模;執行期層涉及排程、資源配置與記憶體配置;硬體層則要面對CPU、GPU、NPU及不同指令集與記憶體架構。任何一層的改動,都可能影響其他層的效率與可攜性。
- 模型層:在滿足任務需求下,審慎選擇模型與參數規模,避免把不必要的模型容量轉成持續性的資源負擔。
- 執行期層:透過排程與配置,讓大量請求、模型物件與可用資源更有效配對。
- 硬體層:不同裝置與生態系有不同特性;CUDA生態成熟,但異質硬體環境需要更多適配與探索。
記憶體是這套系統中格外關鍵的一環。筆記所強調的「省內存」,對應到演講中的核心挑戰:模型參數與執行需求增加時,記憶體不僅影響能否部署,也直接影響成本。講者提及可透過記憶體相關技術降低資源消耗,並指出自動化處理記憶體配置,是支援企業AI應用的重要方向。
在伺服器端,NUMA與異質記憶體讓「資料放在哪裡」成為效能問題。就像倉庫中貨物離作業員越遠、搬運成本越高,資料若放在距離運算單元較遠的記憶體節點,存取延遲與效能都可能受到影響。實務上需依工作負載可接受的速度與成本,在不同CPU、NPU及記憶體資源間進行配置。
MemoryNUMA排程資源配置CUDA異質運算
從Python到C:優化招式與可攜性的拉鋸
周博士以一個案例說明,Python程式若成為AI工作負載的瓶頸,可將關鍵程式碼轉為C來改善效能。這個做法有趣之處在於,它把高階語言的開發便利性與低階程式的執行效率分開處理:先找出真正昂貴的路徑,再針對該處下手,而不是一開始就全面重寫。筆記也進一步提出值得延伸的問題:若由Python轉為C有效,是否還能繼續下探至組合語言?答案取決於效益是否值得額外的維護與可攜性成本。
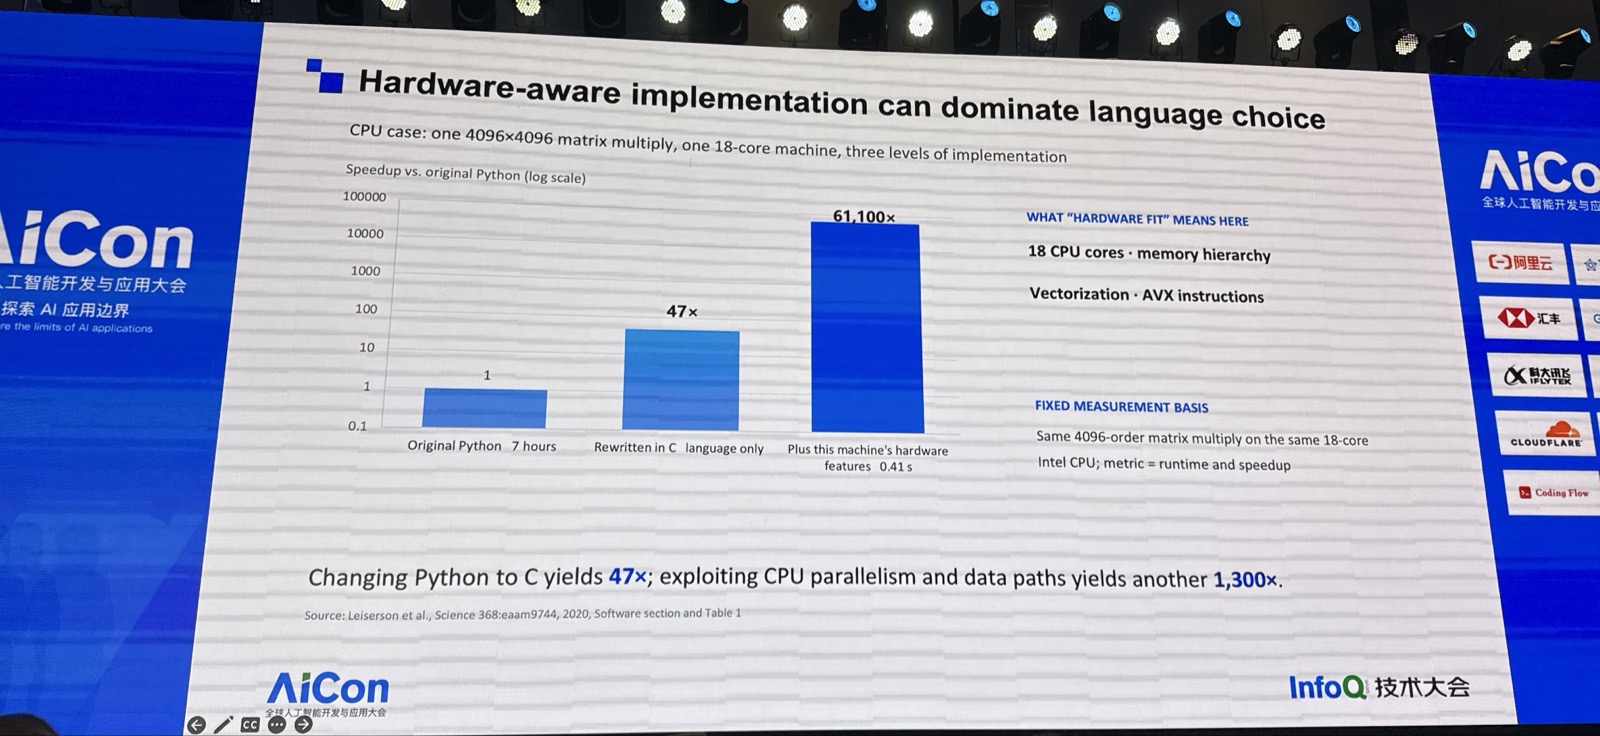
案例中進一步談到CPU向量化指令,例如AVX可在一次操作中處理多筆資料。然而,針對特定指令集做的極致優化,未必能直接移植到其他架構;例如不同CPU架構可能需要不同的向量化機制。這正是效能工程的典型取捨:專用優化可跑得很快,通用方案則較容易跨平台部署。編譯器與多版本程式碼的角色,就是在兩者之間尋找平衡。
「不管是什麼 model,都要跑在硬體上面。」
— 周经森博士
先相信資料嗎?效能量測的五個陷阱
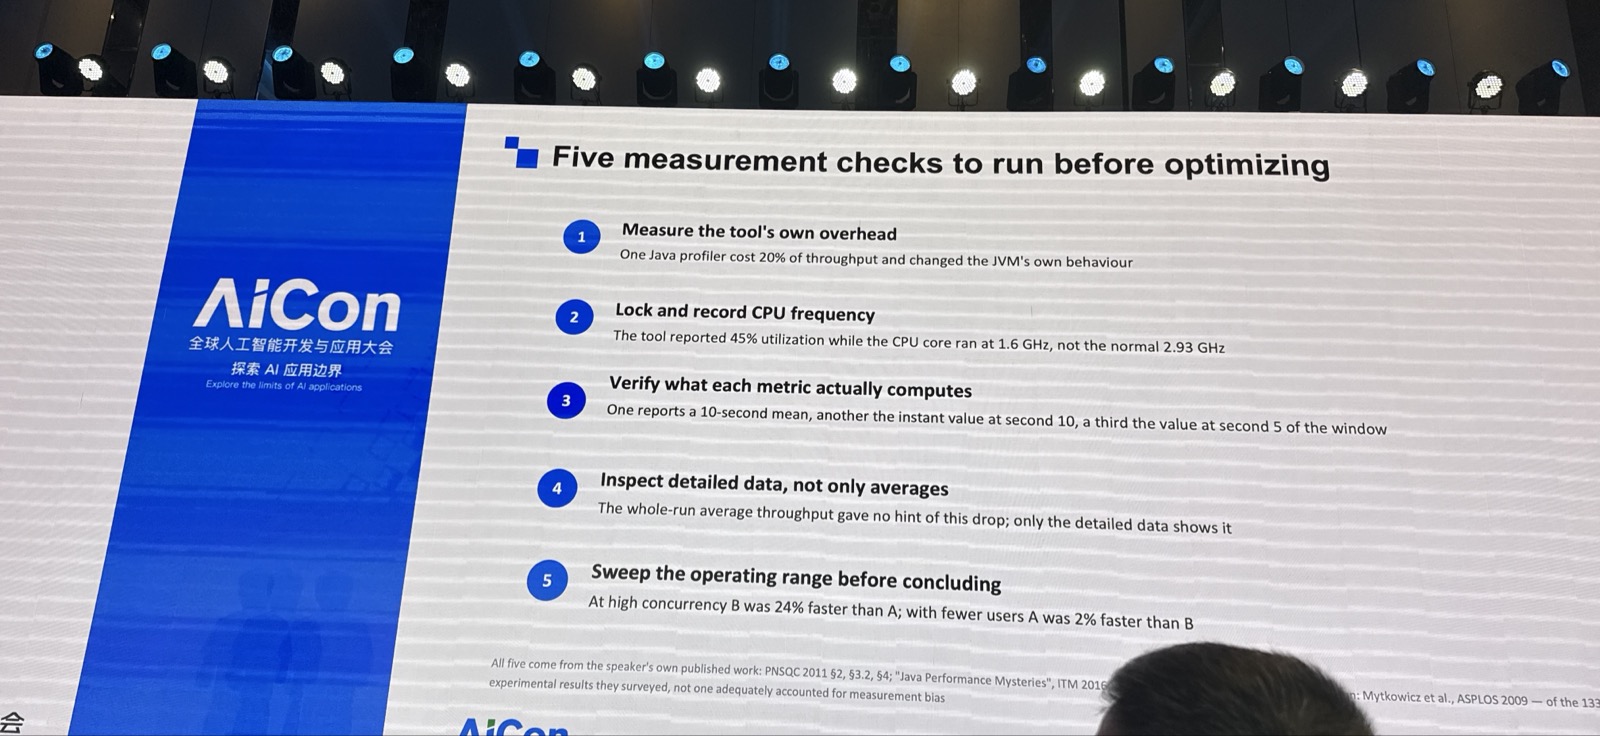
若效能優化像診療,量測資料就是檢驗報告;報告失真,再精密的處方也可能用錯地方。講者提醒,效能資料的採集工具本身會帶來額外負擔,可能改變被量測程式的行為;不同硬體廠商即使使用名稱相同的指標,其定義與計算方式也可能不同。因此,跨平台或跨工具比較數據時,不能只看表面數字。
- 量測干擾:採樣工具會消耗資源,可能改變原始工作負載的表現。
- 環境波動:硬體頻率與其他外在條件會讓相同軟體在不同時間得到不同結果。
- 指標不可直接類比:例如不同平台的TMA指標,即使名稱相近,內部定義仍可能有差異。
- 平均值遮蔽問題:程式不同階段的行為可能不同,只看整段執行的統計平均,容易漏掉真正瓶頸。
- 執行期動態性:軟體運作過程中的資源配置與負載變化,會增加資料解讀難度。
演講中特別提到TMA(Top-Down Microarchitecture Analysis)等方法,作為理解處理器微架構效能的分析工具。但工具輸出的數字不是結論,而是問題的入口。例如CPI(Cycles Per Instruction,每條指令平均所需時脈週期)可描述底層執行狀態,卻不能單獨回答「為什麼慢」;仍需結合程式行為、系統配置與其他指標判讀。
效能量測CPITMATop-Down Microarchitecture Analysis代表性資料量測開銷
別只修最快的瓶頸:Amdahl定律與多指標決策
即使某個元件獲得大幅加速,整體系統也未必等比例變快,這正是Amdahl定律的提醒。講者以FlashAttention為例:即使Attention機制得到顯著改善,若它只佔總執行時間的一部分,系統端可見的加速幅度仍會受到其他未改善部分限制。換言之,局部優化像拓寬一段道路;若前後路段仍壅塞,整體車程不會按道路寬度等比例縮短。
同樣地,效能不能只用單一指標裁決。某個模型或系統可能在速度上表現突出,卻在能源消耗上未必同樣有利。因此,工程團隊應先定義最終目標:是追求吞吐量、低延遲、成本、能源效率,還是多者的折衷?只有將評估指標與實際任務對齊,優化才不會變成漂亮但無用的數字競賽。
「我們不一定能夠從某一個指標,看到它在其他方面進行的效果。」
— 周经森博士
讓AI協助優化,但不把判斷力交出去
面對大量且複雜的效能資料,講者認為AI可協助工程師處理資料採集、缺失資料、異常訊號與初步歸因,進而提升分析效率。不過,AI並非自動產生正確答案的捷徑:若資料缺乏代表性、指標定義不一致,或量測本身有干擾,模型只會更快地放大不可靠的結論。資料推動的前提,是先把資料的來源、品質與脈絡管理好。
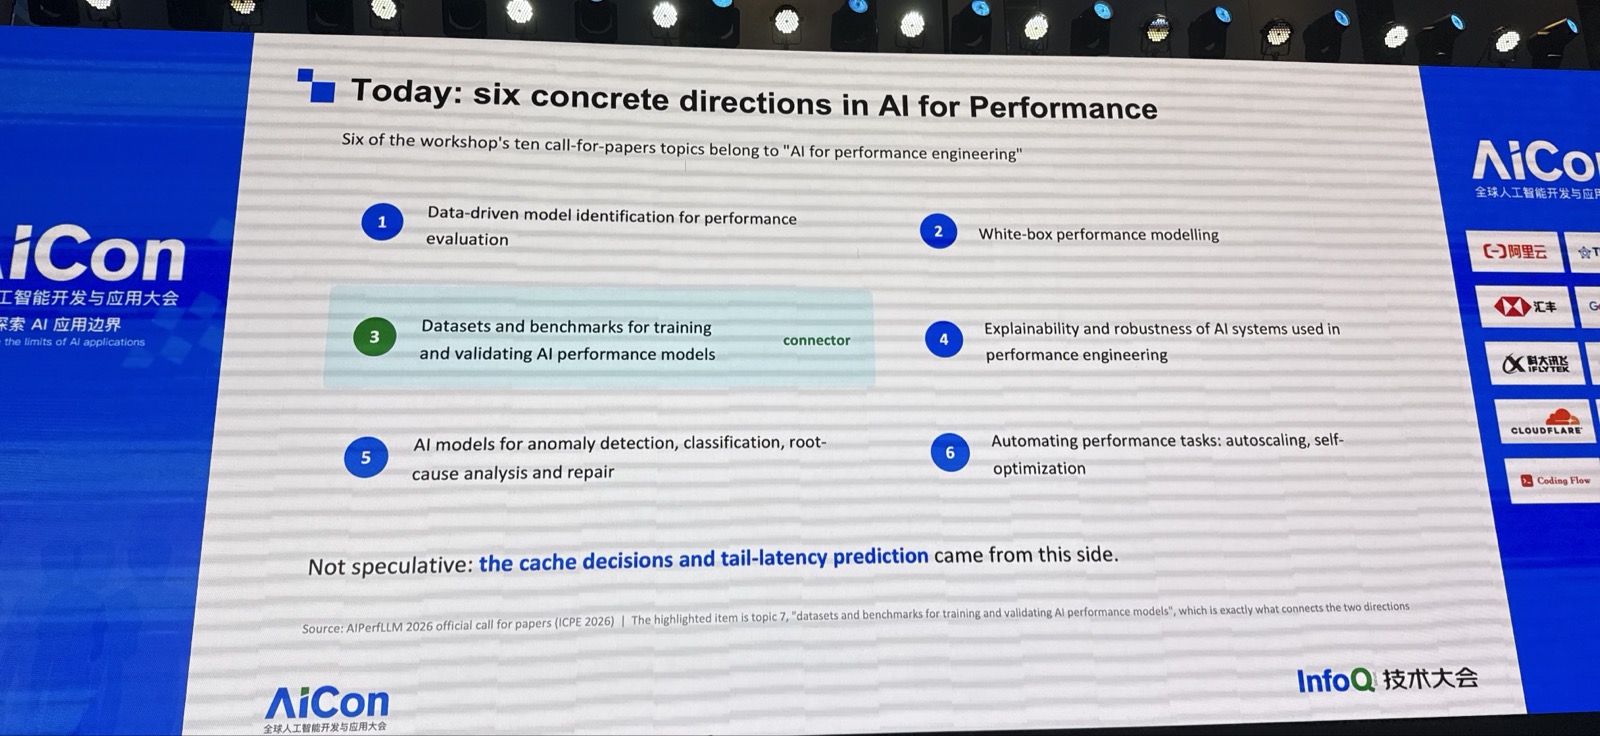
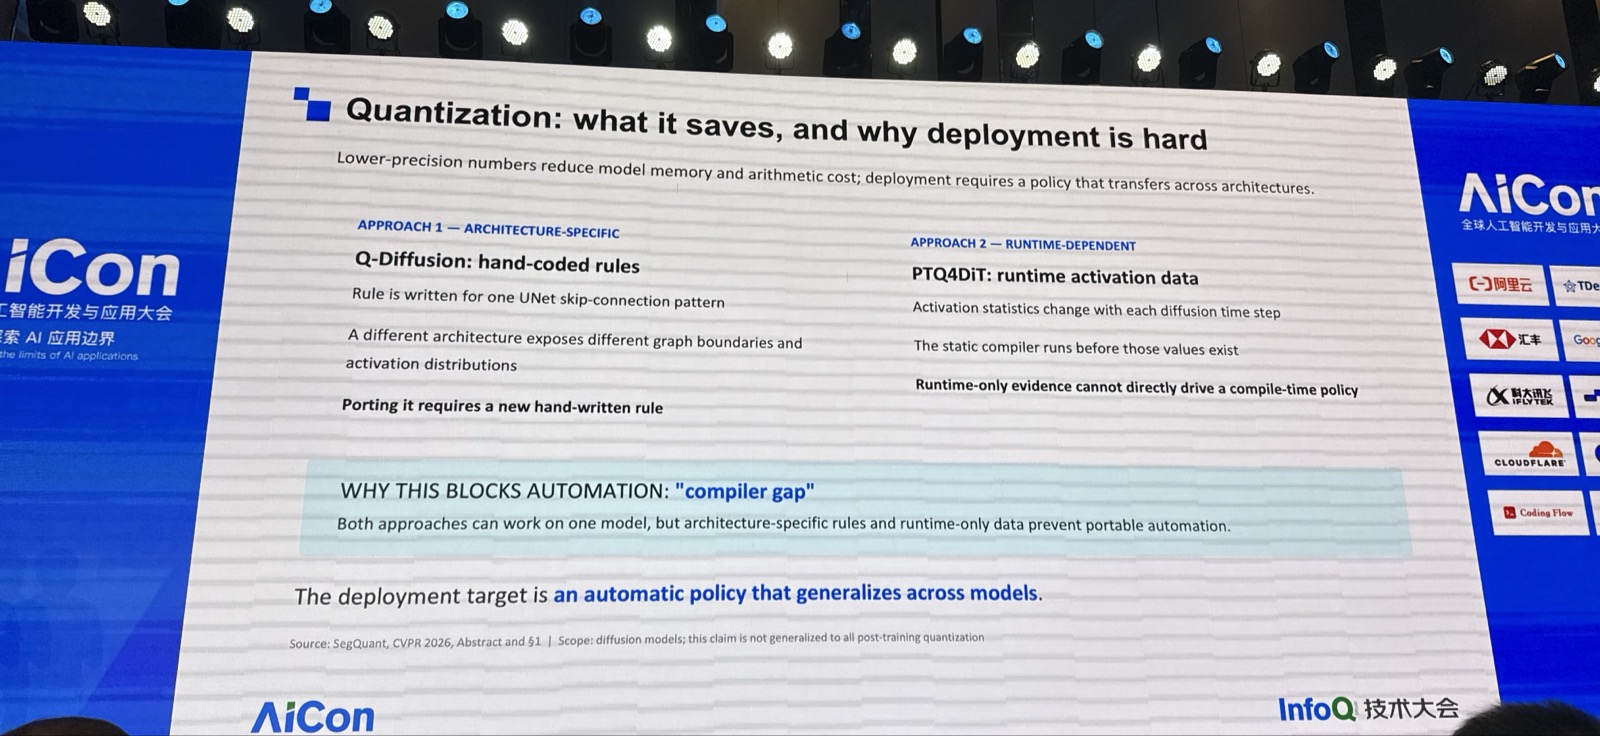
周博士也坦言,通用、全自動的優化目前仍未完全走通。個別軟體與個別案例可以做到相當好的效果,但要把能力泛化到不同平台、不同應用與不同目標,仍需要公開資料、工具鏈與專家經驗共同支撐。這也是「AI for Performance」的務實意義:不是取代工程師,而是把稀缺的效能專業沉澱為可重複使用的資料與流程。
重點回顧
- AI效能工程的價值,在於同時降低成本、改善體驗,並減少大規模運算帶來的資源與碳排壓力。
- 模型、執行期、硬體三層必須協同優化;記憶體配置與異質硬體適配,已是不可忽略的核心課題。
- 從Python轉C、使用向量化指令等手法能帶來加速,但需評估跨平台可攜性與維護成本。
- 量測資料不是客觀真理的自動輸出;工具開銷、環境波動、指標定義與平均值,都可能造成誤判。
- Amdahl定律提醒我們,局部加速不等於整體加速;效能、能耗與成本應依任務目標共同評估。
- 未來方向是以可信資料、工程經驗與AI輔助,讓效能優化逐步從手工技藝走向可擴展的自動化能力。
AI for PerformancePerformance for AI資料推動自動化優化能源效率Amdahl定律