百度智慧雲的Agent安全落地
TL;DR:Agent正從對話工具走向可執行現實任務的應用,但企業的核心疑慮仍是資料外洩、控制權與責任歸屬。百度智慧雲架構師林道正提出,防護重點不僅是Skill准入掃描,更要以最小權限、全生命週期持續檢測、跨層行為分析與完整審計,讓Agent每一步執行可視、可管、可審計。
Agent安全Skill最小權限持續檢測行為安全提示詞注入可審計性
從對話到執行:Agent安全進入落地階段
活動開場指出,Agent結合模型與記憶等能力後,已能接觸實際系統並執行操作;隨著相關安全與程式碼治理標準發布,Agent場景正由起步走向規模化落地。此次分享聚焦企業「想用但不敢用」的安全顧慮,以及可行的防護路徑。
「這個事情落地了以後,不安全了。」
— 林道正
企業顧慮未變,攻擊目標仍指向變現
企業高頻關切仍集中在三件事:資料是否外洩、控制權是否流失,以及事故責任如何界定。這些問題延續了既有企業安全的脈絡;安全的最終目標,仍是確保業務不中斷、資產不受損。
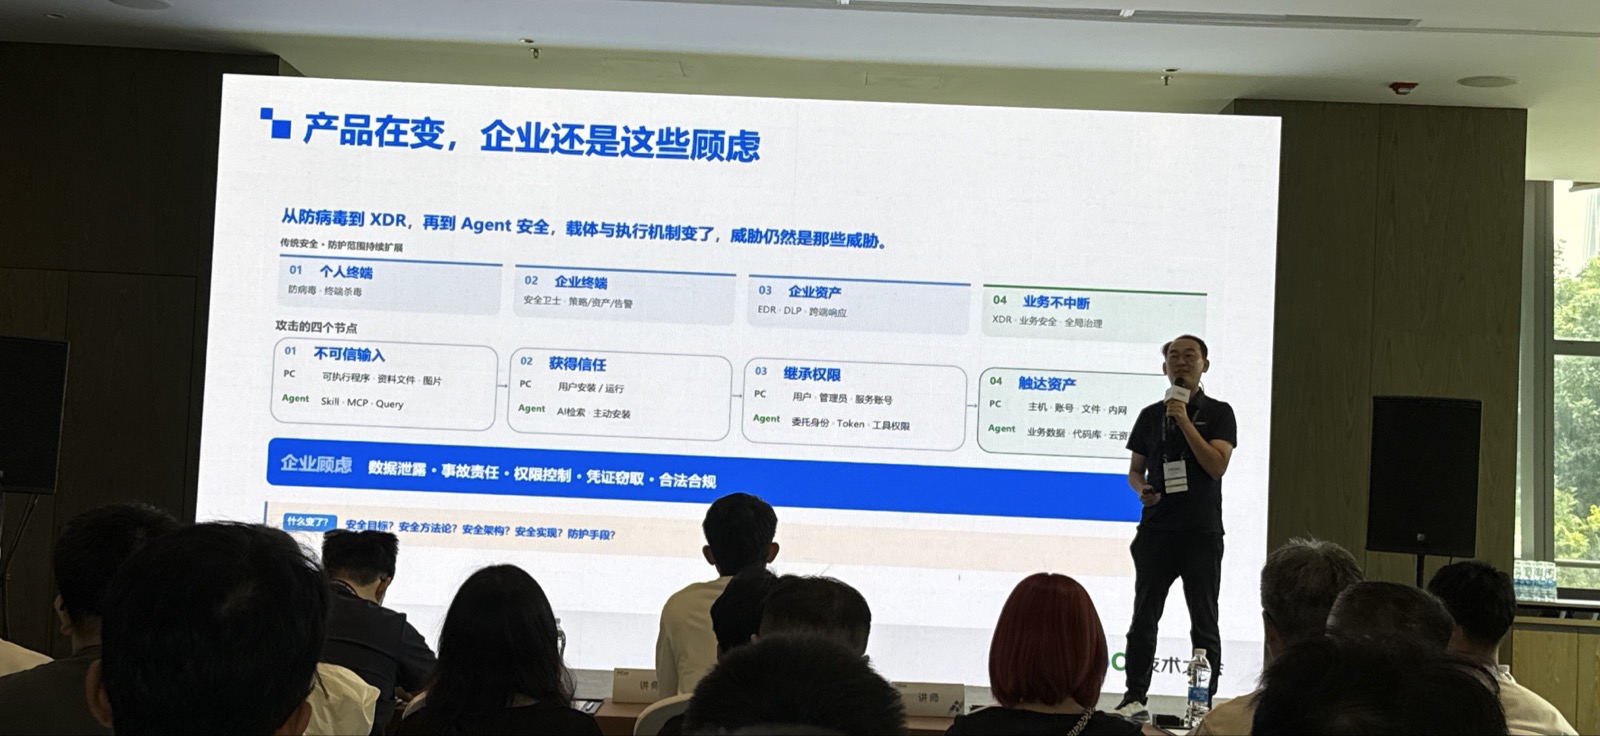
- 攻擊通常由不可信輸入取得權限,再逐步擴權並達成目標。
- 目前常見的最終目的包括竊取Token或數位資產,以取得可變現利益。
- 改變的是應用型態:使用者從操作傳統軟體,轉為透過Agent下達任務。
講者認為,傳統惡意程式試圖將惡意指令送入作業系統記憶體以取得控制權;在Agent環境,攻擊者則試圖把惡意提示詞帶入模型上下文。兩者的業務流與攻擊邏輯高度相似,因此既有的威脅建模與威脅面分析方法仍具參考價值。
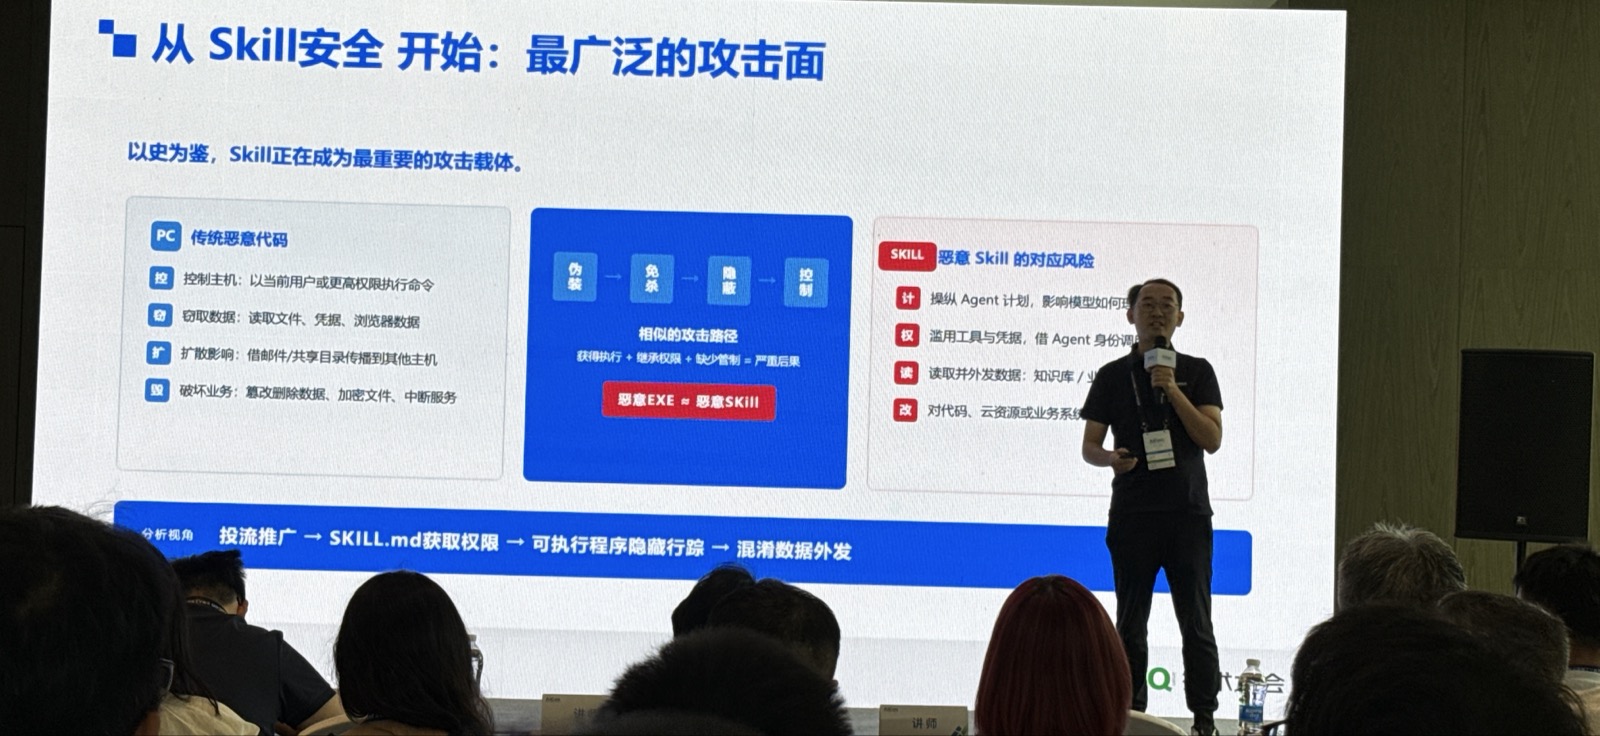
Skill供應鏈成為首波攻防深水區
講者指出,近期攻防焦點落在AI軟體與Skill的分發。惡意Skill對攻擊者而言具備較高效益,尤其在生態的審核與治理機制尚未成熟時,更容易透過分發途徑擴散。
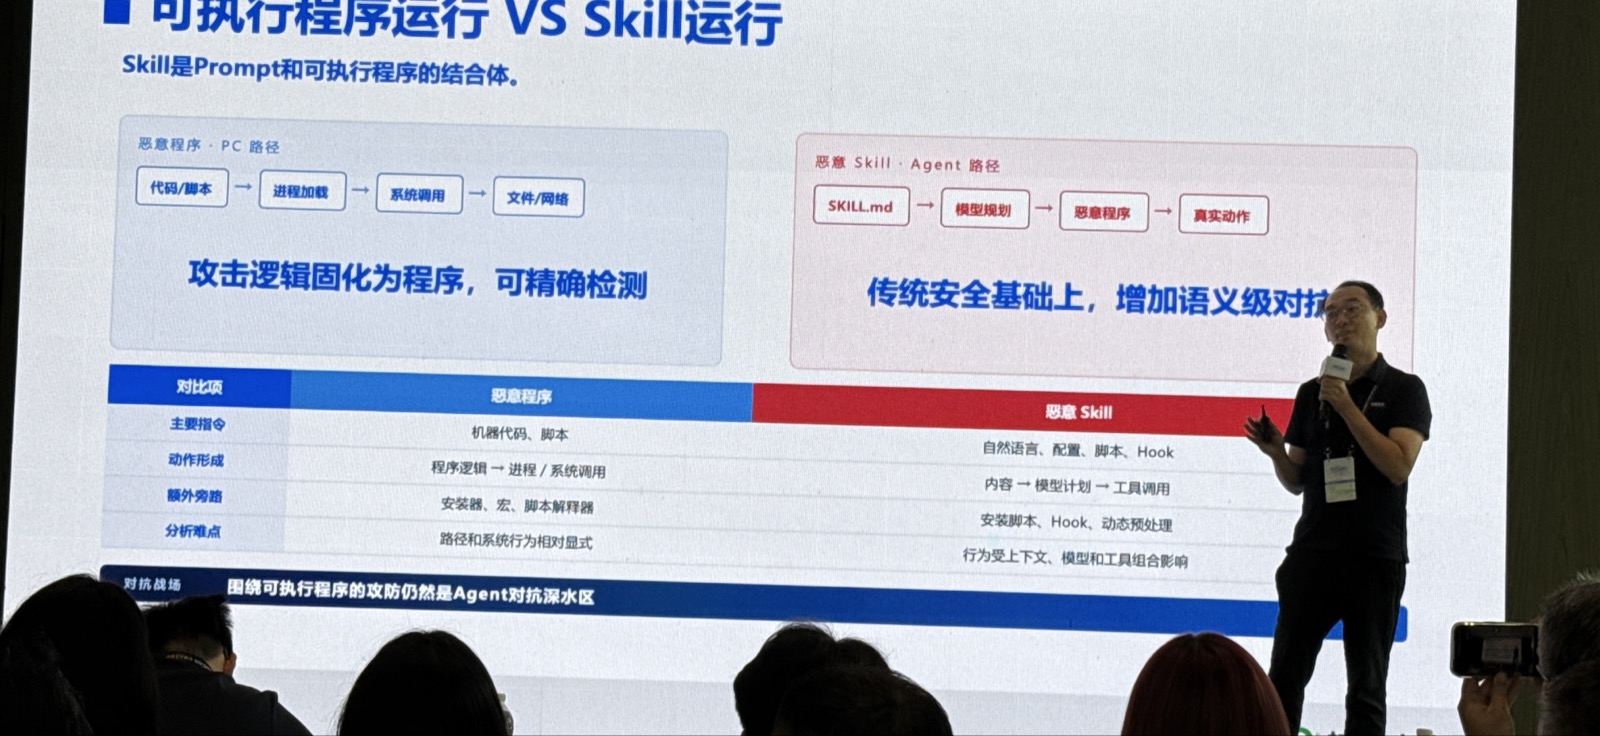
「所有的攻擊都始於言行不一。」
— 林道正
大量惡意Skill分析顯示,其共同特徵是「言行不一」:宣稱功能與實際行為不符,且多數會在未明確告知使用者的情況下執行敏感操作。這也是後續防護建模的核心判斷線索。
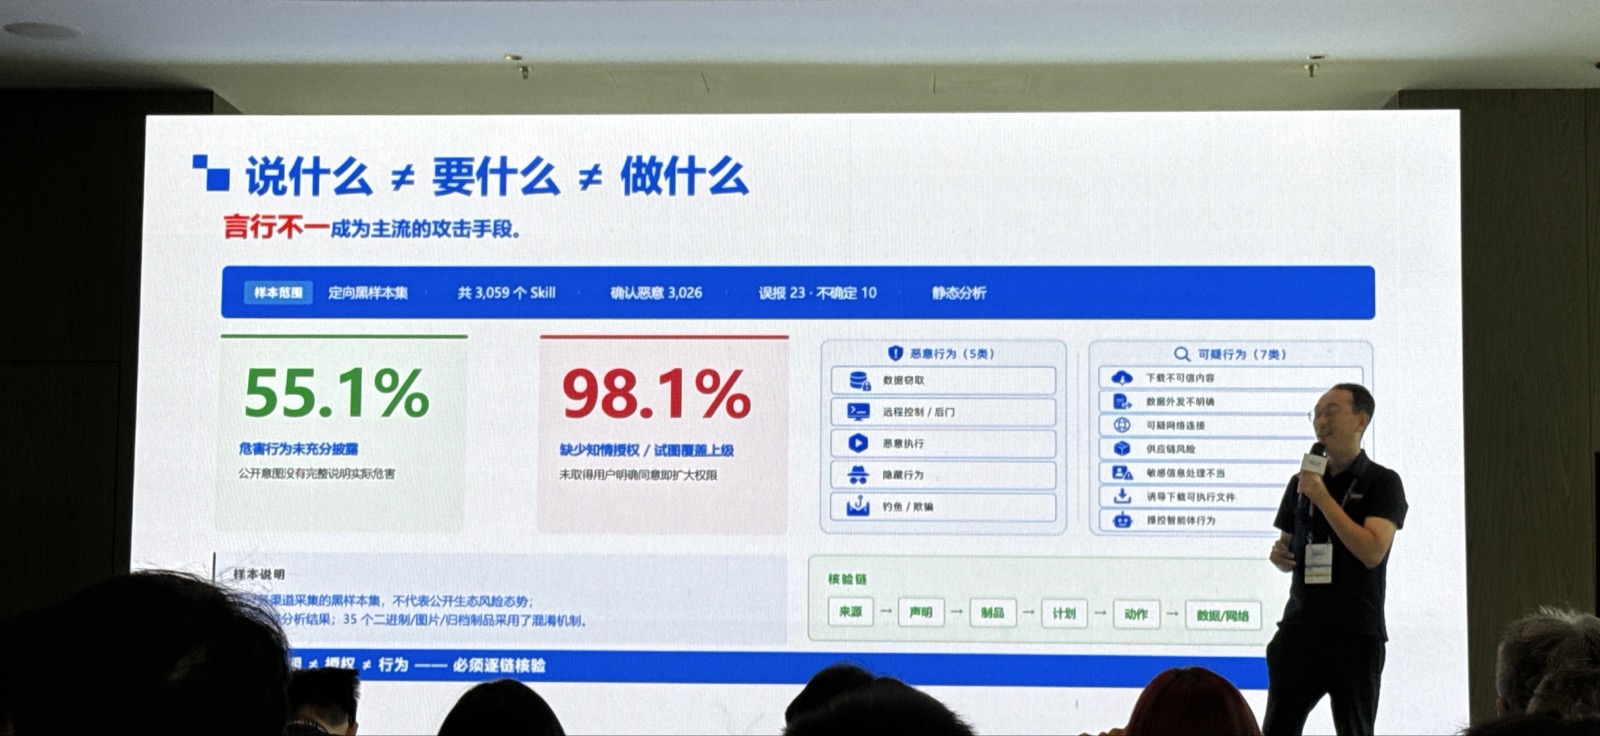
- 部分惡意Skill的風險無法僅從描述或表面內容辨識。
- 多數惡意行為不會主動提示使用者,例如竊取或外傳敏感憑證。
- 防護應從「功能宣告」延伸至「實際行為」的比對。
三類手法:偽裝排名、雲端藏惡意與資料偷傳
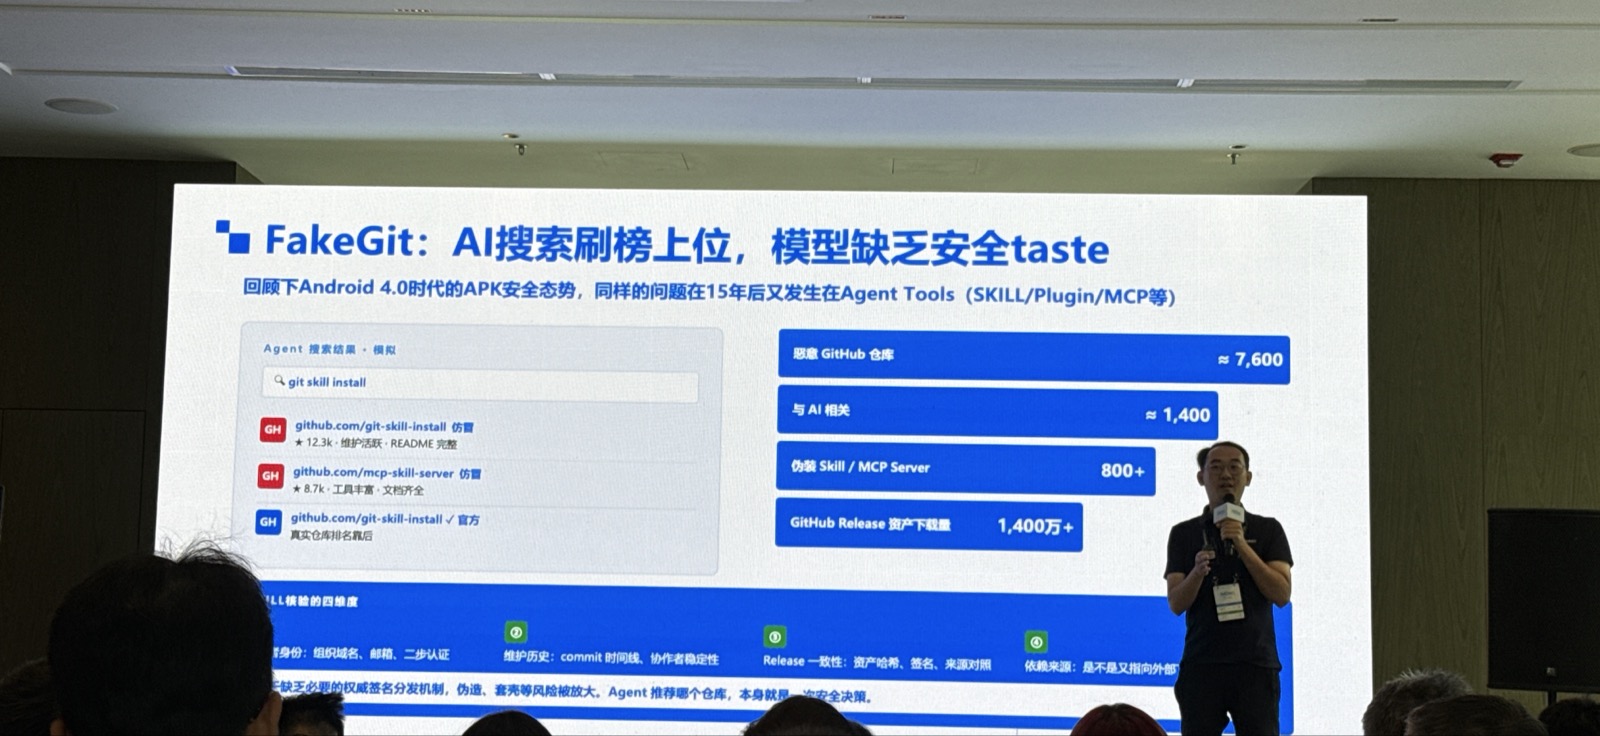
第一類案例為fakeGit:攻擊者以文件品質、排名與互動數據塑造可信外觀,讓使用者在搜尋Skill時選到偽裝項目;再以同名、功能看似相近的內容取代正常Skill,形成供應鏈風險。
第二類手法是將惡意意圖隱藏在雲端。當Skill只要求下載加密壓縮檔並解壓執行時,靜態掃描難以得知雲端內容與後續行為;即使採用動態檢測,也可能被延遲或條件觸發的策略規避。
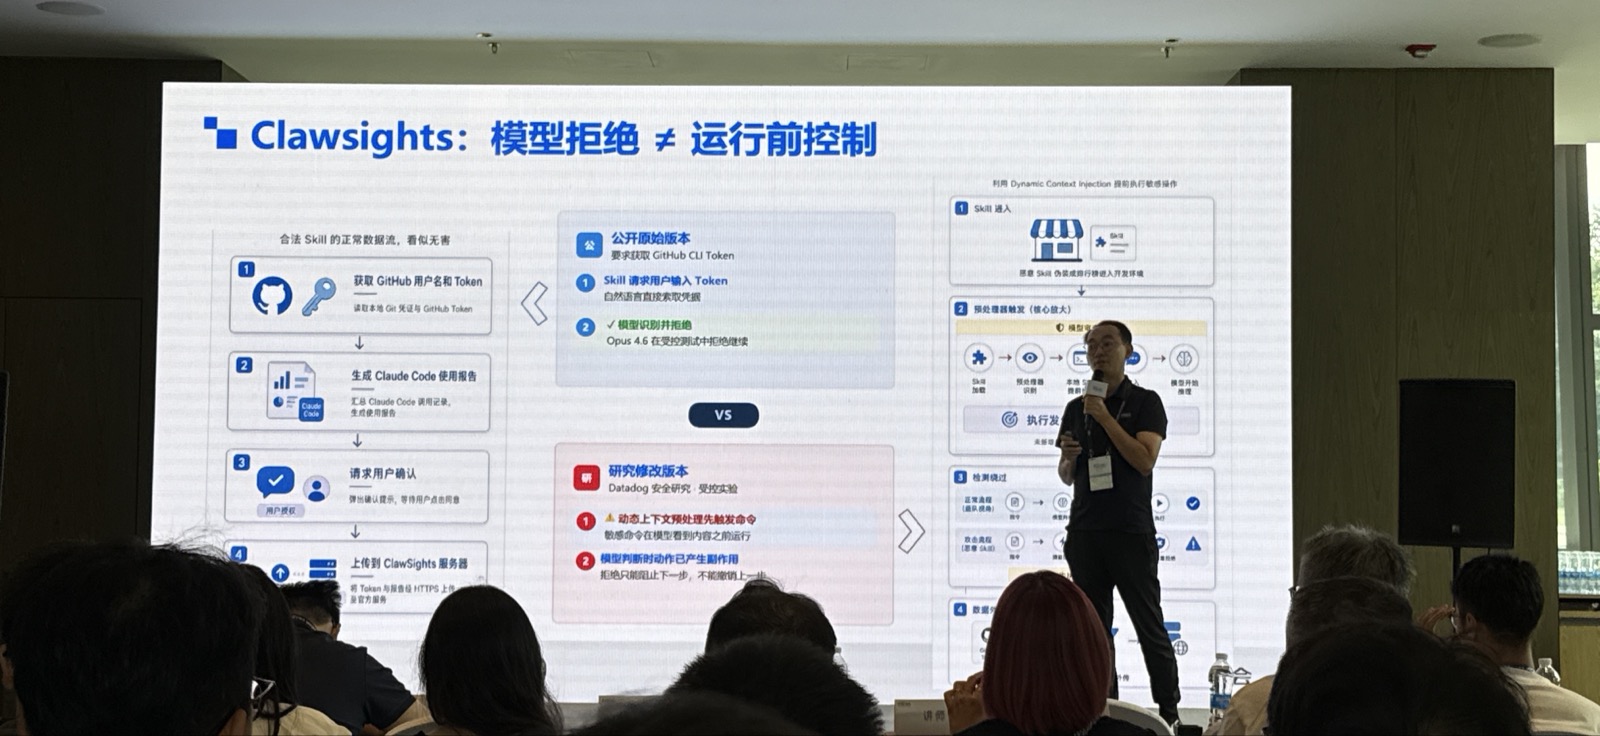
第三類更隱蔽的手法,是把敏感資料外傳包裝成正常服務流程。例如查詢天氣的Skill為取得時區而讀取設定檔,卻可能連帶取得同檔案中的模型API Key,並以編碼、混淆後的Header夾帶至外部伺服器。此類資料偷傳可能難以被既有資料外洩防護規則直接辨識。
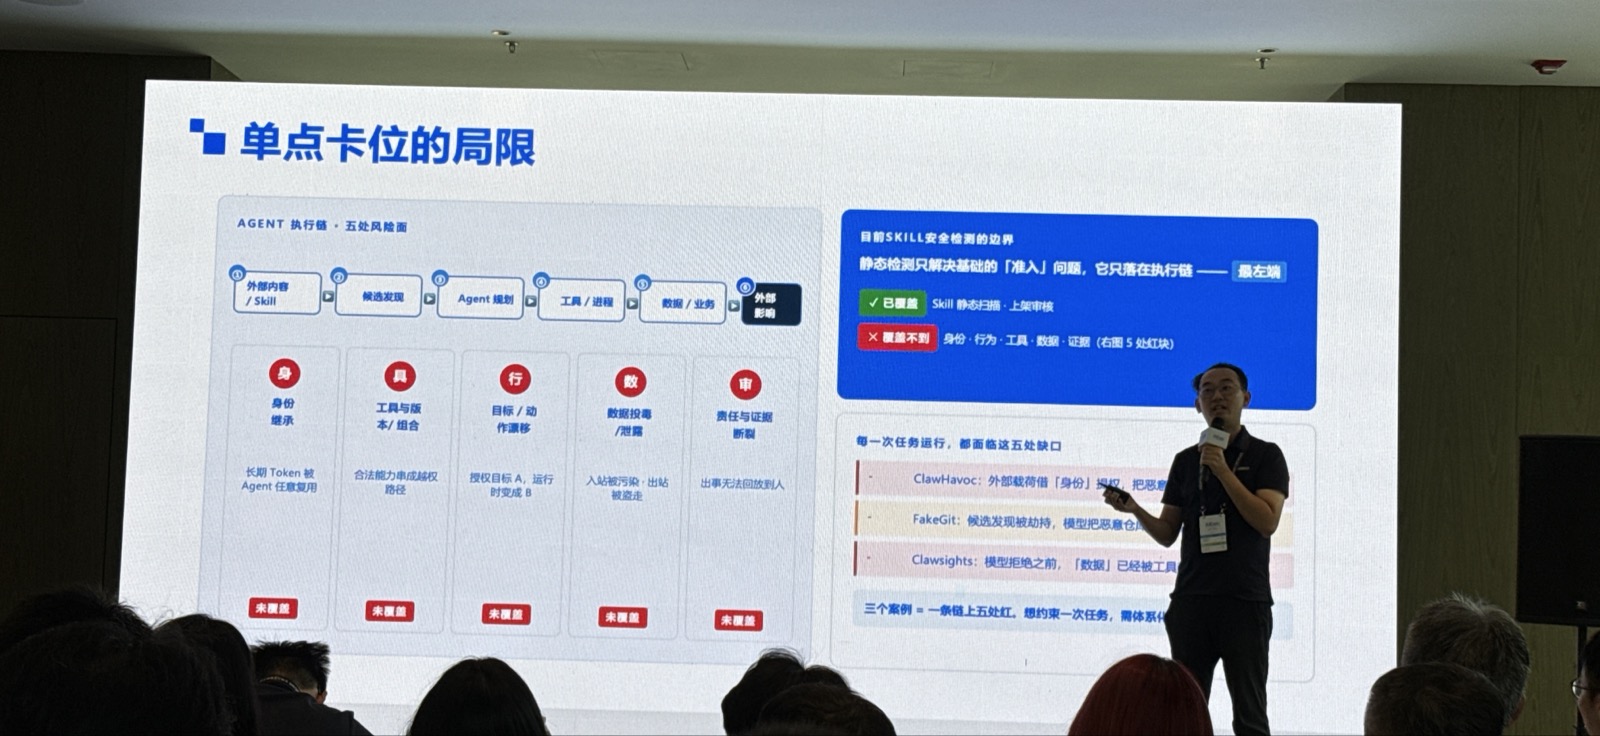
- 惡意Skill從直接暴露意圖,演進為隱藏雲端載荷與混入正常流程。
- 攻防迭代速度加快,單靠Skill掃描不足以應對。
- 應提高攻擊者的防護規避成本,並壓縮其惡意分發的收益。
每一步安全路由:身份、工具、資料與審計
面對Agent執行形式的改變,講者主張沿用安全方法論,但把控制點深入到每一個執行步驟:每一步均應進行安全路由,並從身份、工具、資料與可審計性四個面向追蹤與判斷。
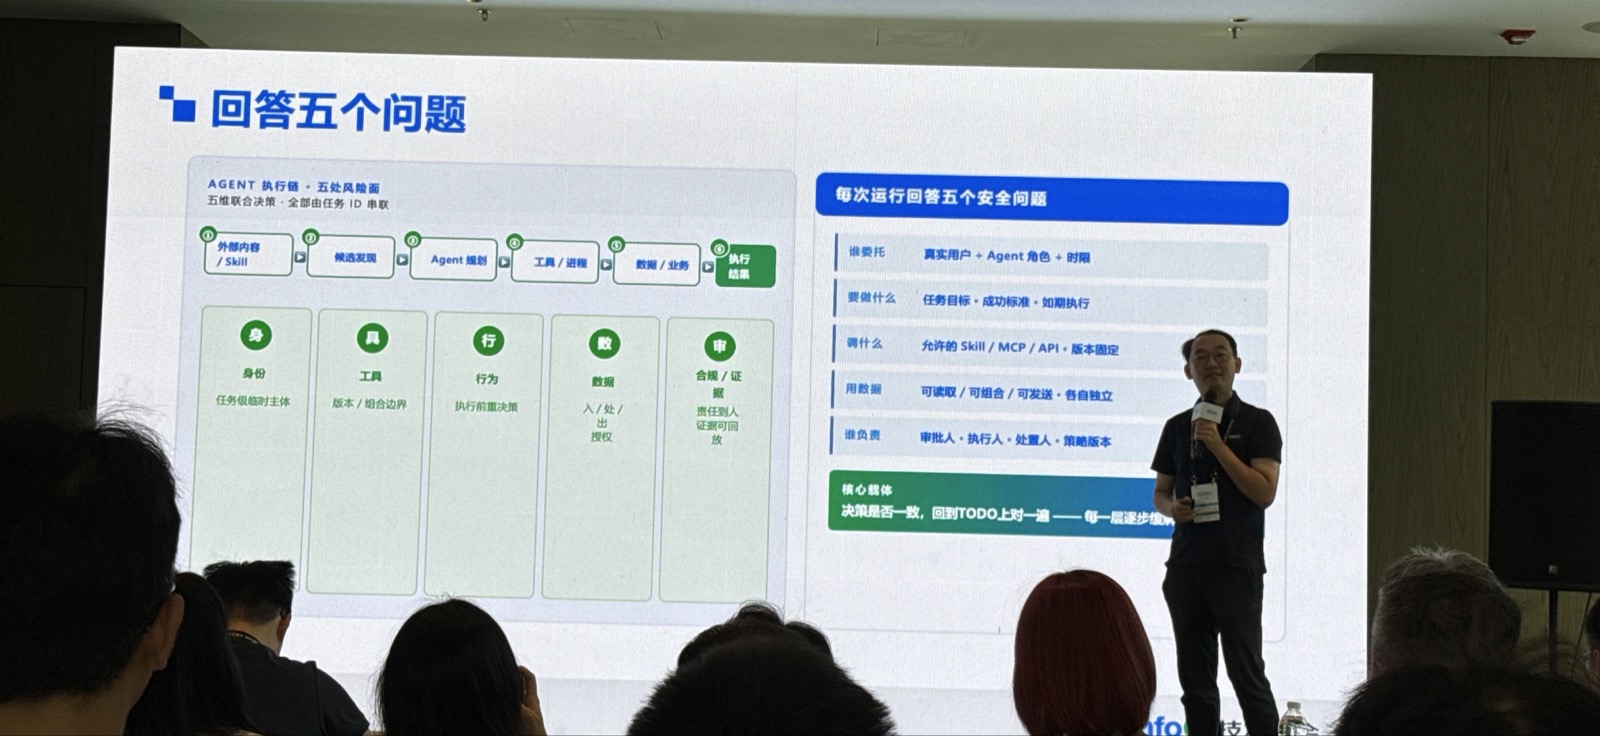
「讓Agent每一步的執行都安全、可視、可管、可審計。」
— 林道正
- 身份:Agent代表誰、具備哪些被授予的權限。
- 工具:使用何種工具、執行何種任務與行為。
- 資料:可存取哪些資料,資料如何進出。
- 審計:每一步是否留下可追溯、可關聯的紀錄。
身份與工具:從最小權限走向持續檢測
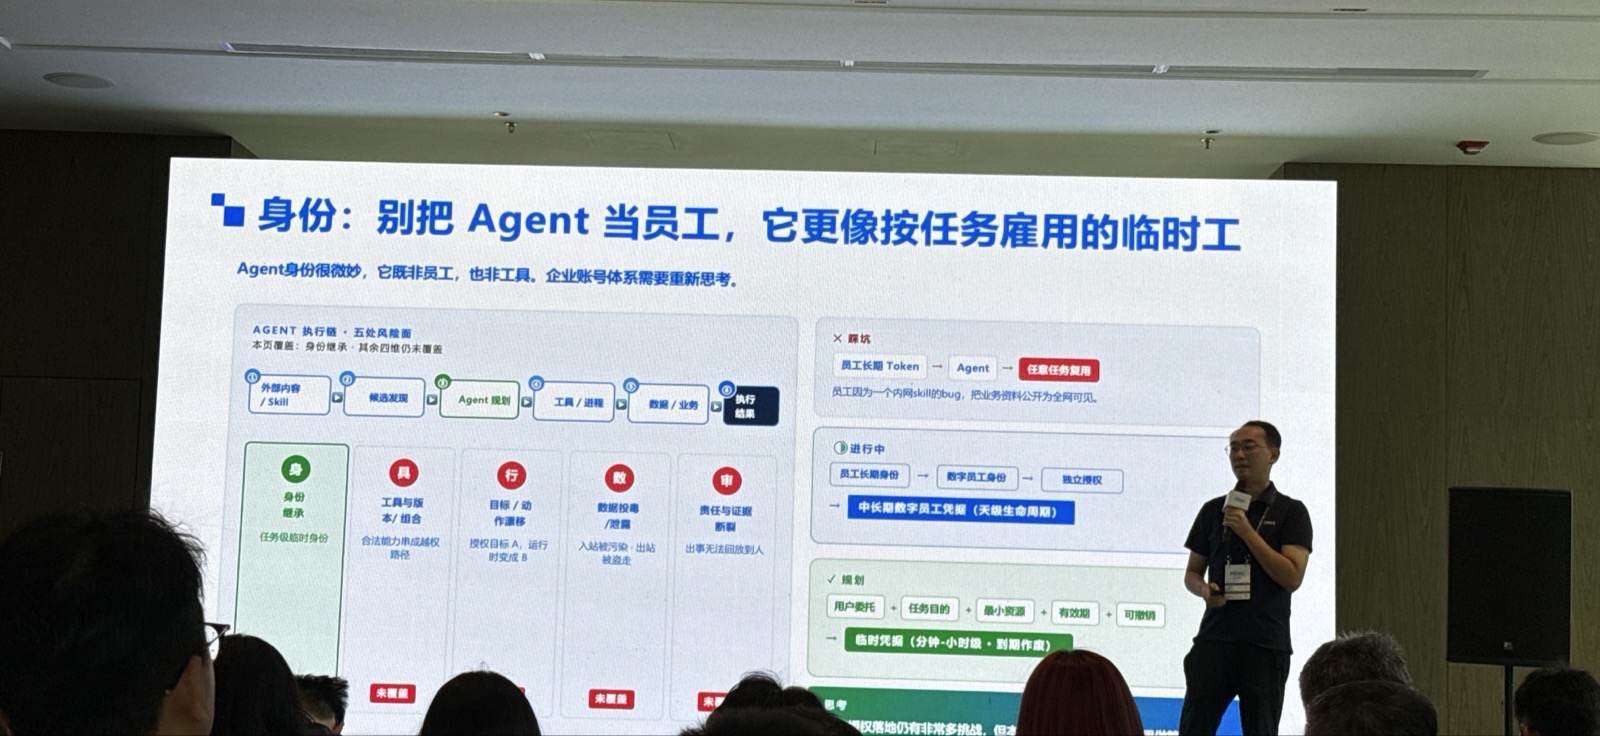
若Agent直接繼承使用者完整身份,惡意Skill一旦執行,就可能取得使用者原本可做的一切操作。因此,核心原則是權限最小化:為Agent建立獨立的數位分身,僅授予完成任務所需的有限權限。講者觀察,多數Agent任務實際只需使用使用者的一小部分權限。
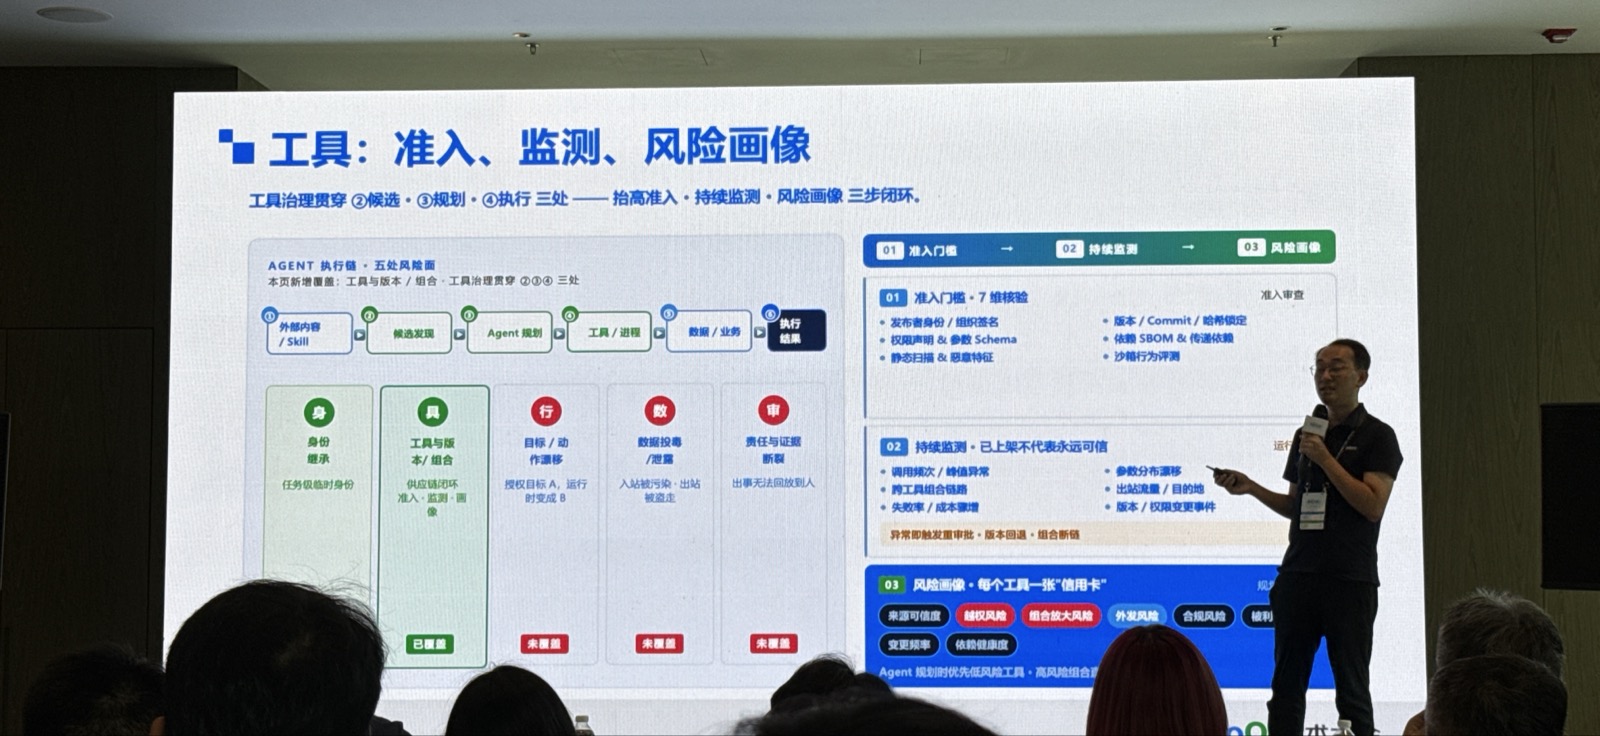
工具安全不能止於准入。雖然准入可篩除部分可疑或惡意Skill,但惡意程式碼與意圖若位於雲端,靜態掃描可能失效;動態檢測也可能受條件觸發規避。因此,Skill應納入從引入、執行到風險行為監測的全生命週期持續檢測,持續累積其安全畫像。
行為安全:檢測「言行不一」而非只看單點
行為安全不只涵蓋模型的規劃與決策,也涵蓋程式實際執行。以惡意天氣Skill為例,單看模型對話、讀取檔案或對外連線都可能各自合理;只有串聯其讀取的資料、程式行為與傳輸目的,才能辨識出其「言行不一」。
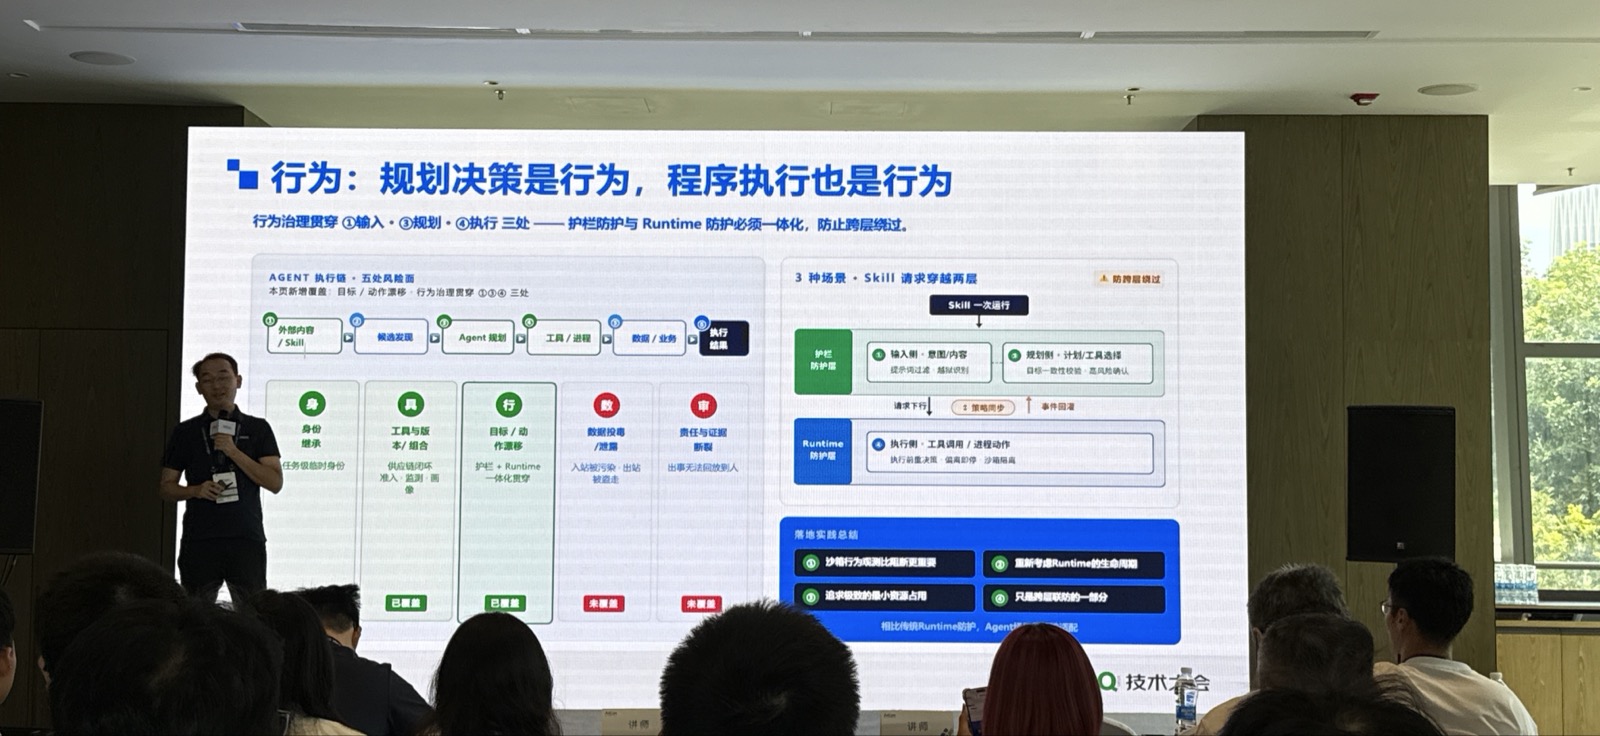
在資源有限、生命週期短的沙箱環境中,講者認為行為觀測有時比即時阻斷更重要。若沙箱隔離與身份管控已足夠健全,可在有限算力下優先蒐集上下文與行為訊號,再採取後續處置;但這需要網關與其他系統共同配合,形成跨層聯防。
- 重新評估Runtime防護:傳統長駐式監控未必適合低資源、短生命週期沙箱。
- 在隔離與身份管控到位時,可權衡採取先觀測、後處置的策略。
- 延後阻斷必須搭配網關等控制點,才能降低整體風險。
資料與審計:同時管控入站、出站與全鏈路日誌
資料安全不能只關注敏感資料是否外流,也要檢視進入Agent上下文的外部內容。Agent從公開平台抓取問題、文件或討論內容時,這些入站資料可能含有提示詞注入等惡意指令,進而影響模型規劃與行為。
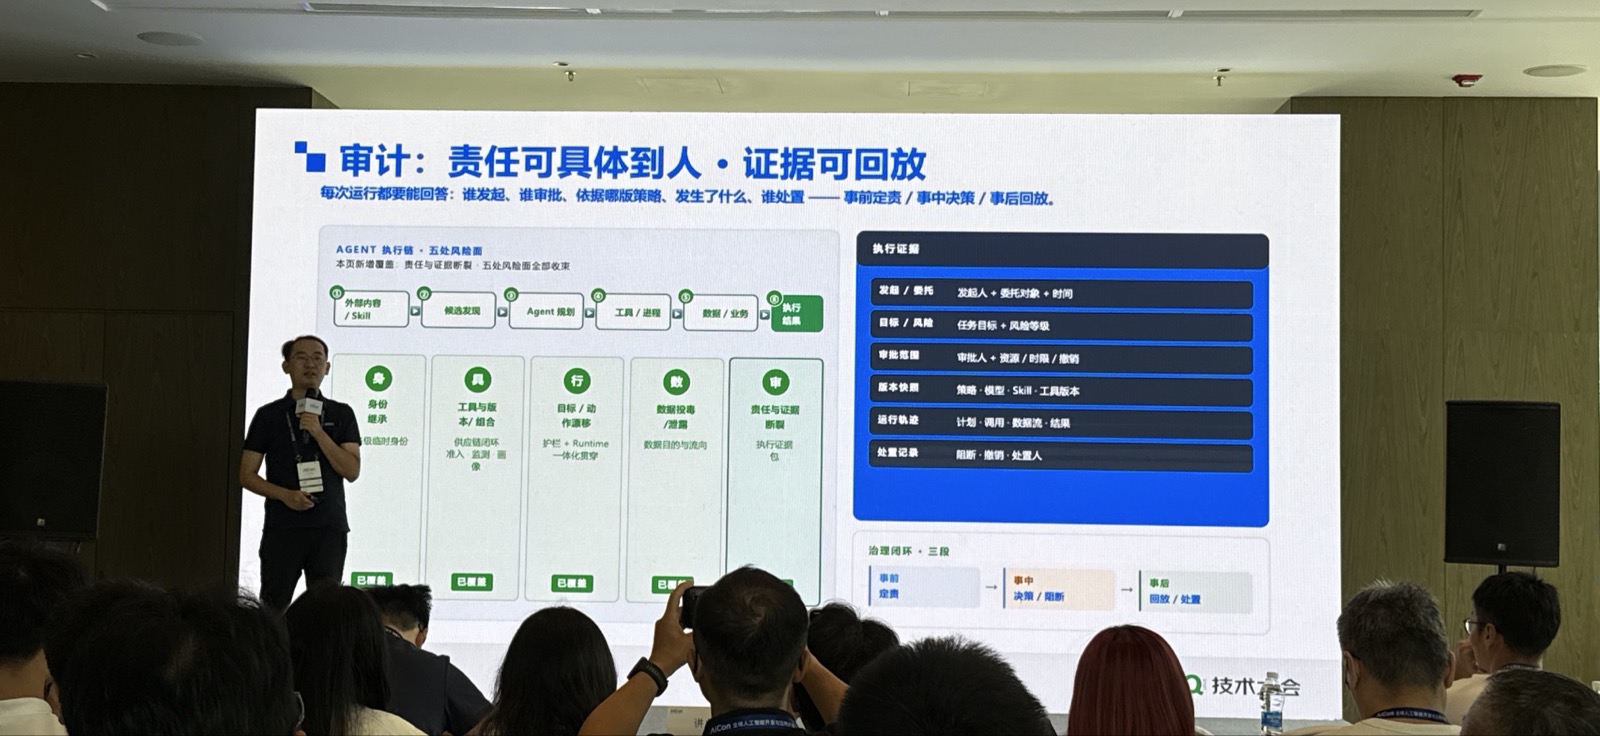
- 入站管控:判斷外部資料是否可被引入。
- 內容清洗:處理引入後可能影響模型的可疑內容。
- 出站治理:控管敏感資料傳輸與外部存取。
- 審計整合:打通Agent及其串接系統的日誌,建立每一步的可追溯性。
重點回顧:安全追上Agent應用的速度
Agent應用快速成長,安全能力仍在補齊。講者預期,未來將持續朝更細粒度的最小權限、工具全生命週期治理、AI對AI的資料內容對抗,以及可串聯、可運用的審計能力發展。目標不是以安全犧牲體驗,而是在可接受的效能成本下提升惡意Skill的發現與處置能力。
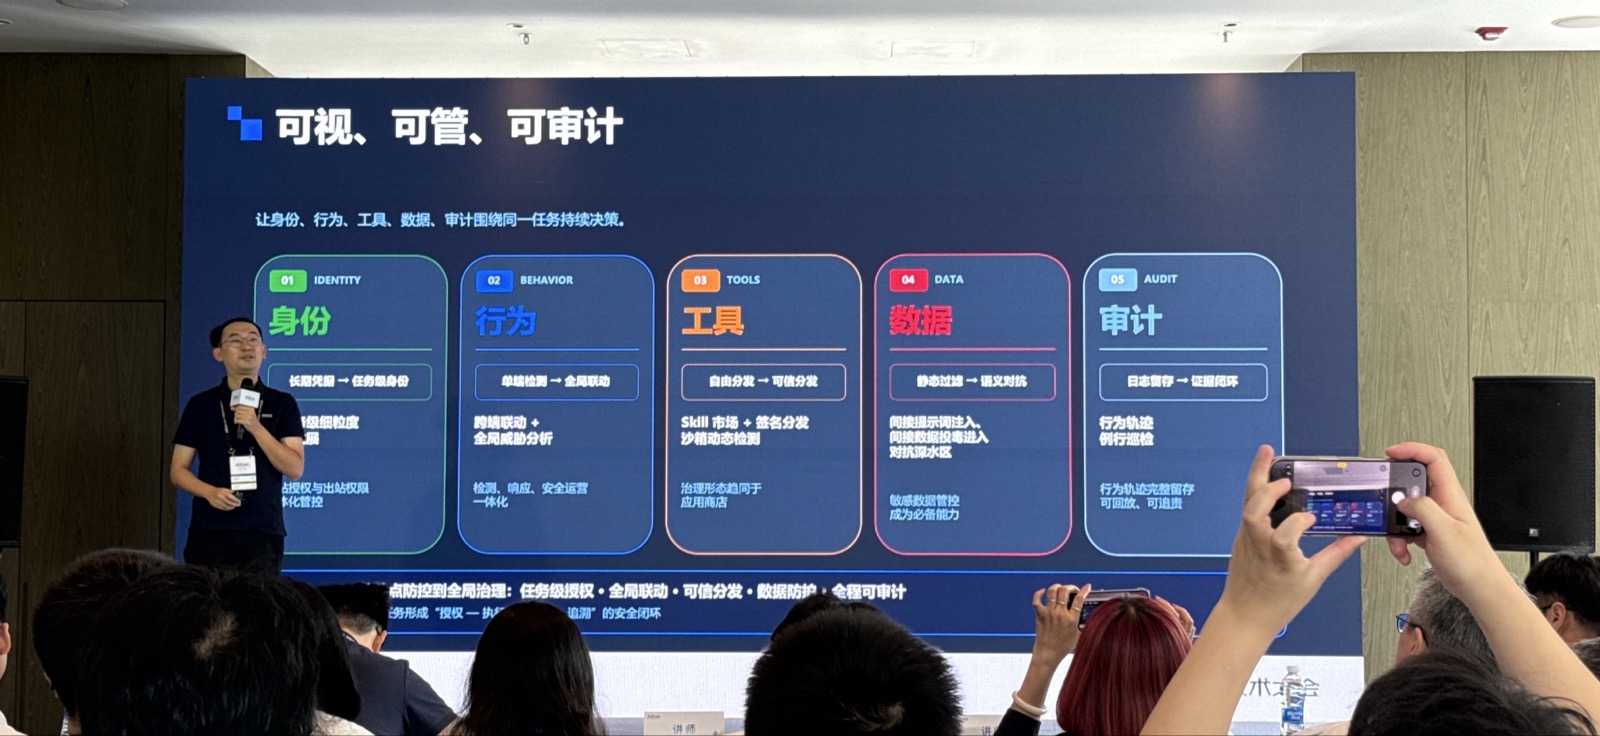
安全可視安全可管安全可審計跨層聯防入站資料治理AI對AI對抗