以可信閉環擴大 Agent 工程產能
TL;DR:Agent 工程的核心不在於單次生成,而在於把模型的機率性輸出放進可觀測、可回饋、可約束的 <keywords>Loop</keywords>。分享者以模組級 Linter、CI 自癒與審查回饋為起點,進一步提出事前—事中—事後的工作流,以及面向團隊協作的 Graph Loop;目標是將人力從重複檢查移往關鍵決策與事後評估。
Loop EngineeringAgent 工作流Custom LinterCI 自癒自動化 Review人機協同Graph Loop風險驅動驗證
Loop 工程演進:從單次提示到可交付的迭代
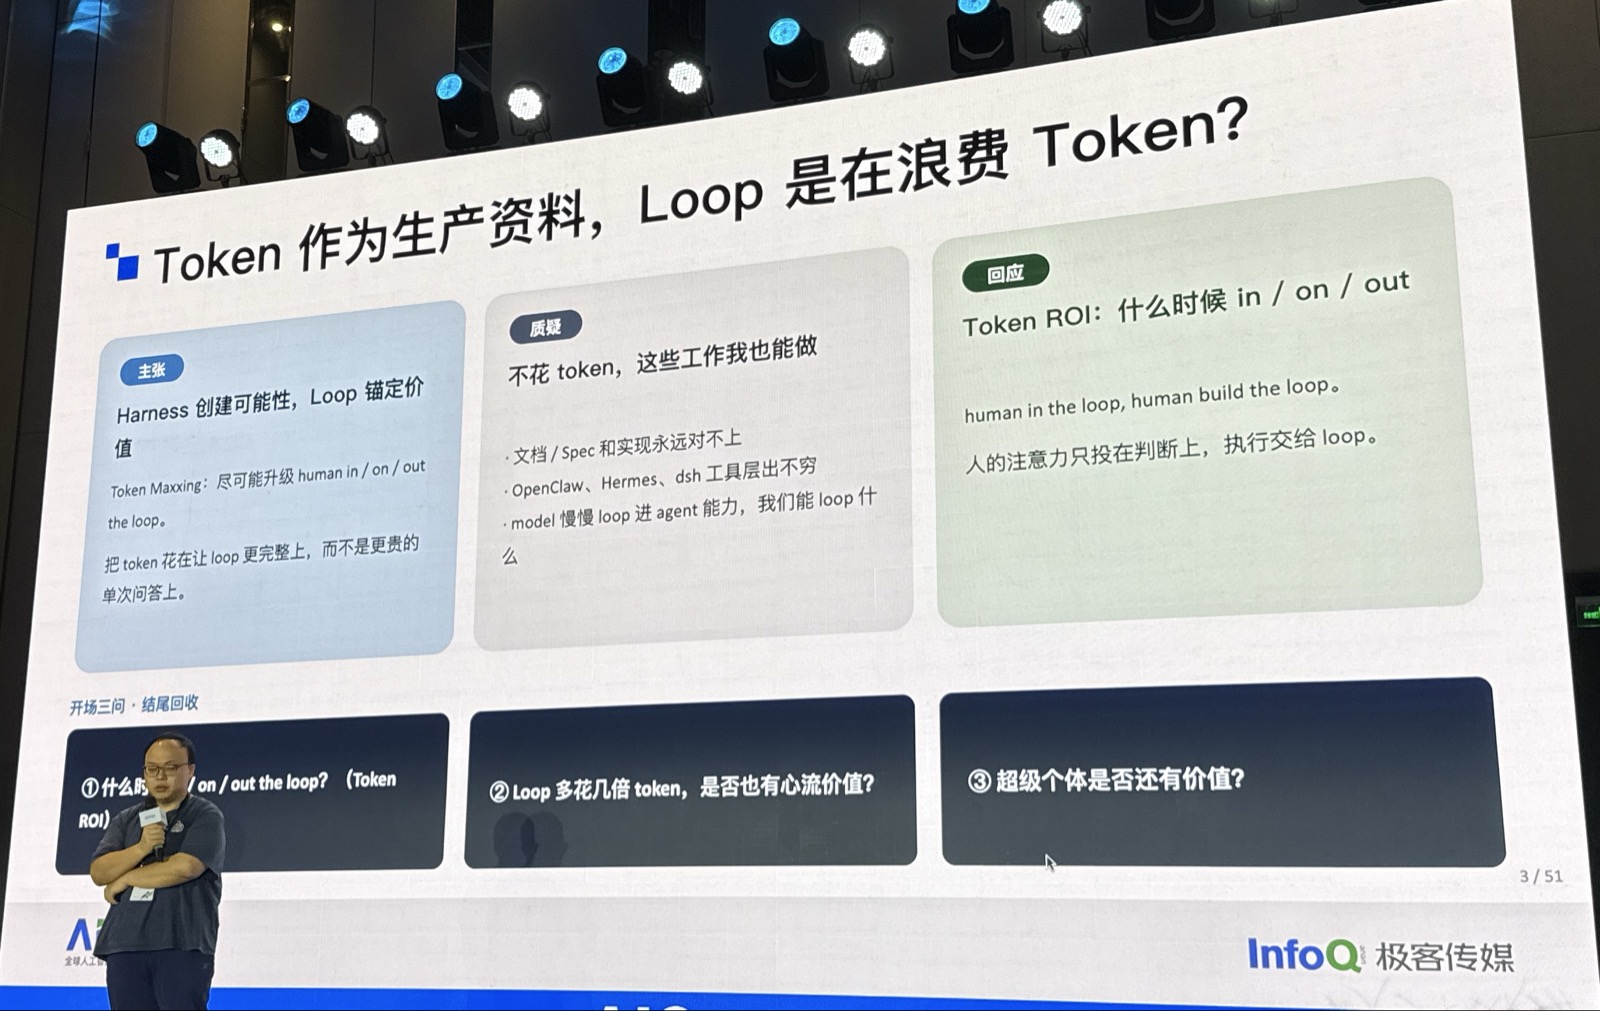
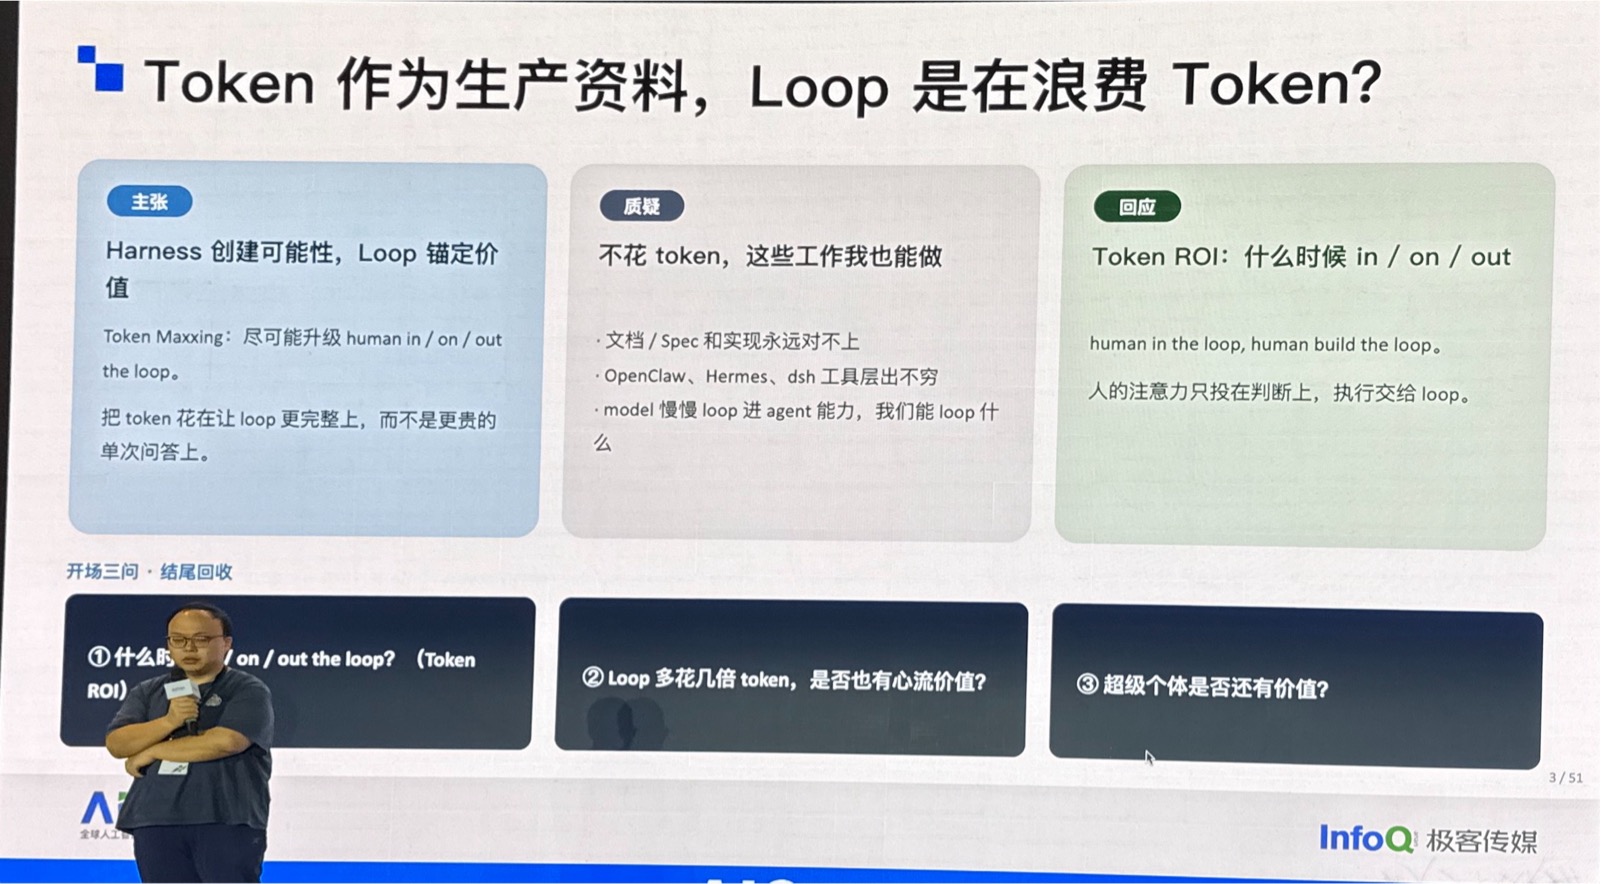
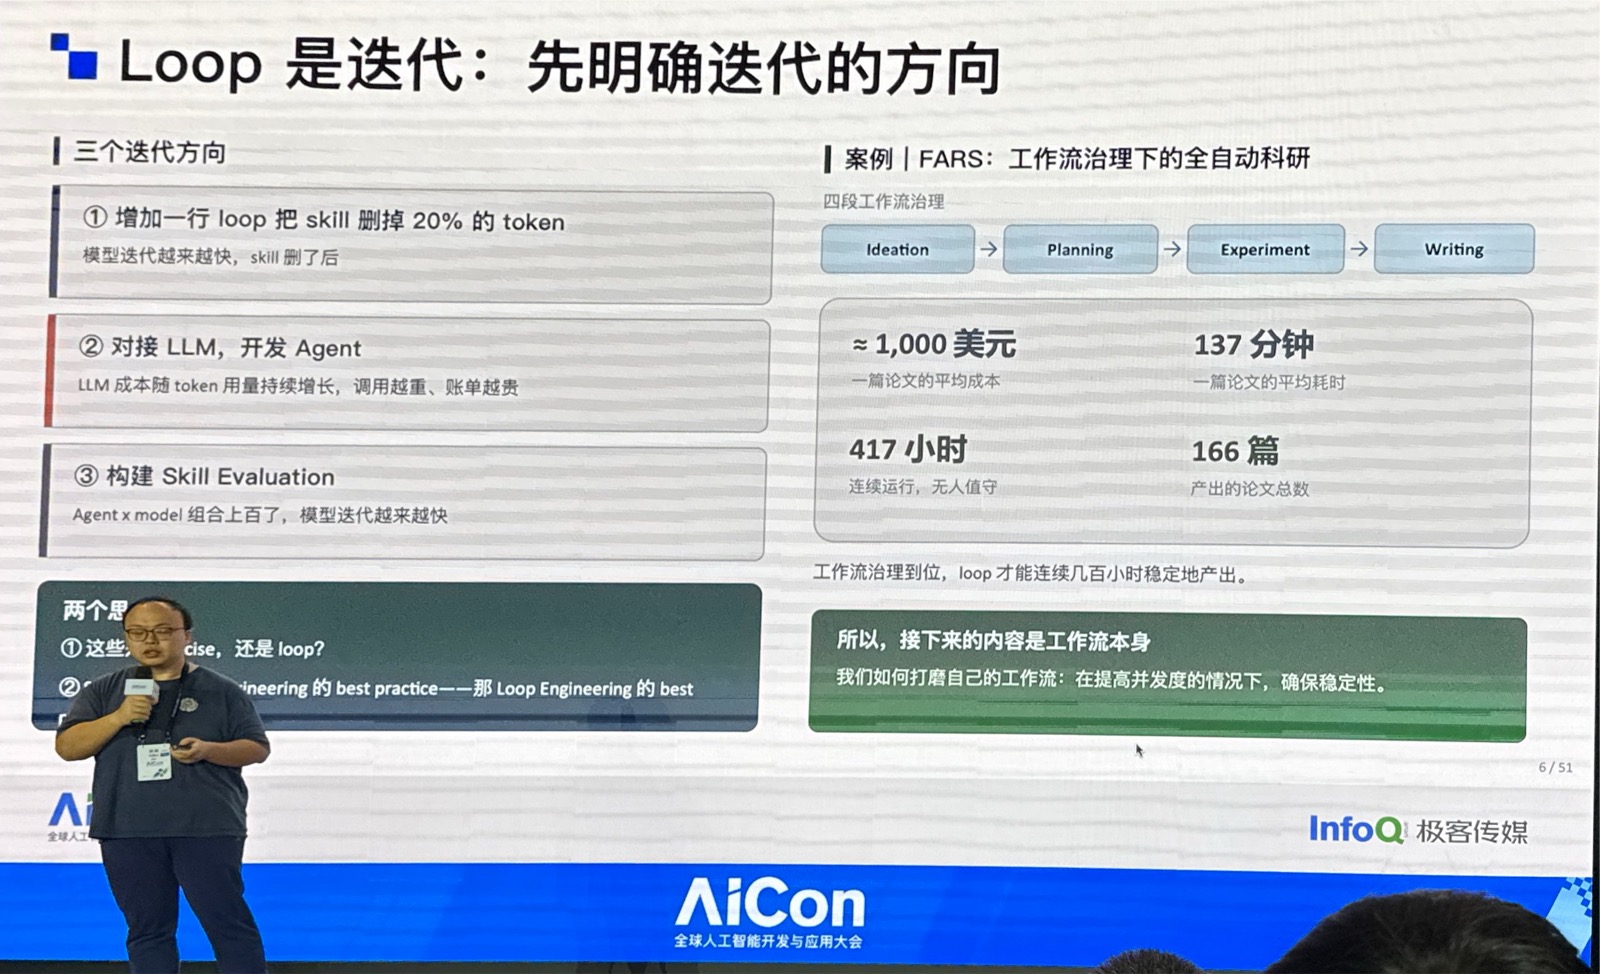
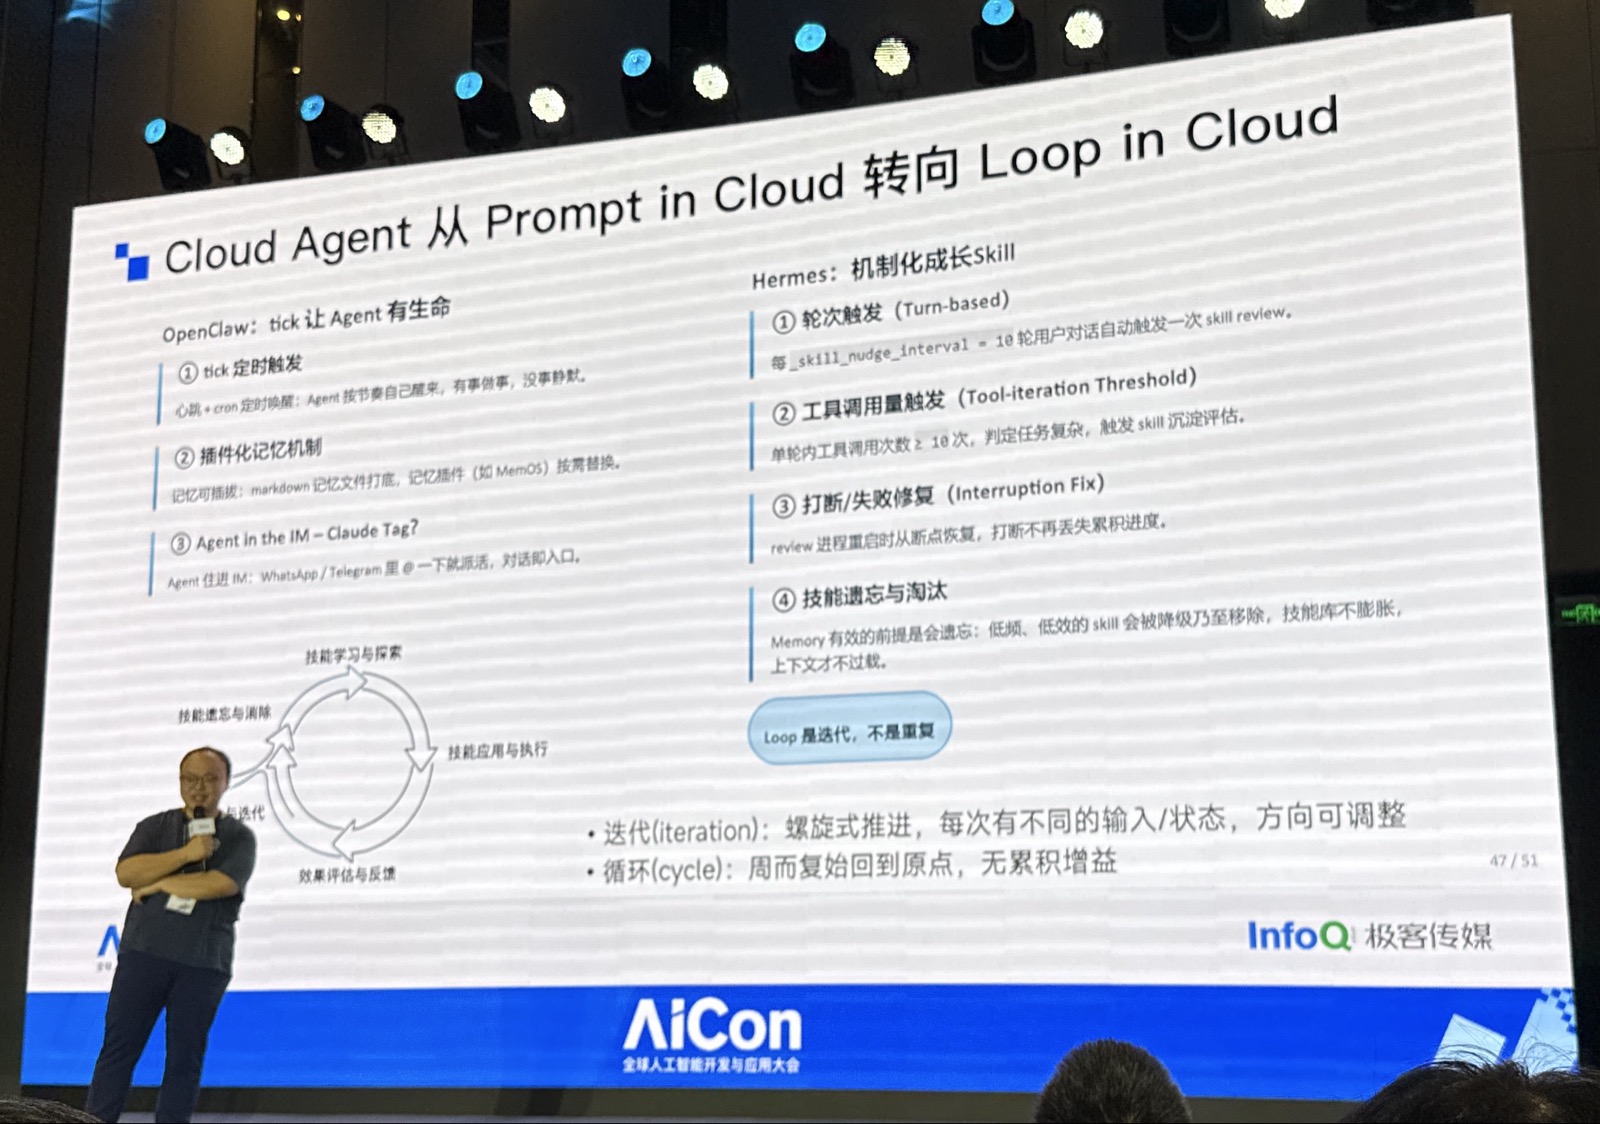
分享者將 Agent 的價值比擬為自動駕駛:目的不是取代人能完成的操作,而是降低個人的認知負擔,提升整體品質與能力。所謂 Loop,並非無意義的重複任務,而是把模型或 Agent 的不確定性,透過迭代轉化為可用的業務產出。
「我不用自動駕駛,也可以把車開在路上;那為什麼要自動駕駛?其實我是希望通過技術手段來減輕我個人的思維認知負擔。」
— 分享者
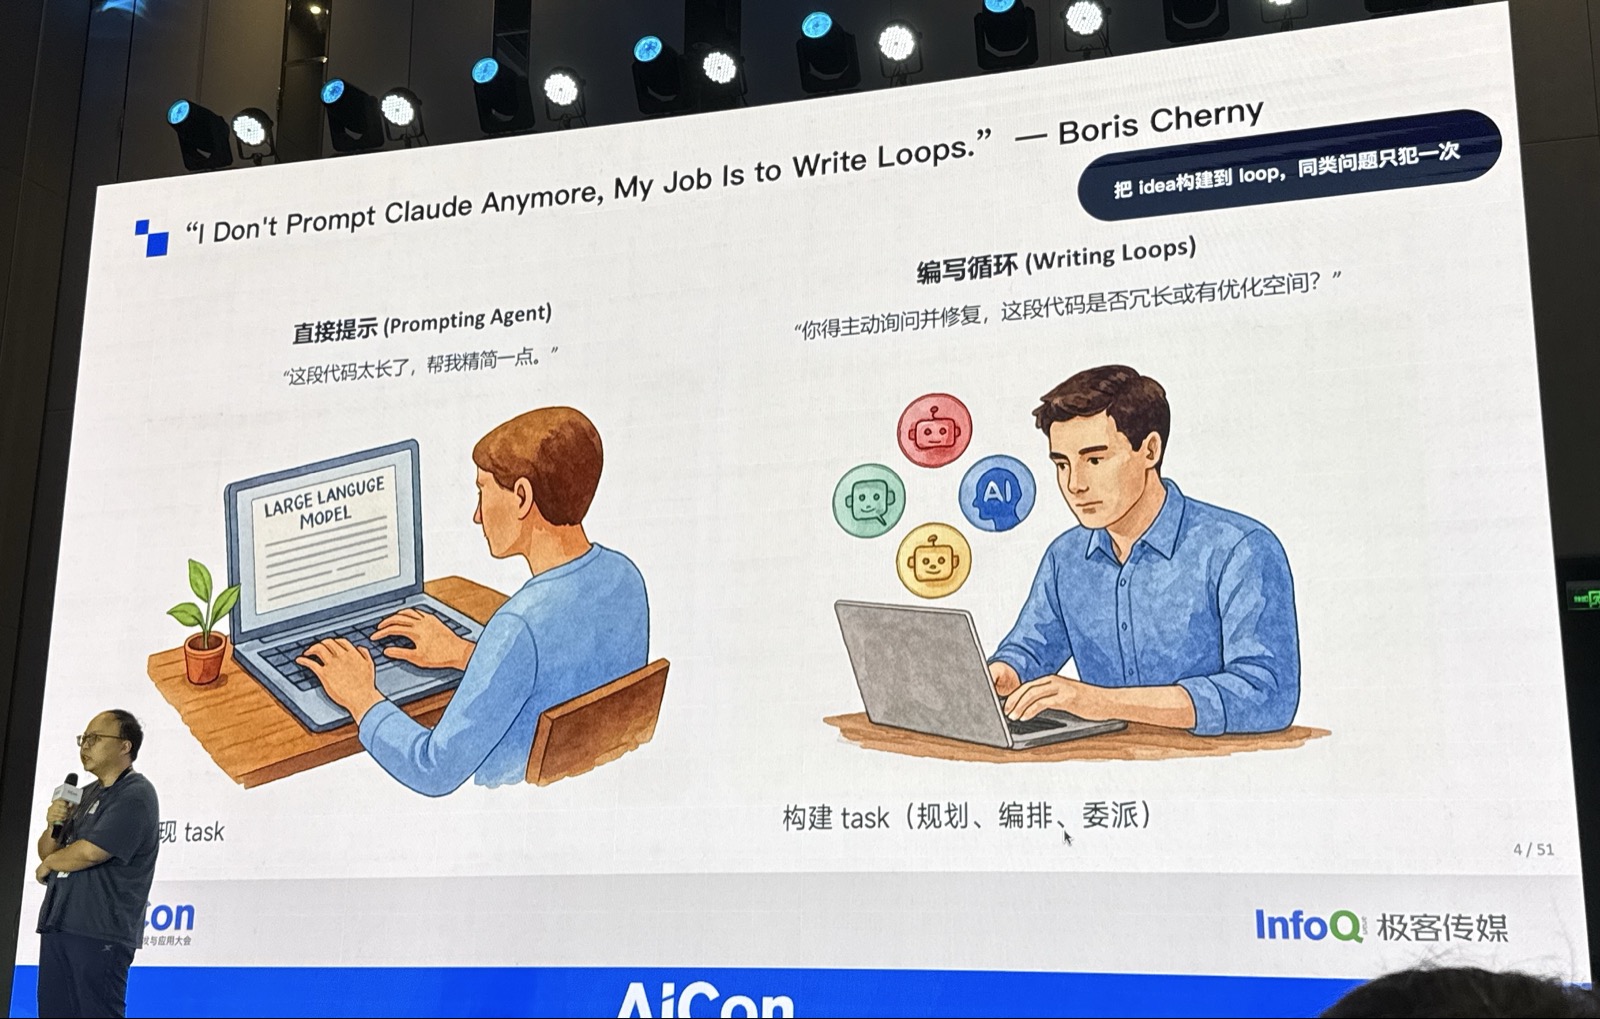
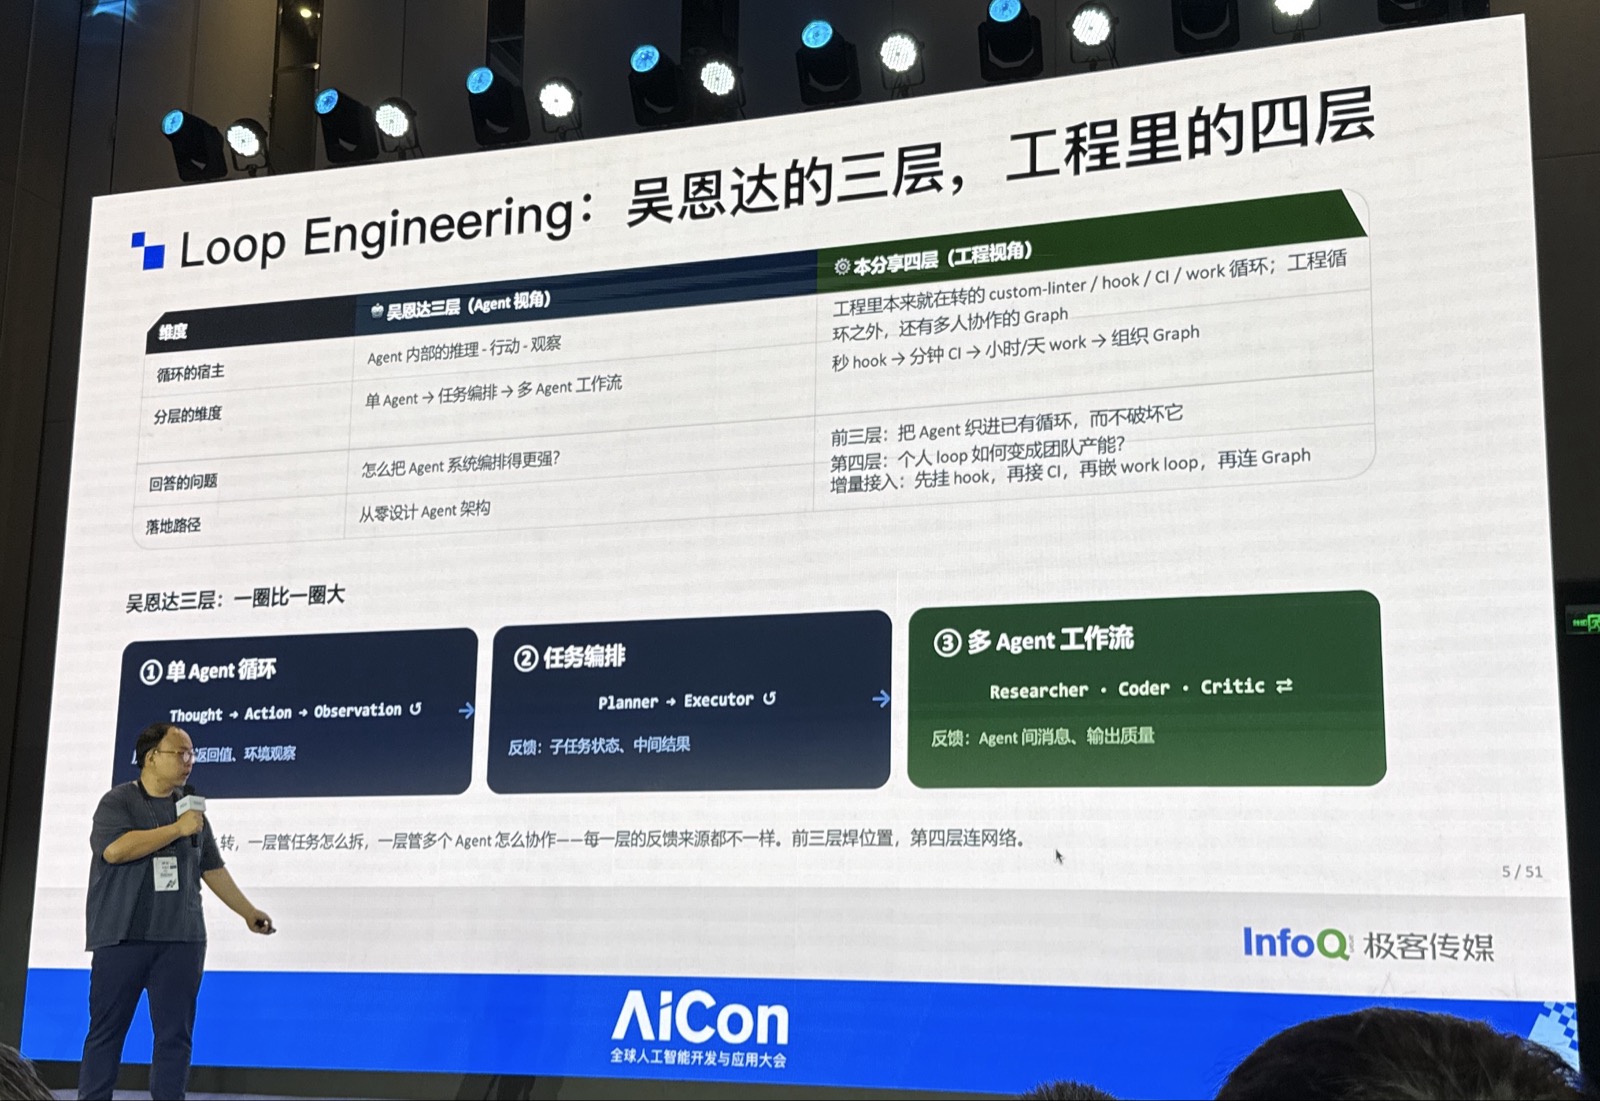
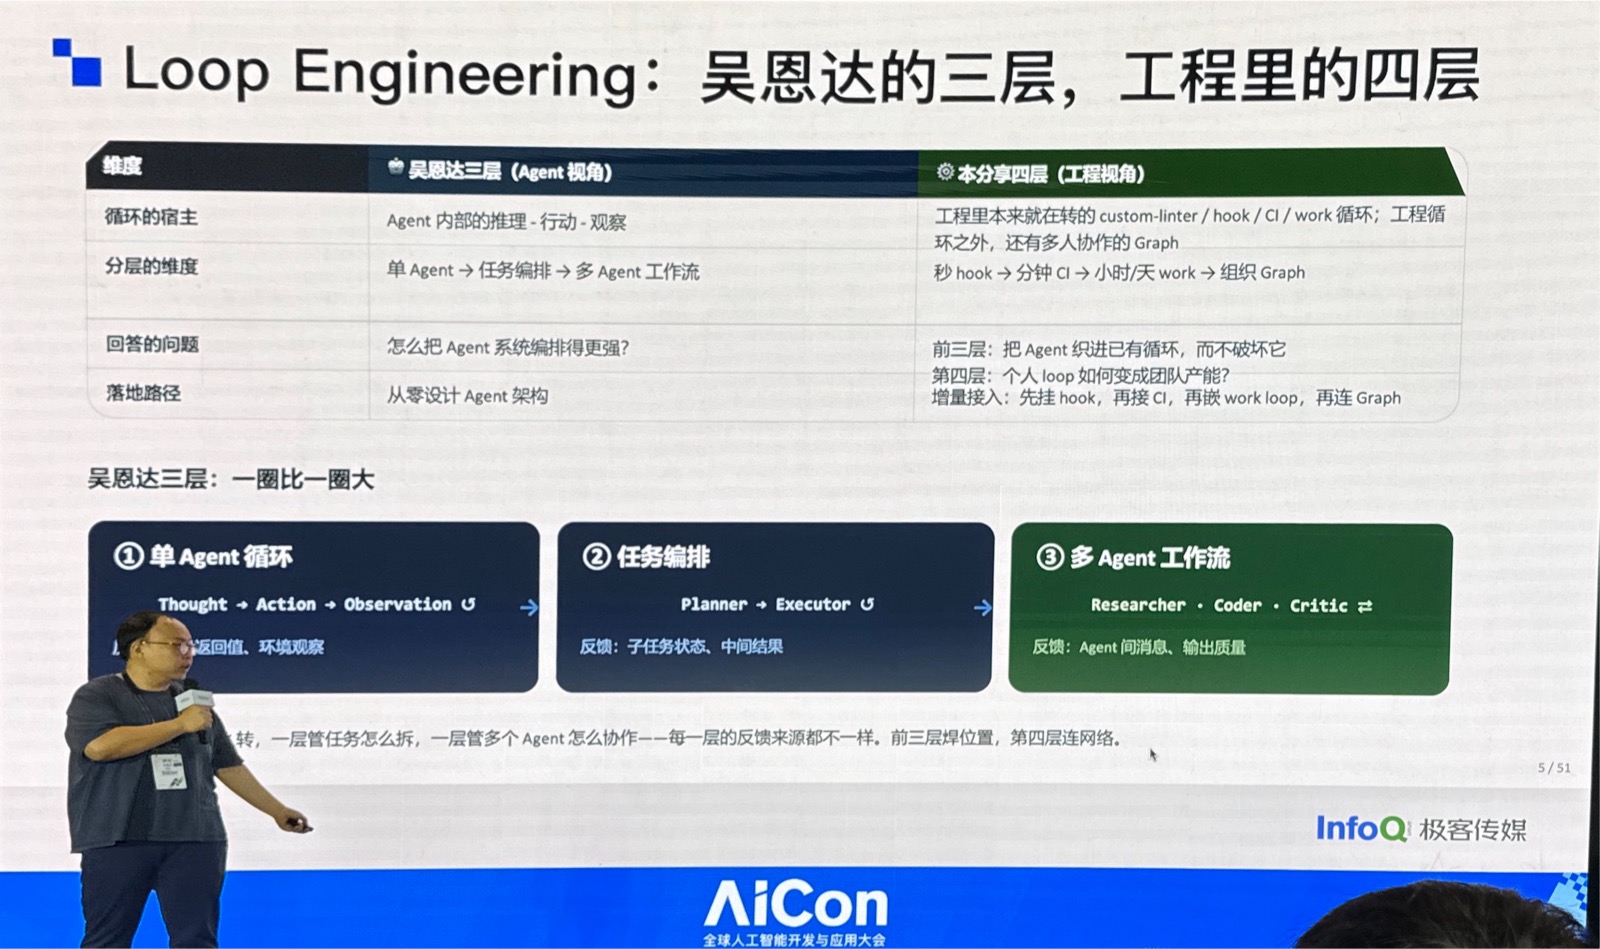
演進重點從「對 Agent 下指令」轉向「設計迴路」。前者可要求 Agent 精簡既有程式碼;後者則期待 Agent 主動發現程式碼過長、提出問題並修正。分享者也以工程實務區分三個層次:模組或風格層、CI 層,以及面向工作本身的結構化拆解。
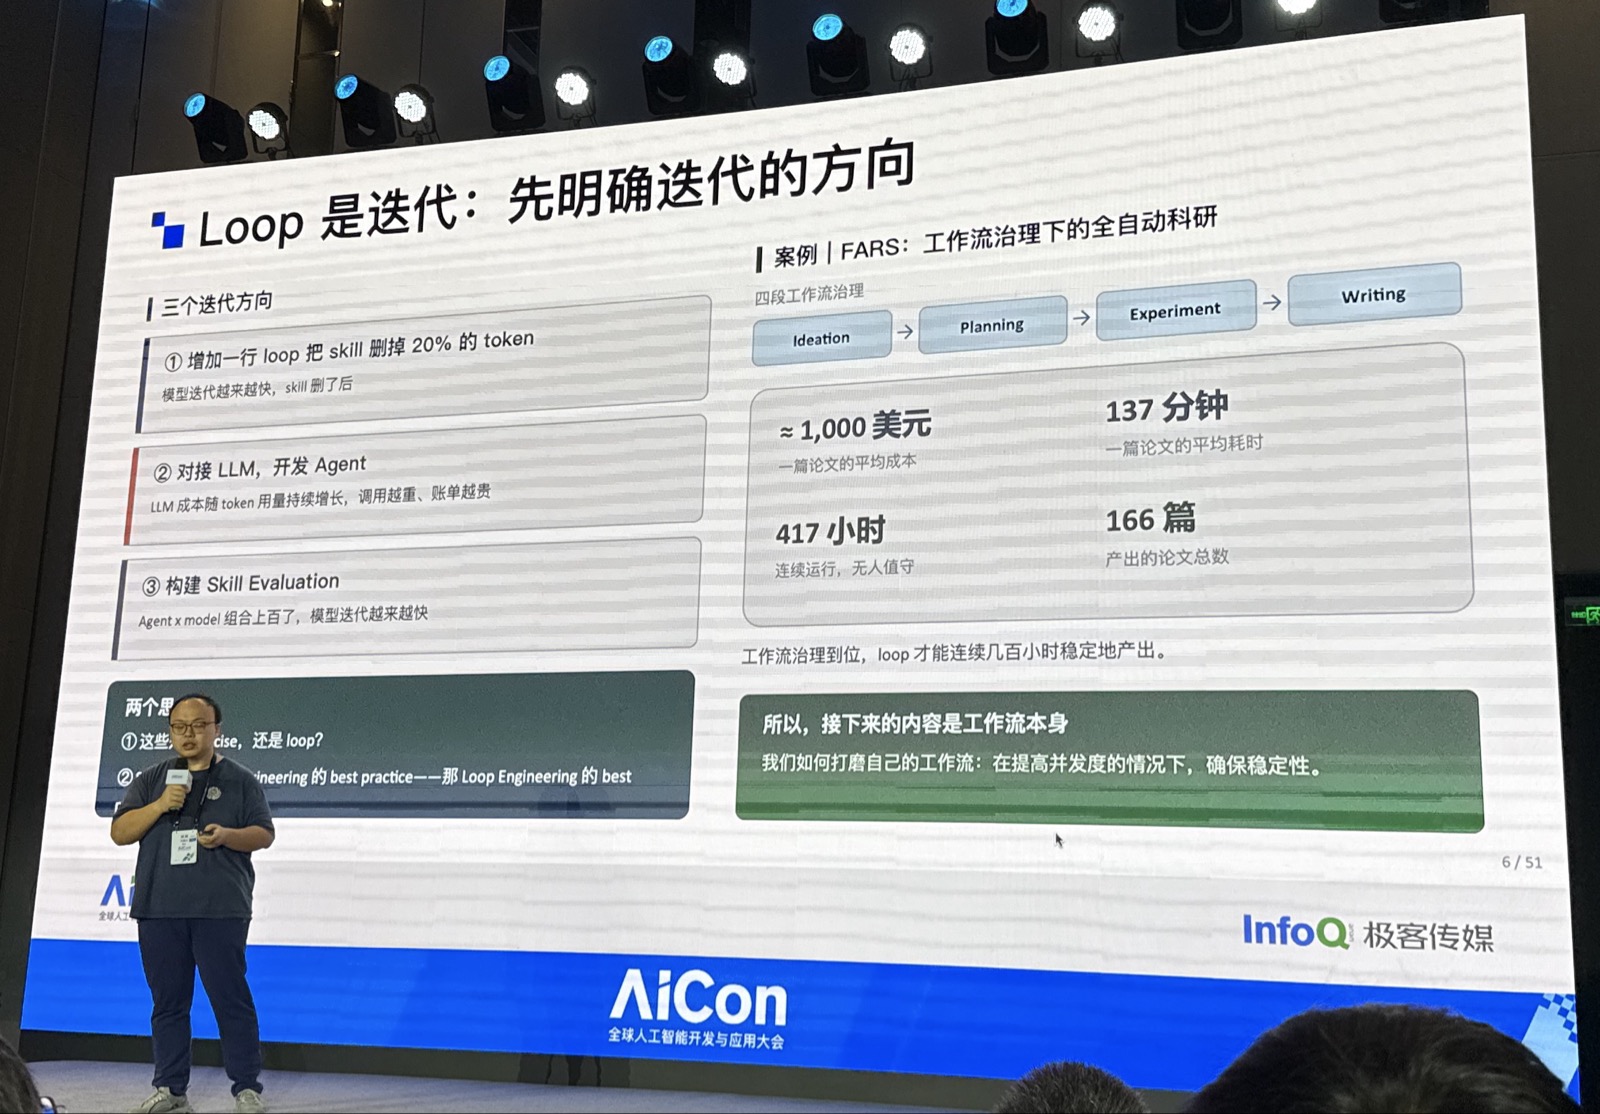
- 不以「更少 token 完成相同工作」作為唯一迭代目標;模型速度提升後,該指標未必直接對應業務價值。
- Agent 數量增加時,需重新檢視既有開發與審查容量是否足以支撐。
- 評估不能只停留在單一 SQL 或局部任務;實際研發中的 Agent 規模與長期效果更複雜。
自動化審查機制:從 Linter 到 CI 自癒
第一層 Loop 落在模組級治理。針對 AI 生成內容格式不一、日誌容易任意擴張的問題,團隊建立 <keywords>Custom Linter</keywords>,以 golangci-lint 外掛落實日誌規範。相較於依賴 LLM 判斷,規則型 Linter 的範圍可以逐步收斂,行為也更穩定。
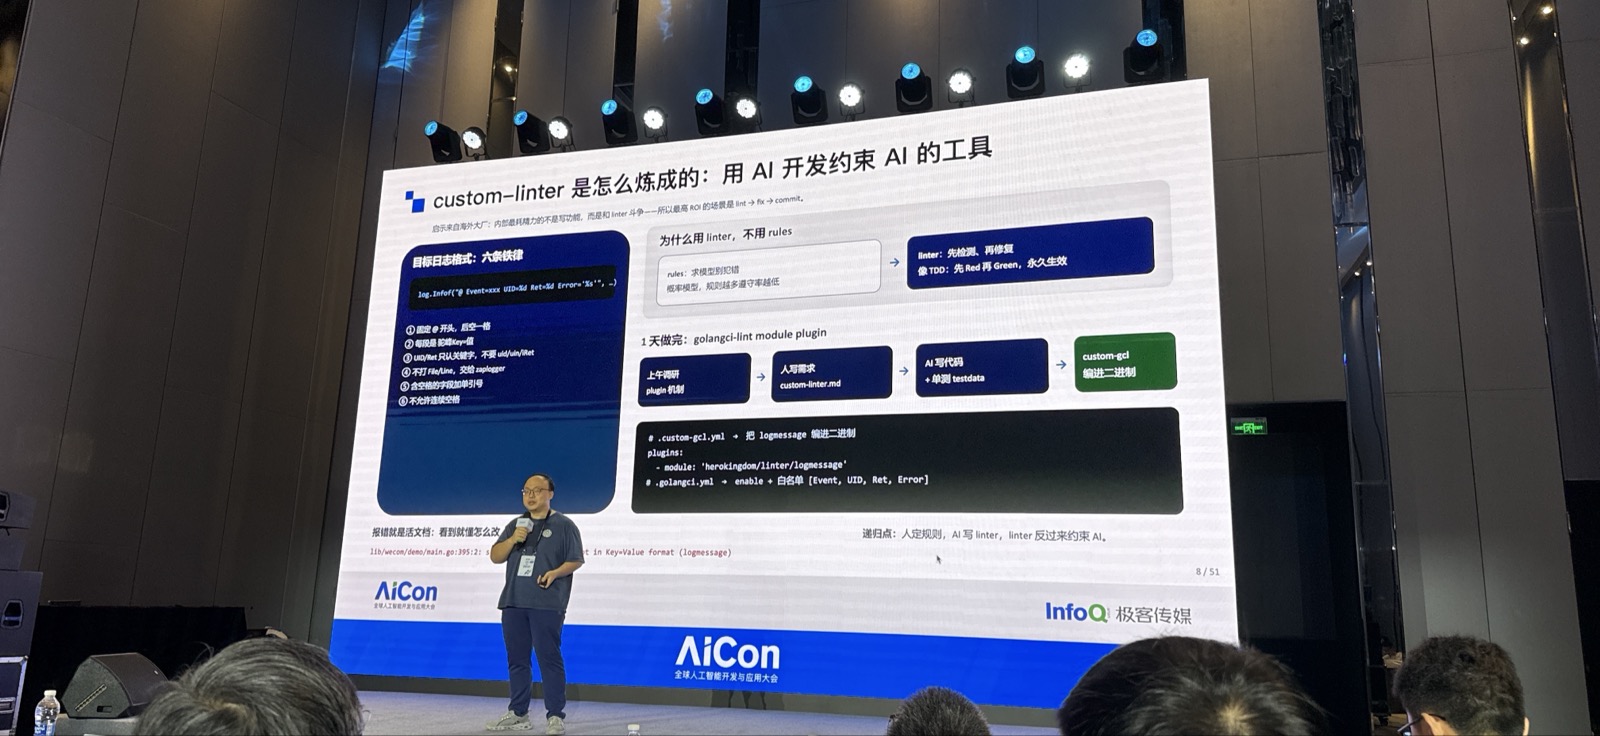
Linter 主要在兩個時點介入:Agent 完成檔案修改後,系統根據 diff 觸發檢查並把結果回傳 Agent 自行修復;以及 pre-commit 階段執行檢查。這形成「檢查—回饋—修復—再驗證」的局部自癒迴路。
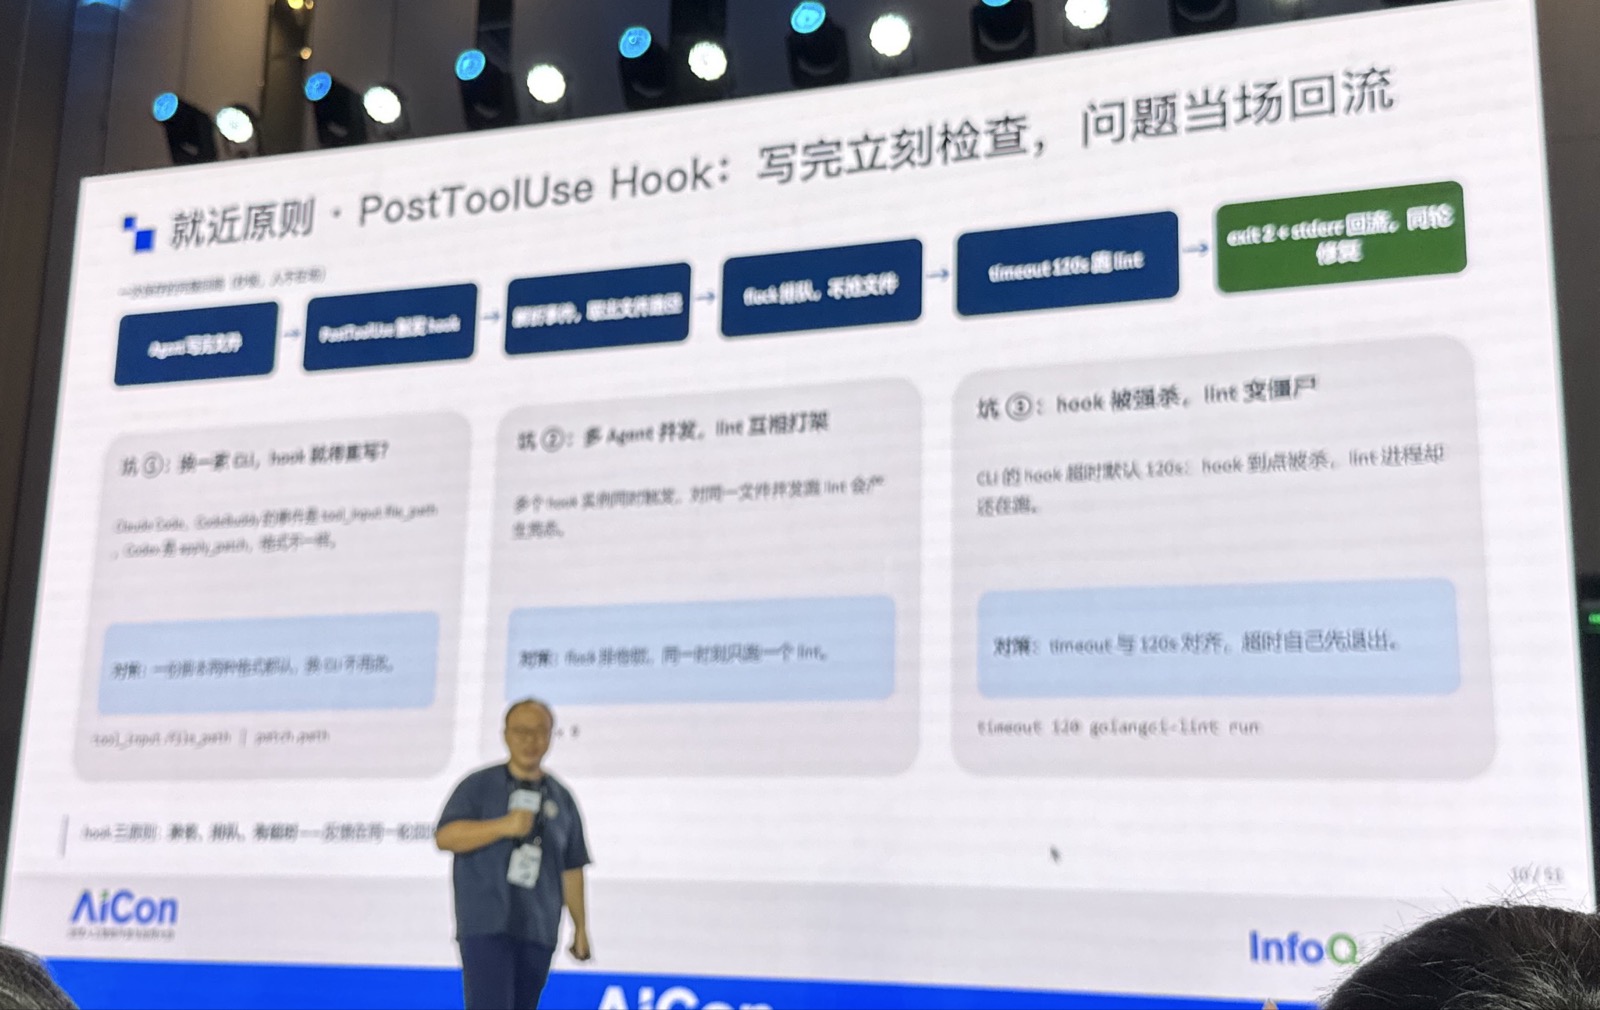
- 實務坑一:多種 Agent CLI 的相容性不一,需要額外適配。
- 實務坑二:Linter 未必穩定觸發,需處理執行與管理問題。
- 實務坑三:耗時檢查不宜全部阻塞在單一階段,可分散至後續提交或不同容器層。
- 風險:Agent 可能習慣性跳過檢查;目前只能透過 Agent Linter 與流程約束降低此類行為。
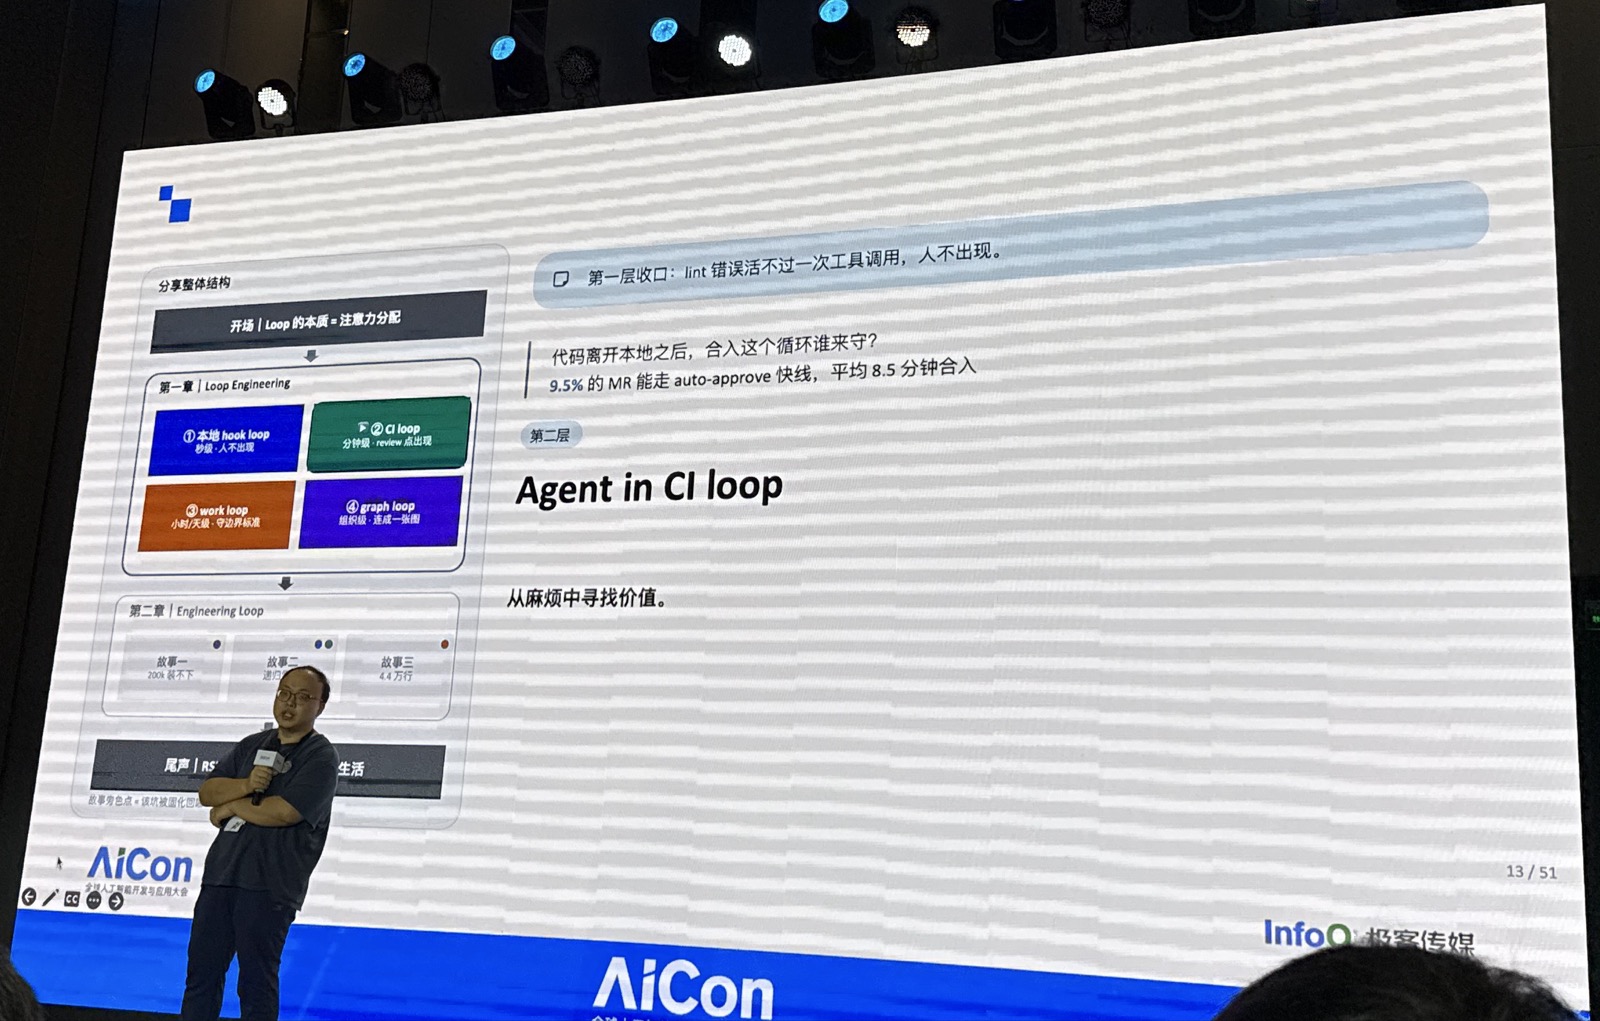
CI 流程在特性分支推送後,由 hook 觸發執行。Linter 紅燈時系統嘗試修復;另一條路徑則進行自動化 review。設計目的不是取消人,而是將人的注意力從重複、粗糙的檢查工作移開。
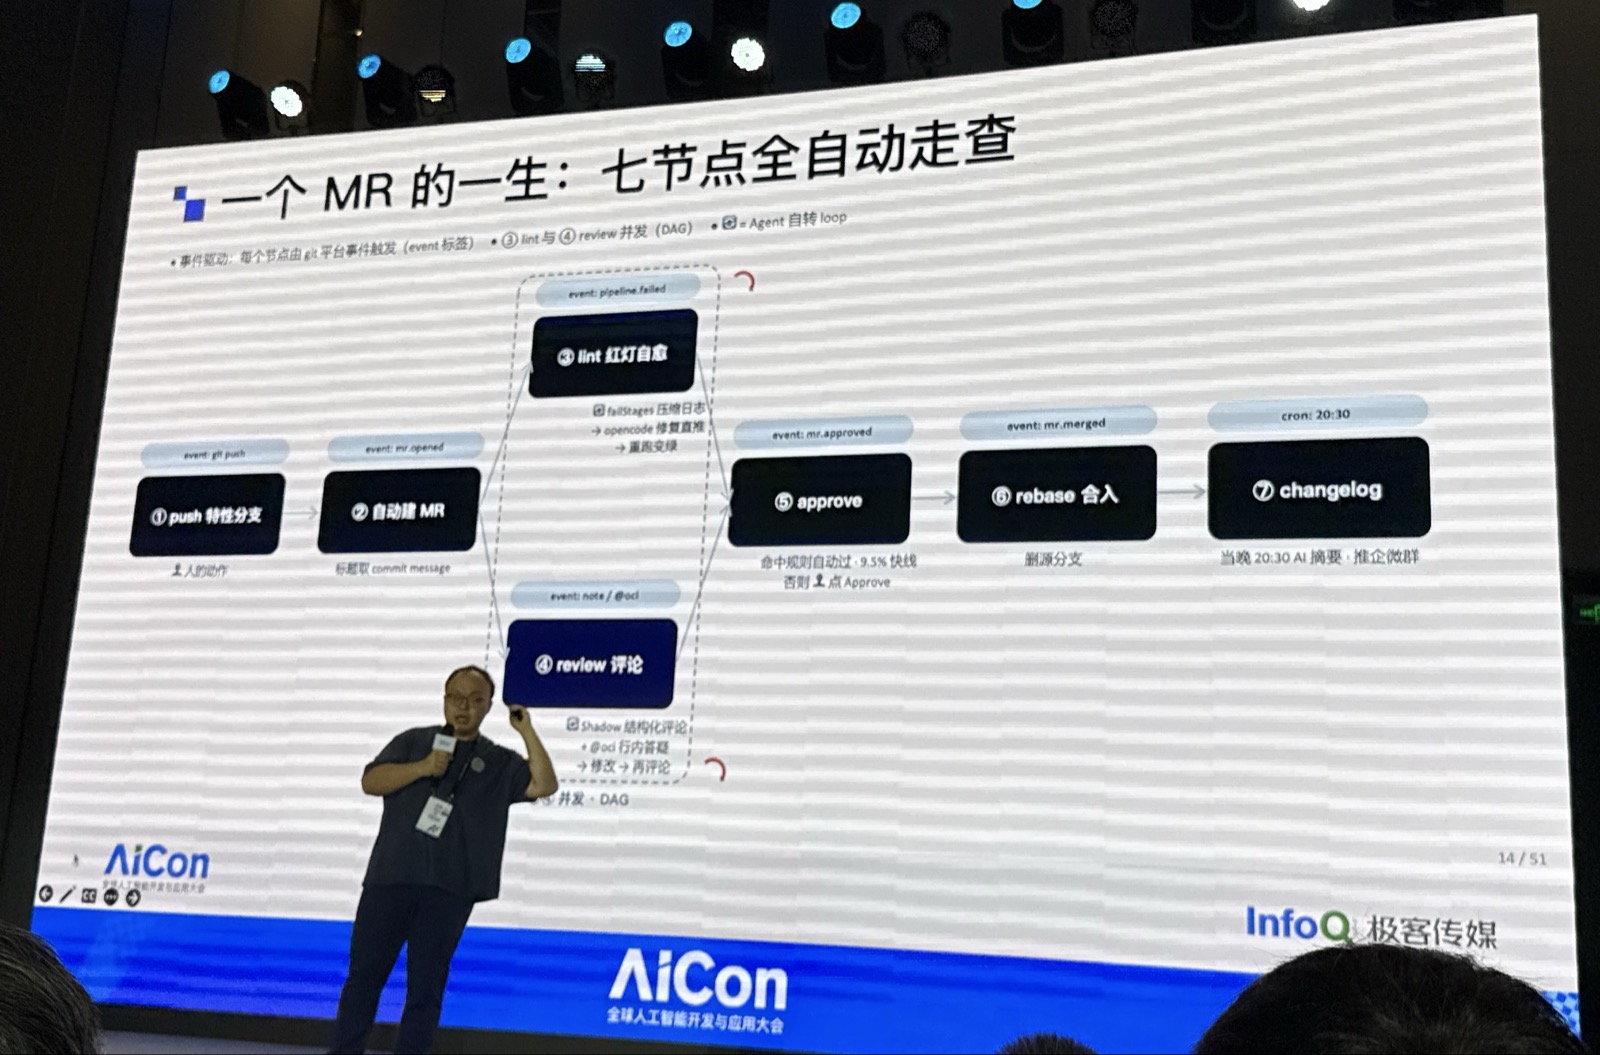
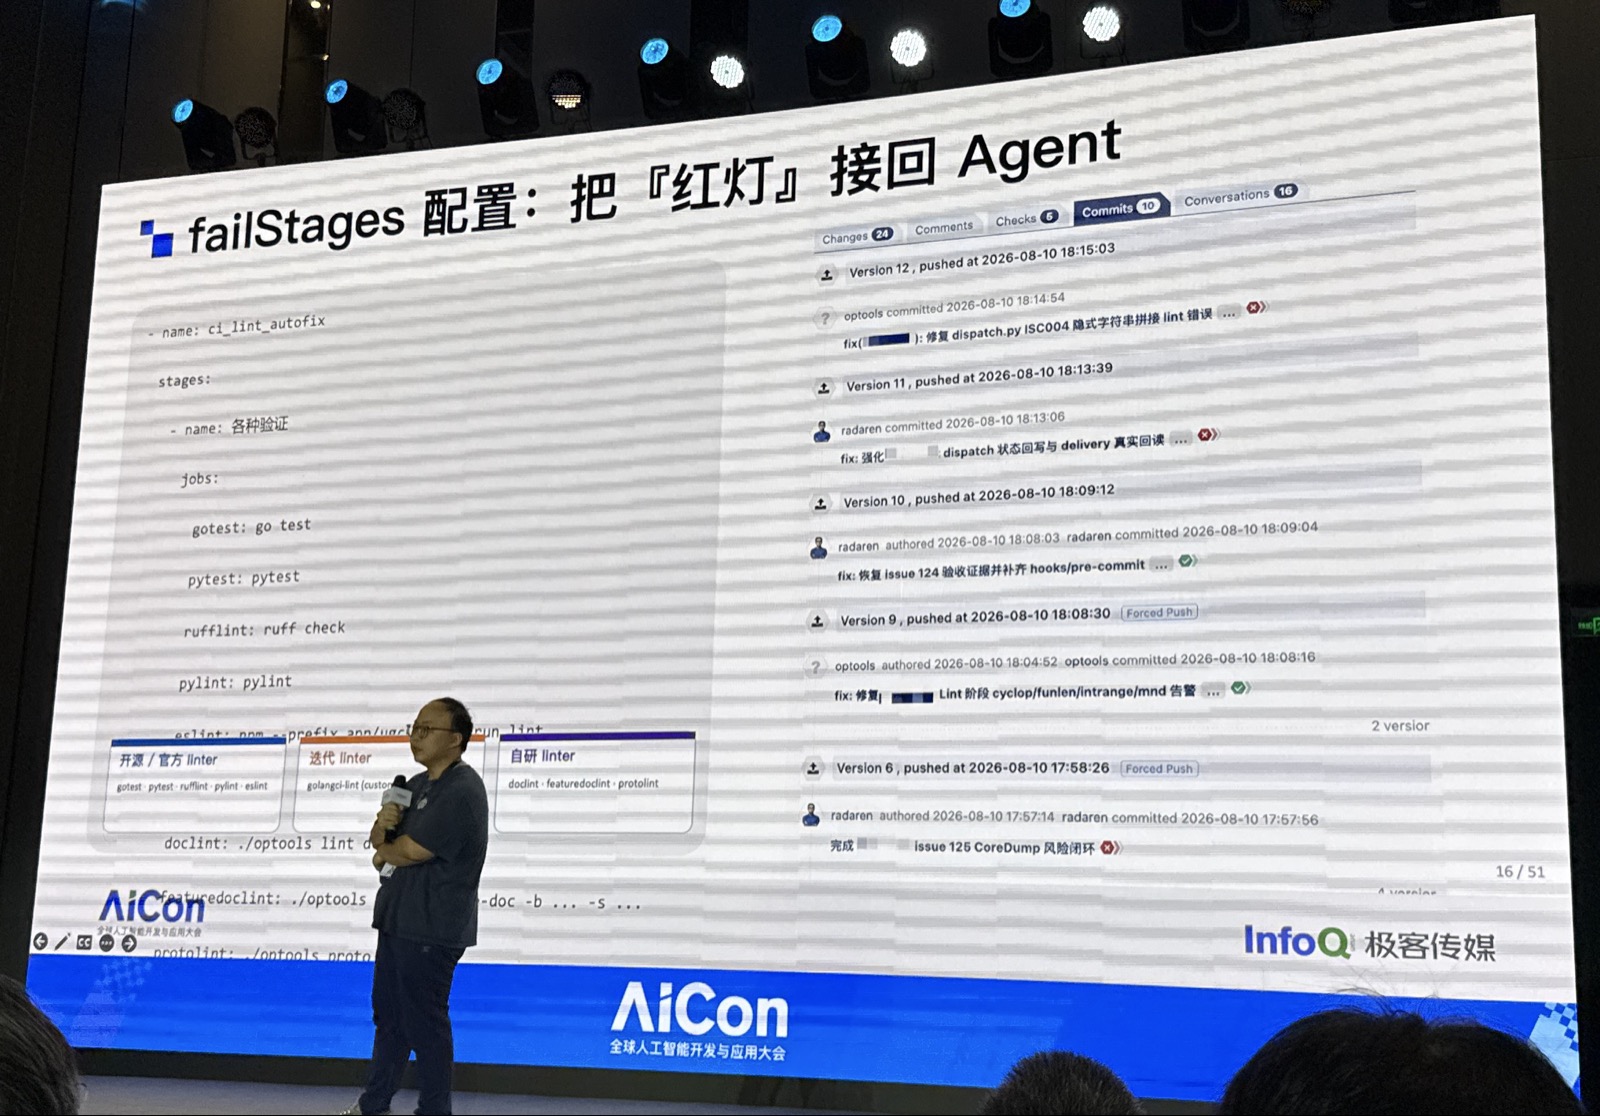
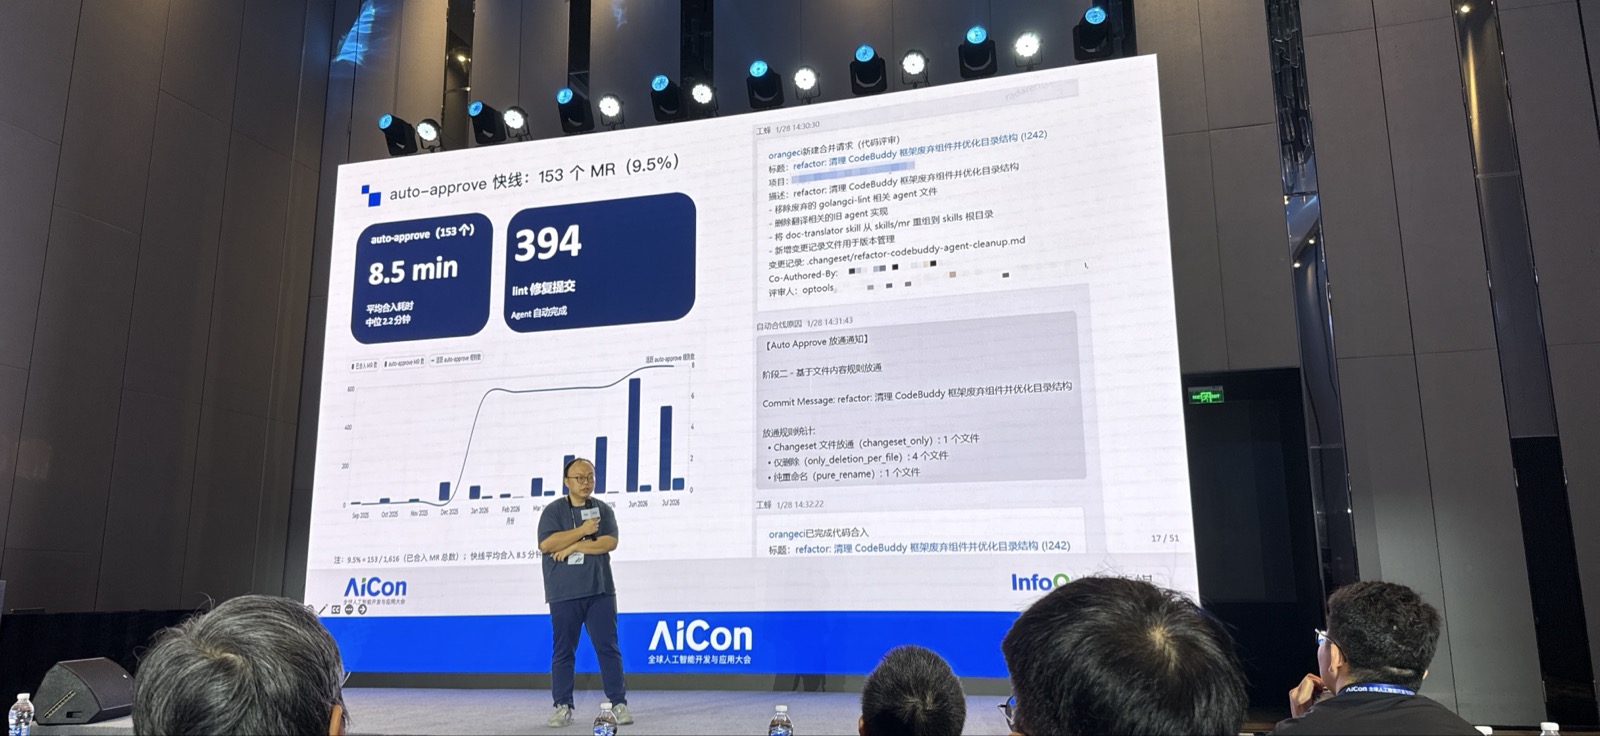
「我們想把那些重複粗糙的事情交給機器。」
— 分享者
Review 閉環:把評論轉成可學習的記憶
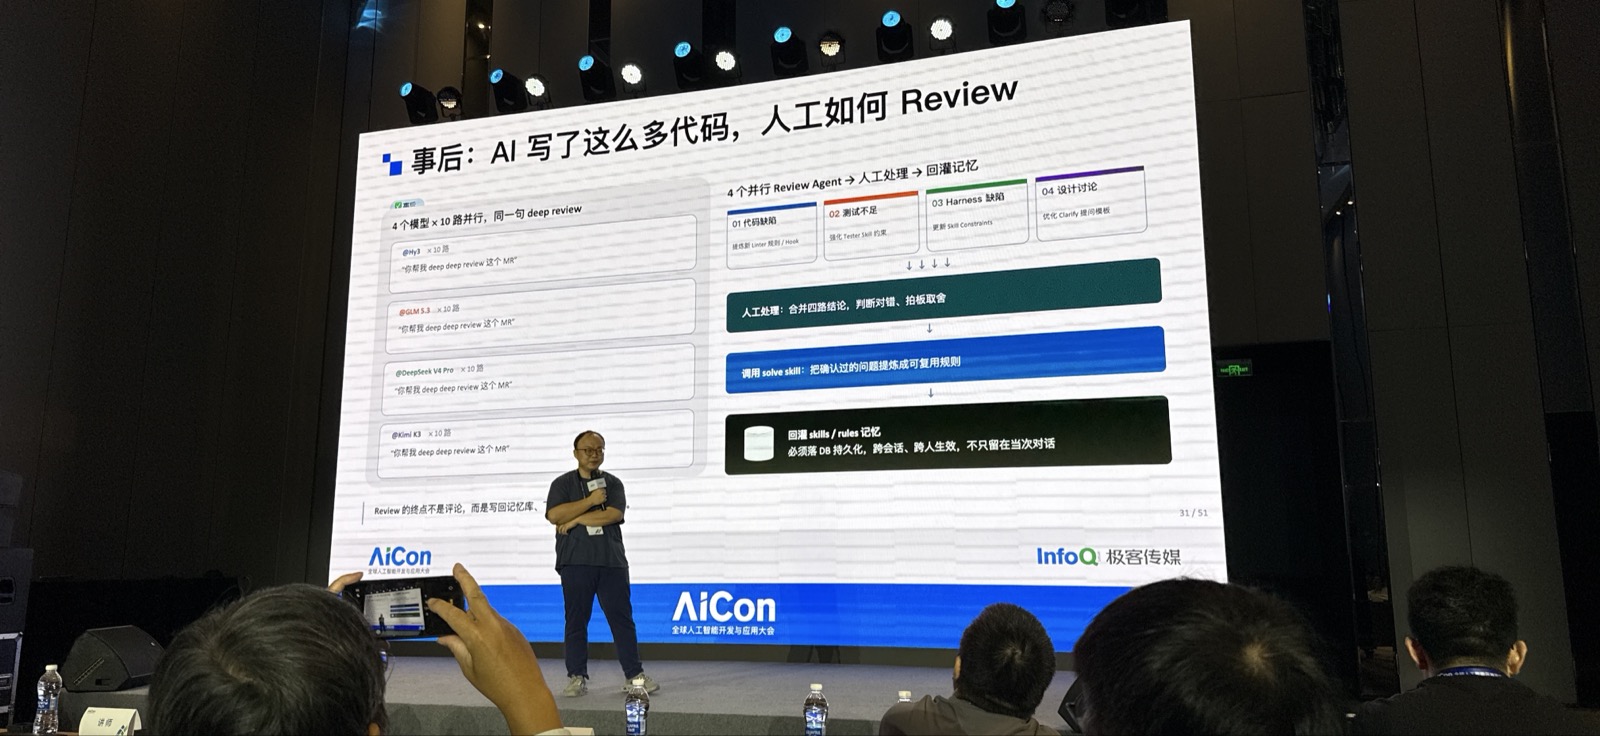
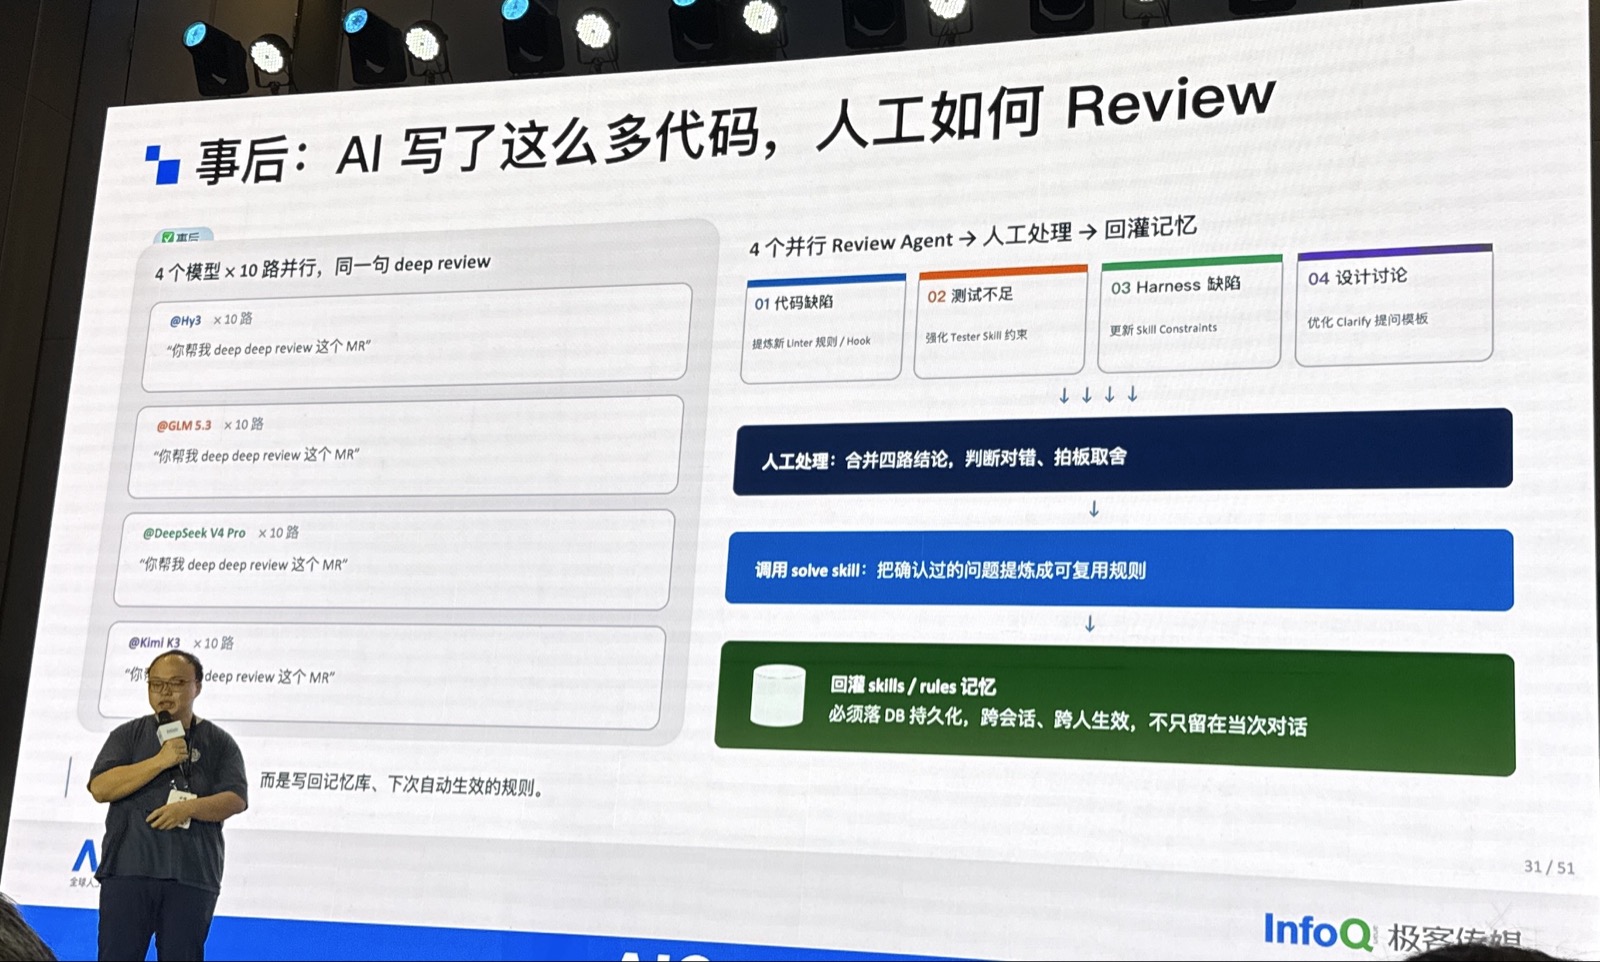
當 Agent 產生大量變更時,人的注意力成為稀缺資源。分享者提出以規則先篩選,再由 Agent 在 MR/PR 發問與接收回覆;若提問或回答不準確,則透過反向回饋修正。評論因此不只是一次性訊息,而是可持續優化審查流程的資料。
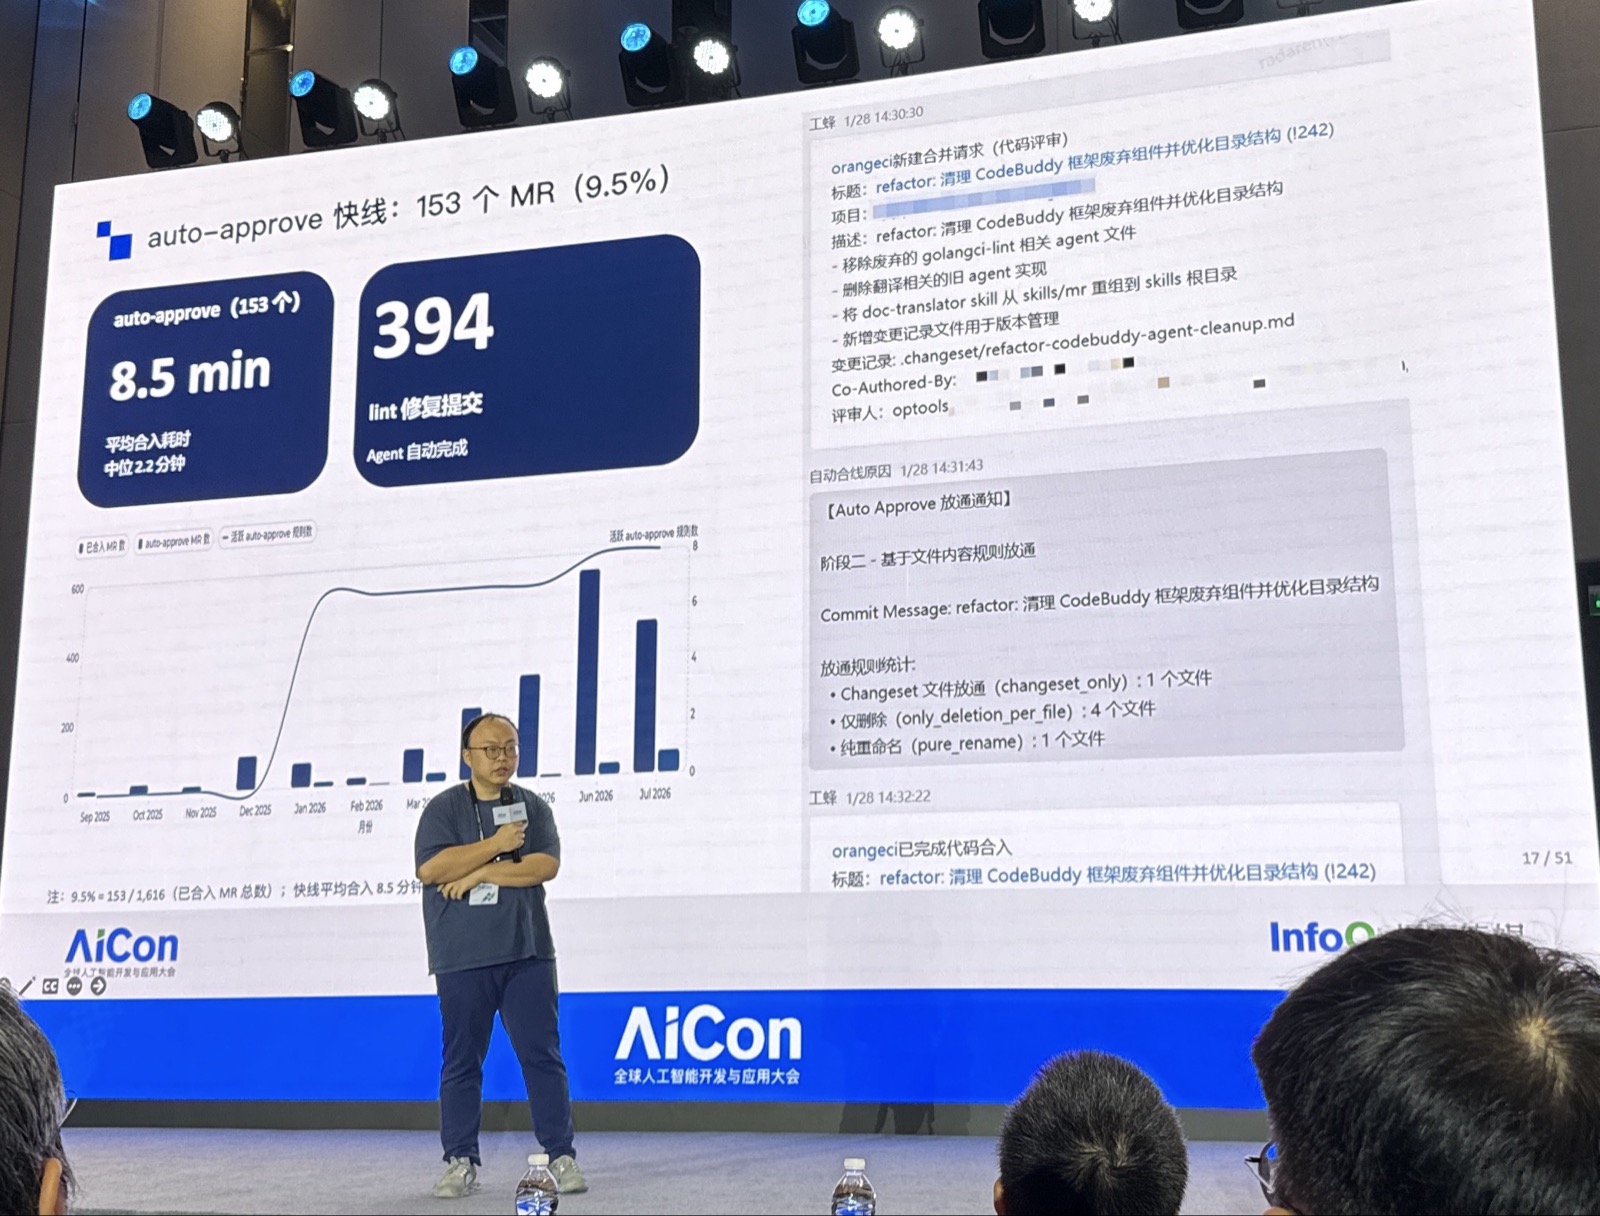
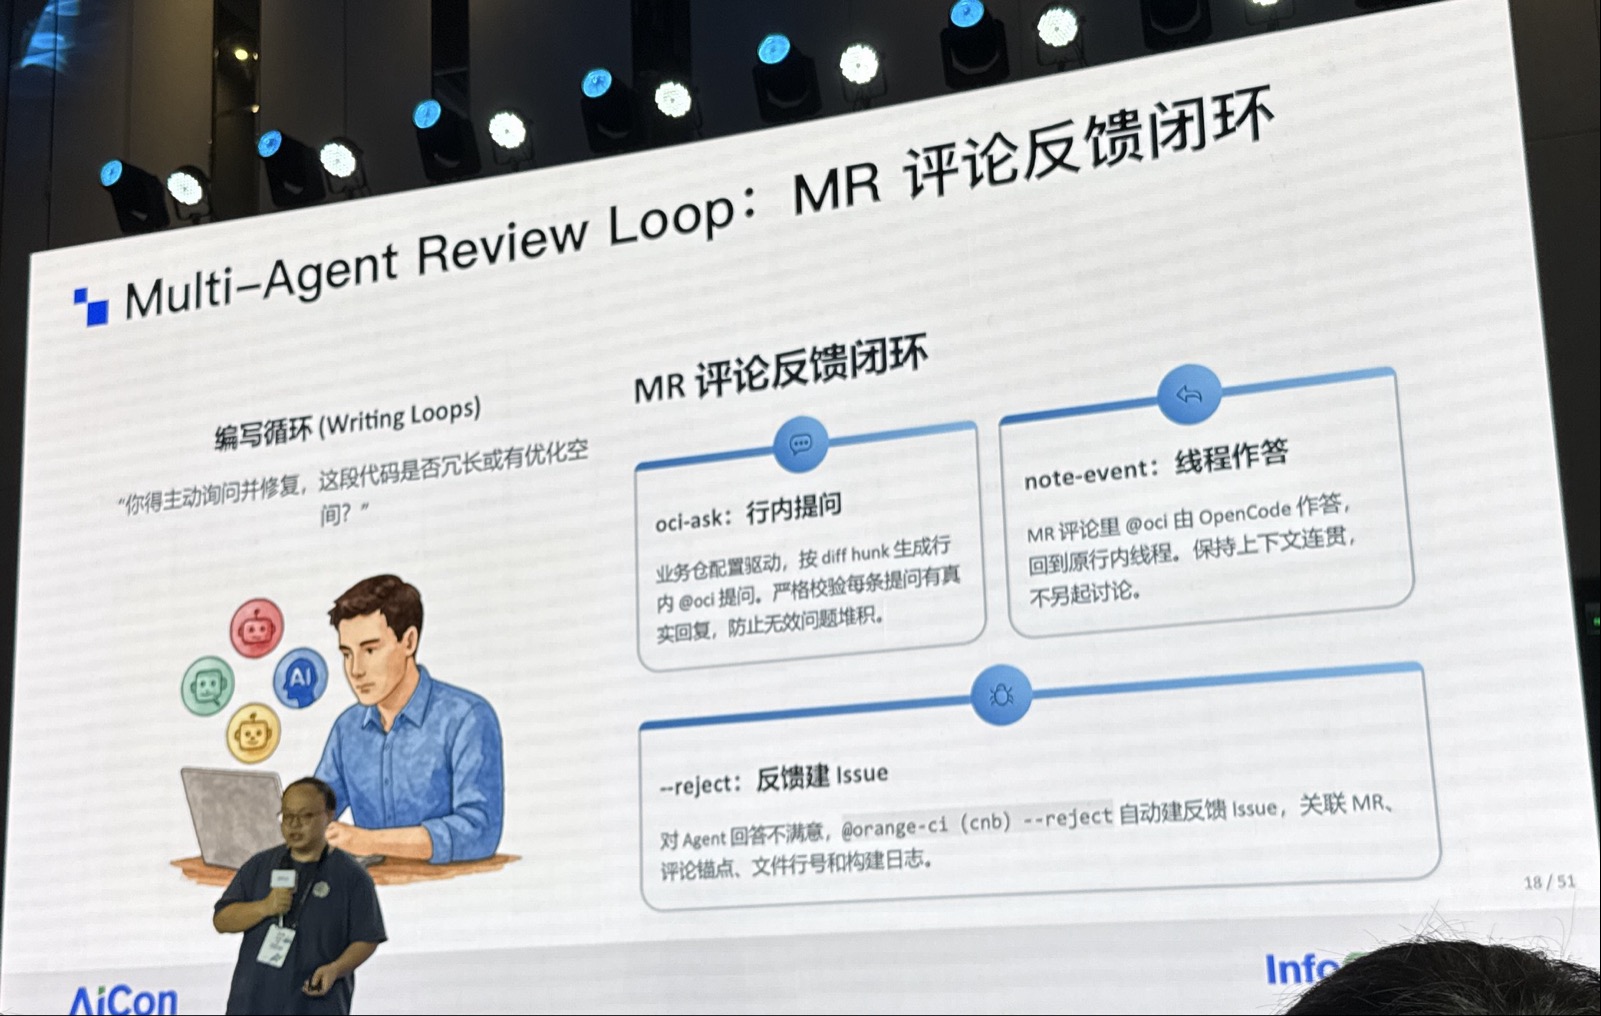
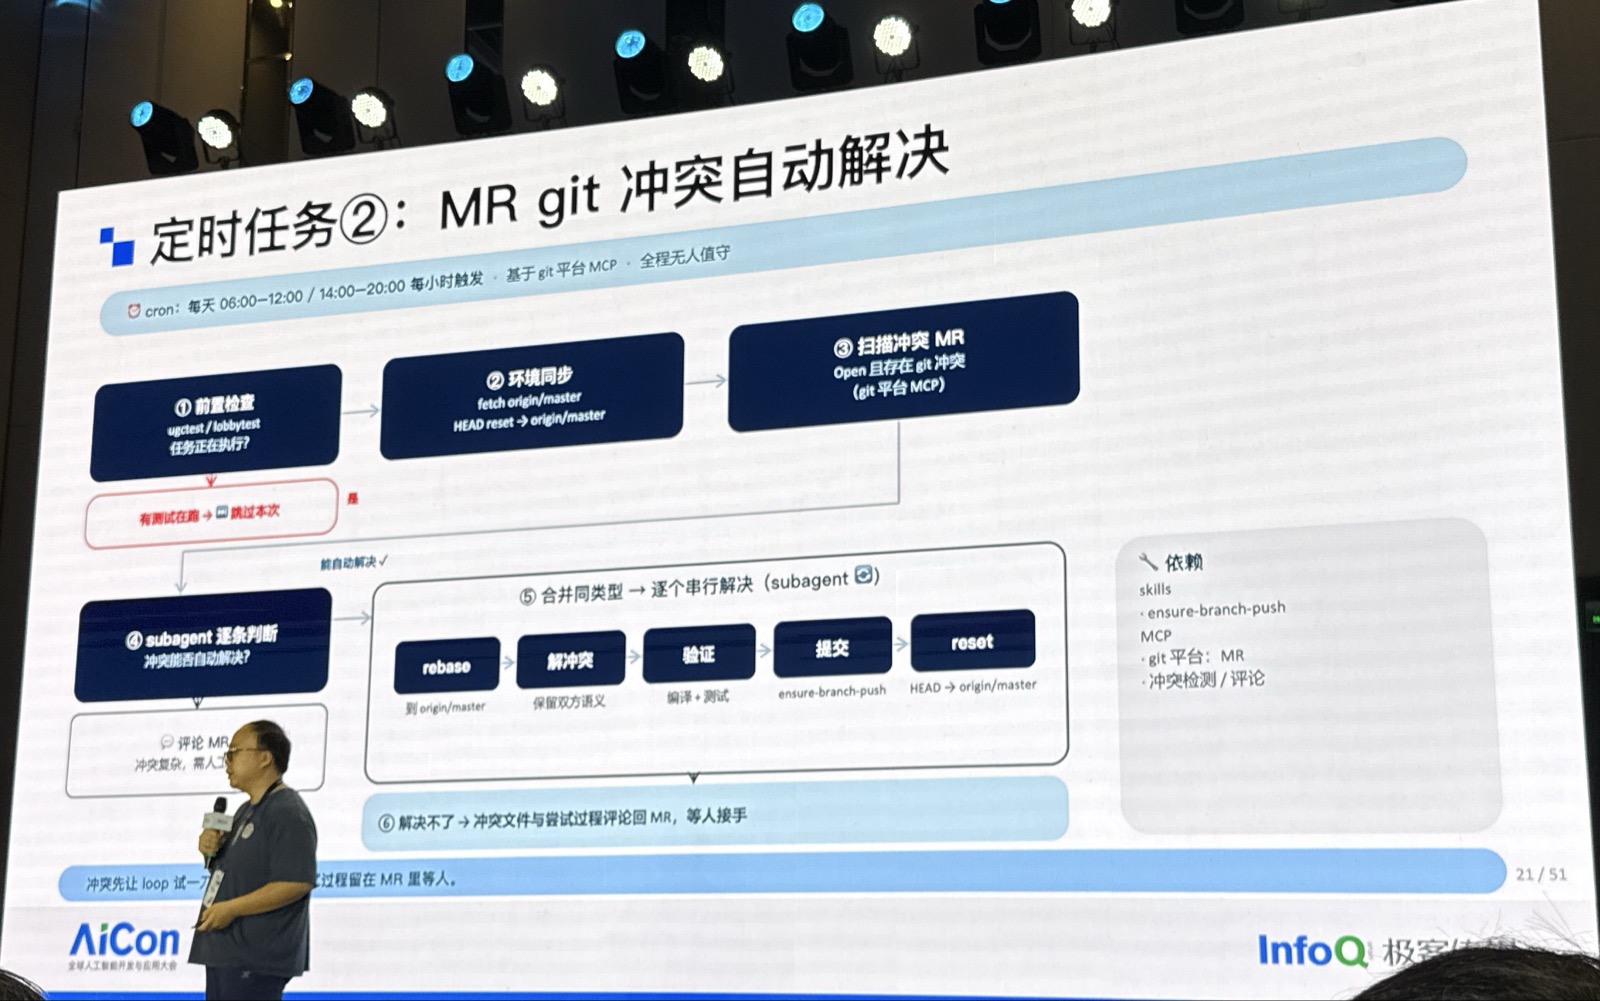
MR/PR 評論反向回饋Memory 回灌故障自癒Auto merge
Agent 工作流架構:事前、事中、事後的分工
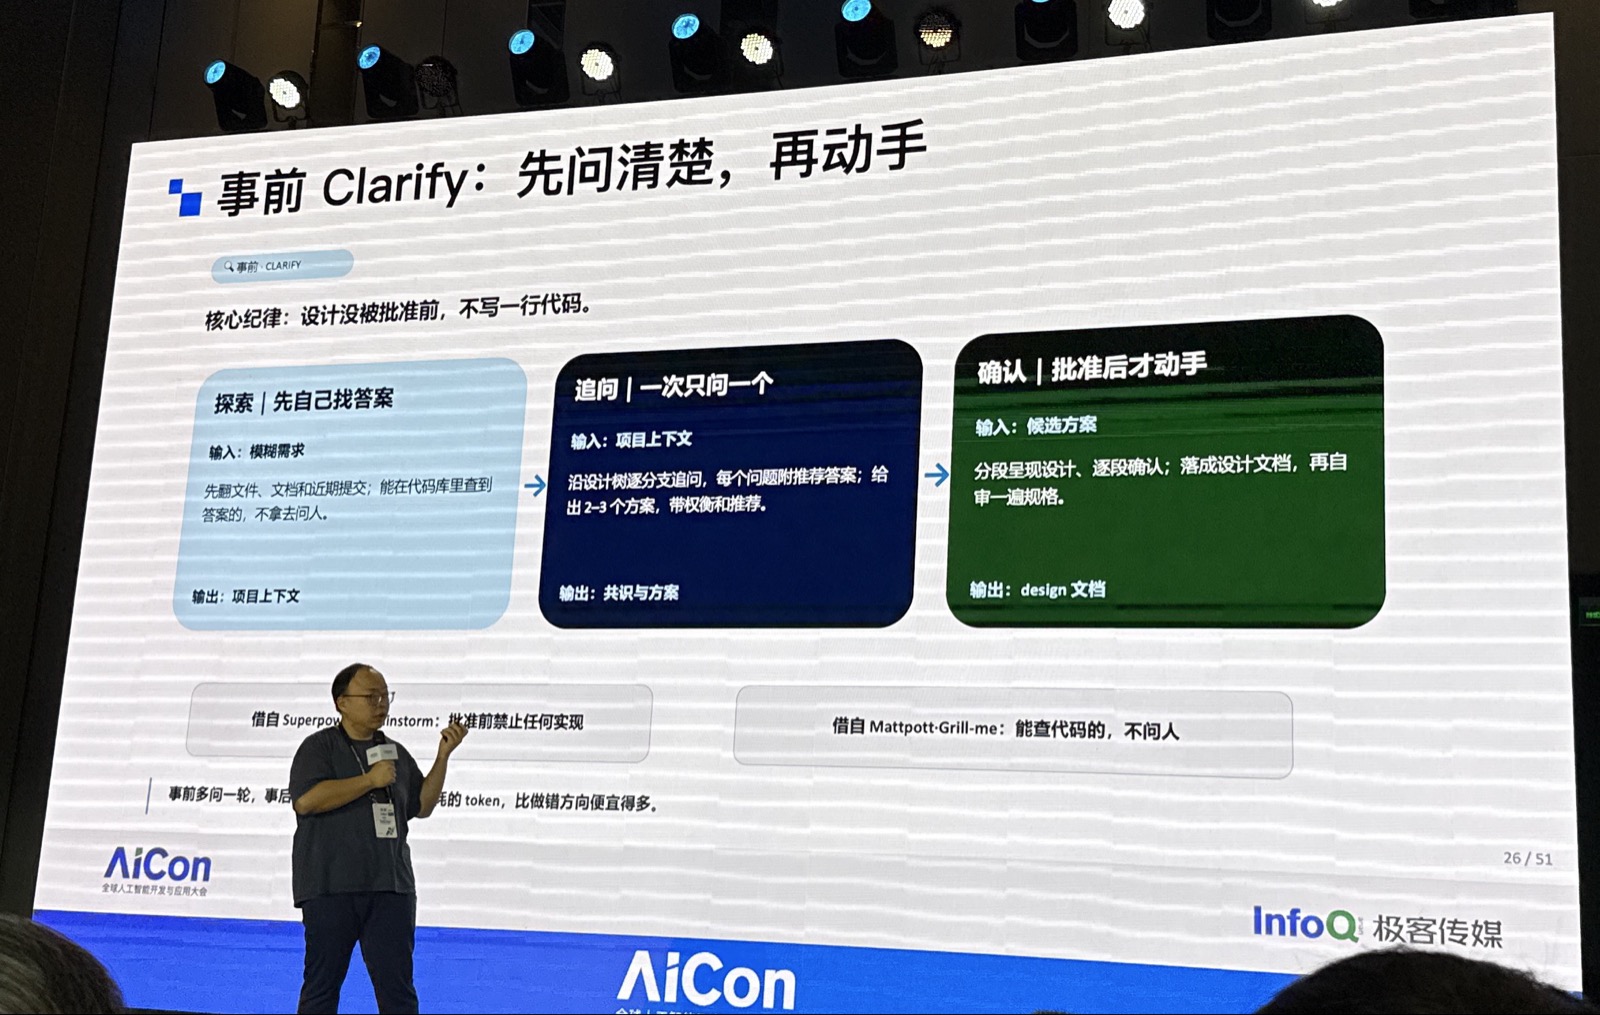
面向工作本身的第三層 Loop,借鑑應用安全的事前、事中、事後結構:事前將需求整理成清楚、結構化的文件;事中讓 Agent 依文件自主產出並提交可審查的 PR;事後才由人與 Agent 針對結果進行評論與回饋。這種分工旨在提升併發,同時留下可驗證的紀錄。
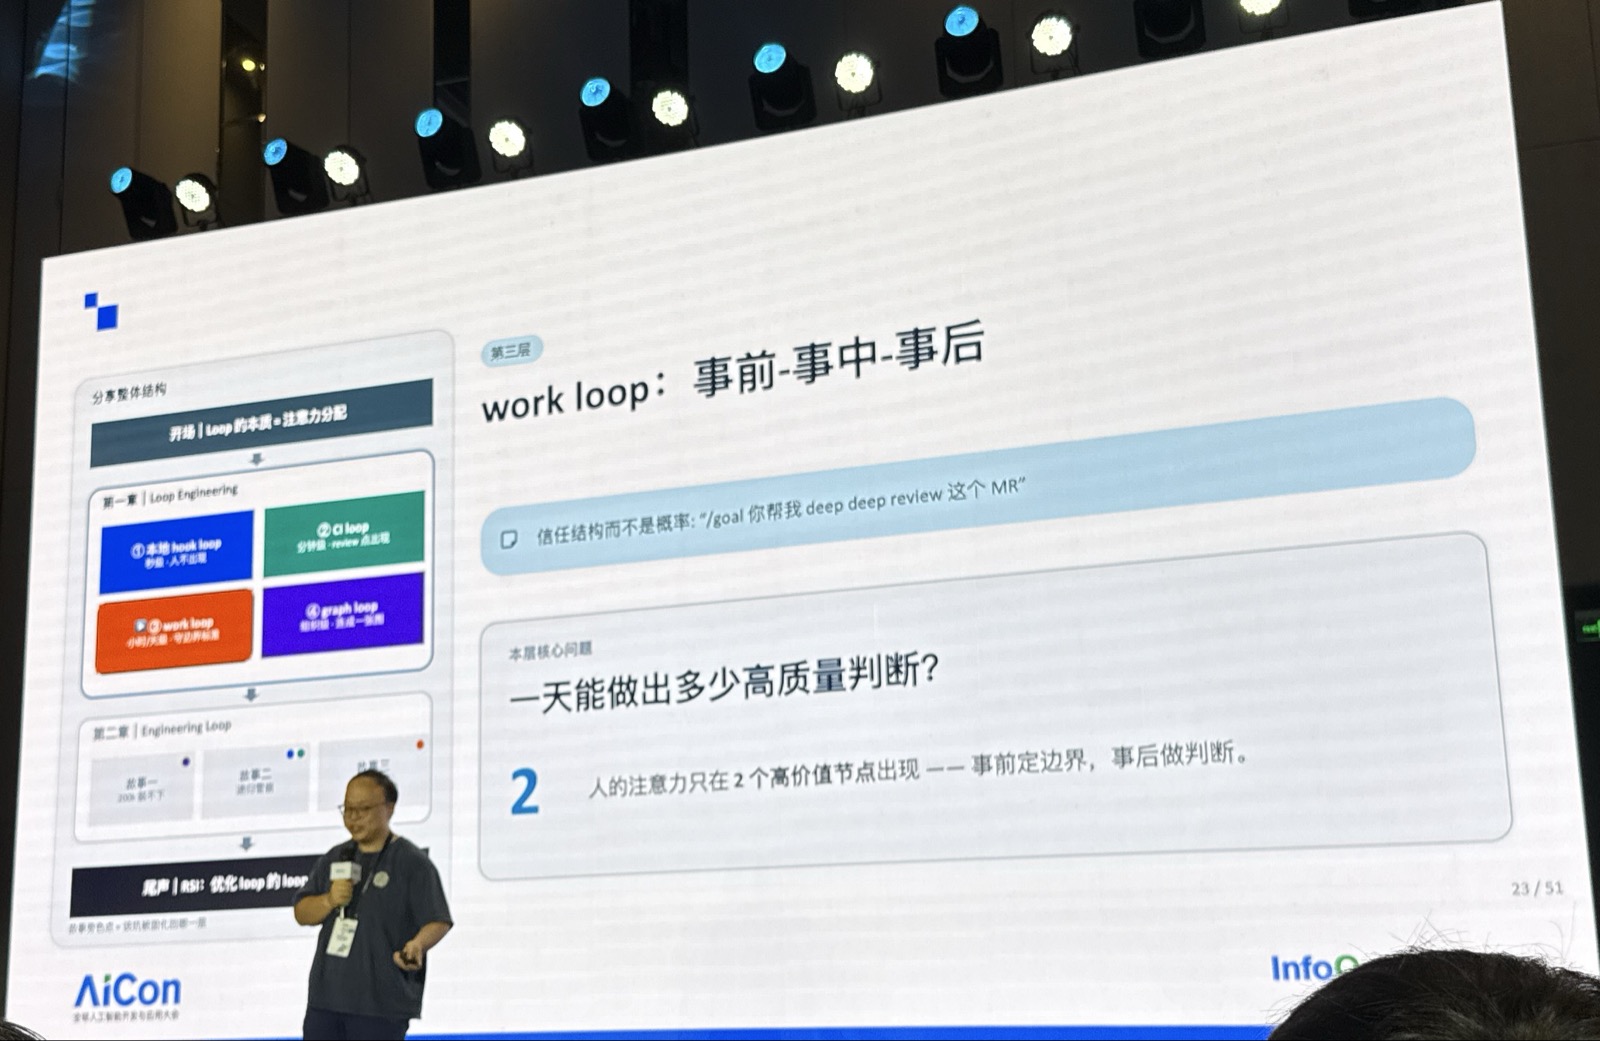
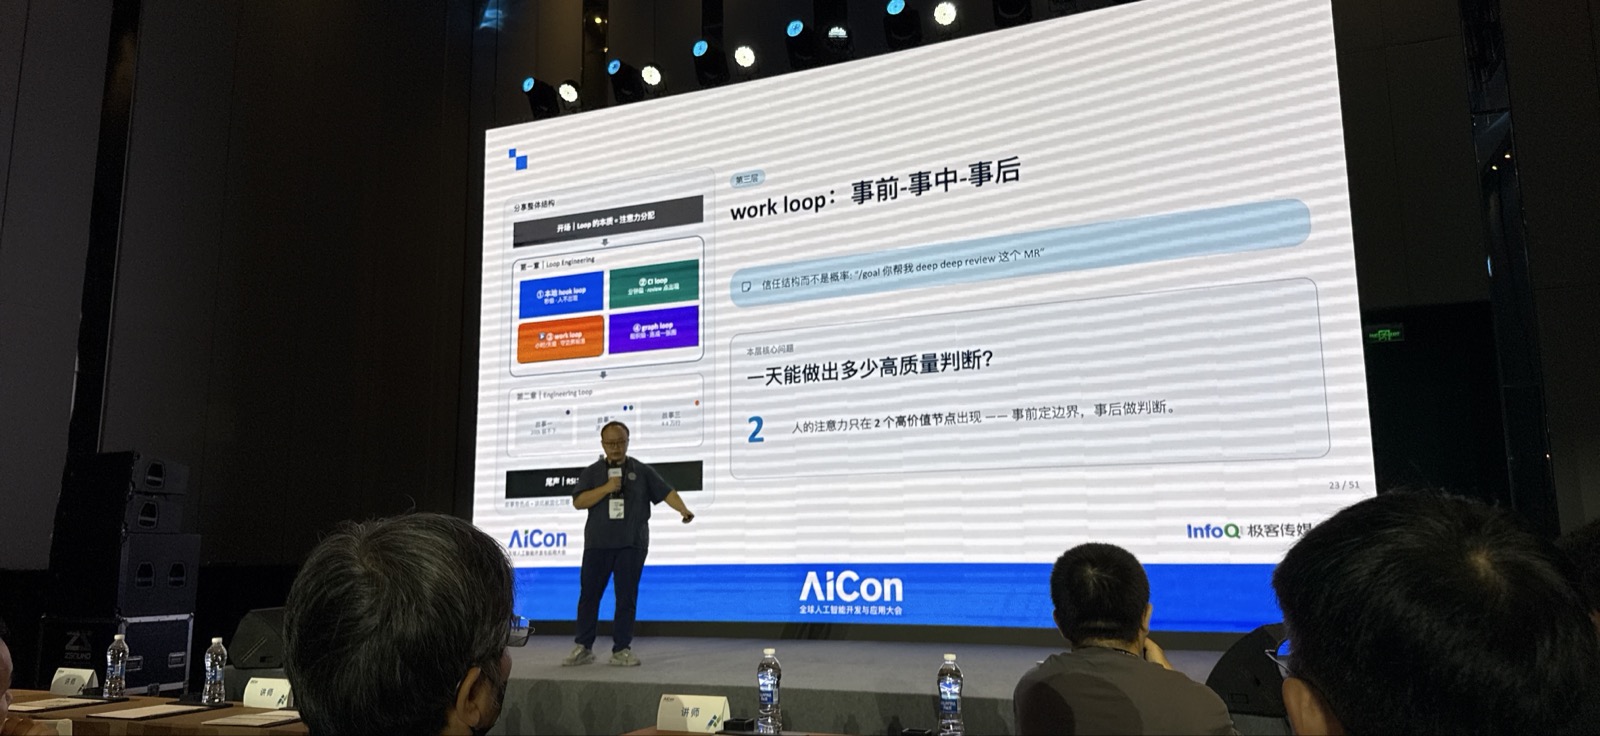
分享者特別主張:人的評論應盡量放在事後,而非事中。事中對 Agent 文件的即時介入難以快速驗證,也不易累積;在 PR 階段評論,則能沉澱為可回看、可檢驗「是否真的修正」的資料庫。
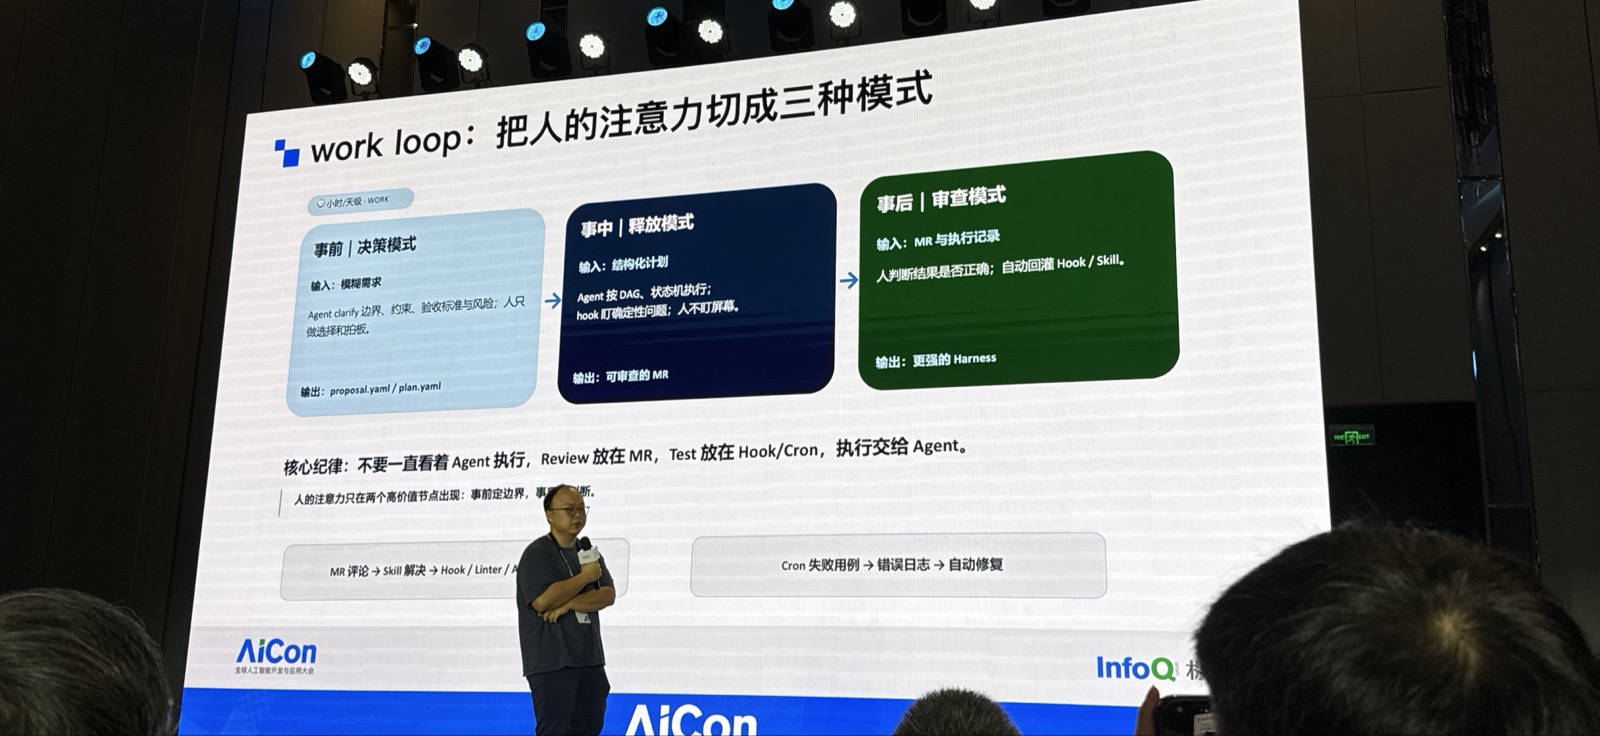
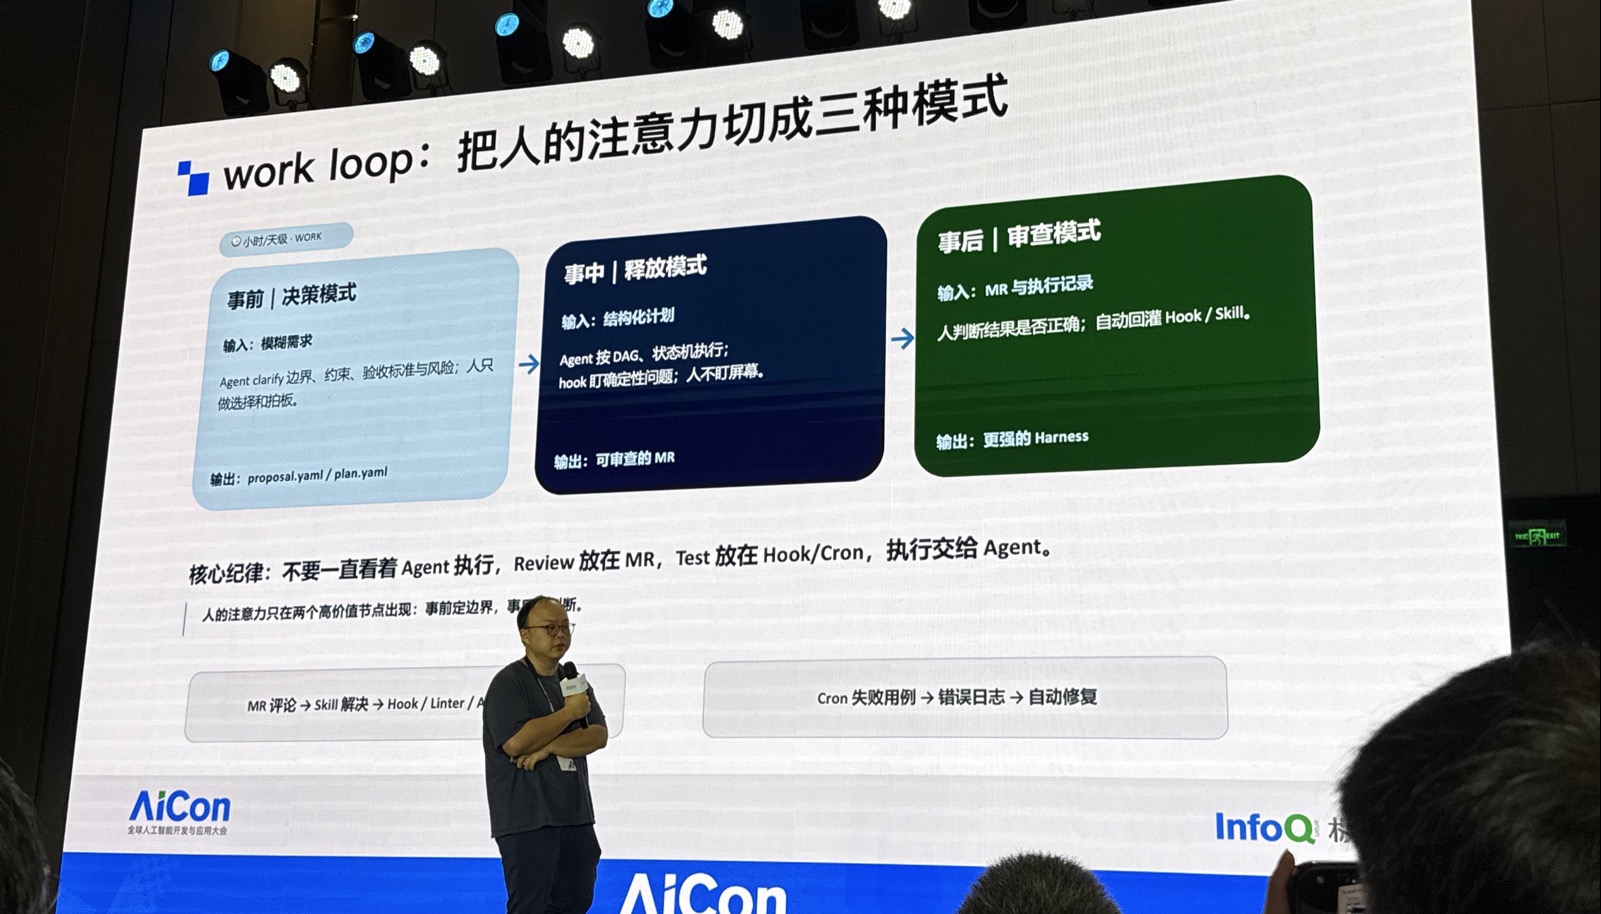
事前的關鍵是把需求邊界、標準與風險說清楚。分享中提及,有工具為釐清一項需求曾提出超過 200 個問題;重點不只是問題數量,而是建立更有效率、可回應的互動訊號。這也說明目前許多 vibe coding 難以直接進入生產環境:約束條件仍必須先被明確化。
- 驗證不宜只追求測試覆蓋率;覆蓋率高不等於測試真正驗證了風險。
- 程式碼與測試皆由同一來源產出,可能形成「自寫自測」的盲點。
- 可將已拆分的結構化需求獨立交給另一角色,產出測試策略與方案,以降低驗證同質性。
人機協同與併發:結構優先於堆疊 Agent
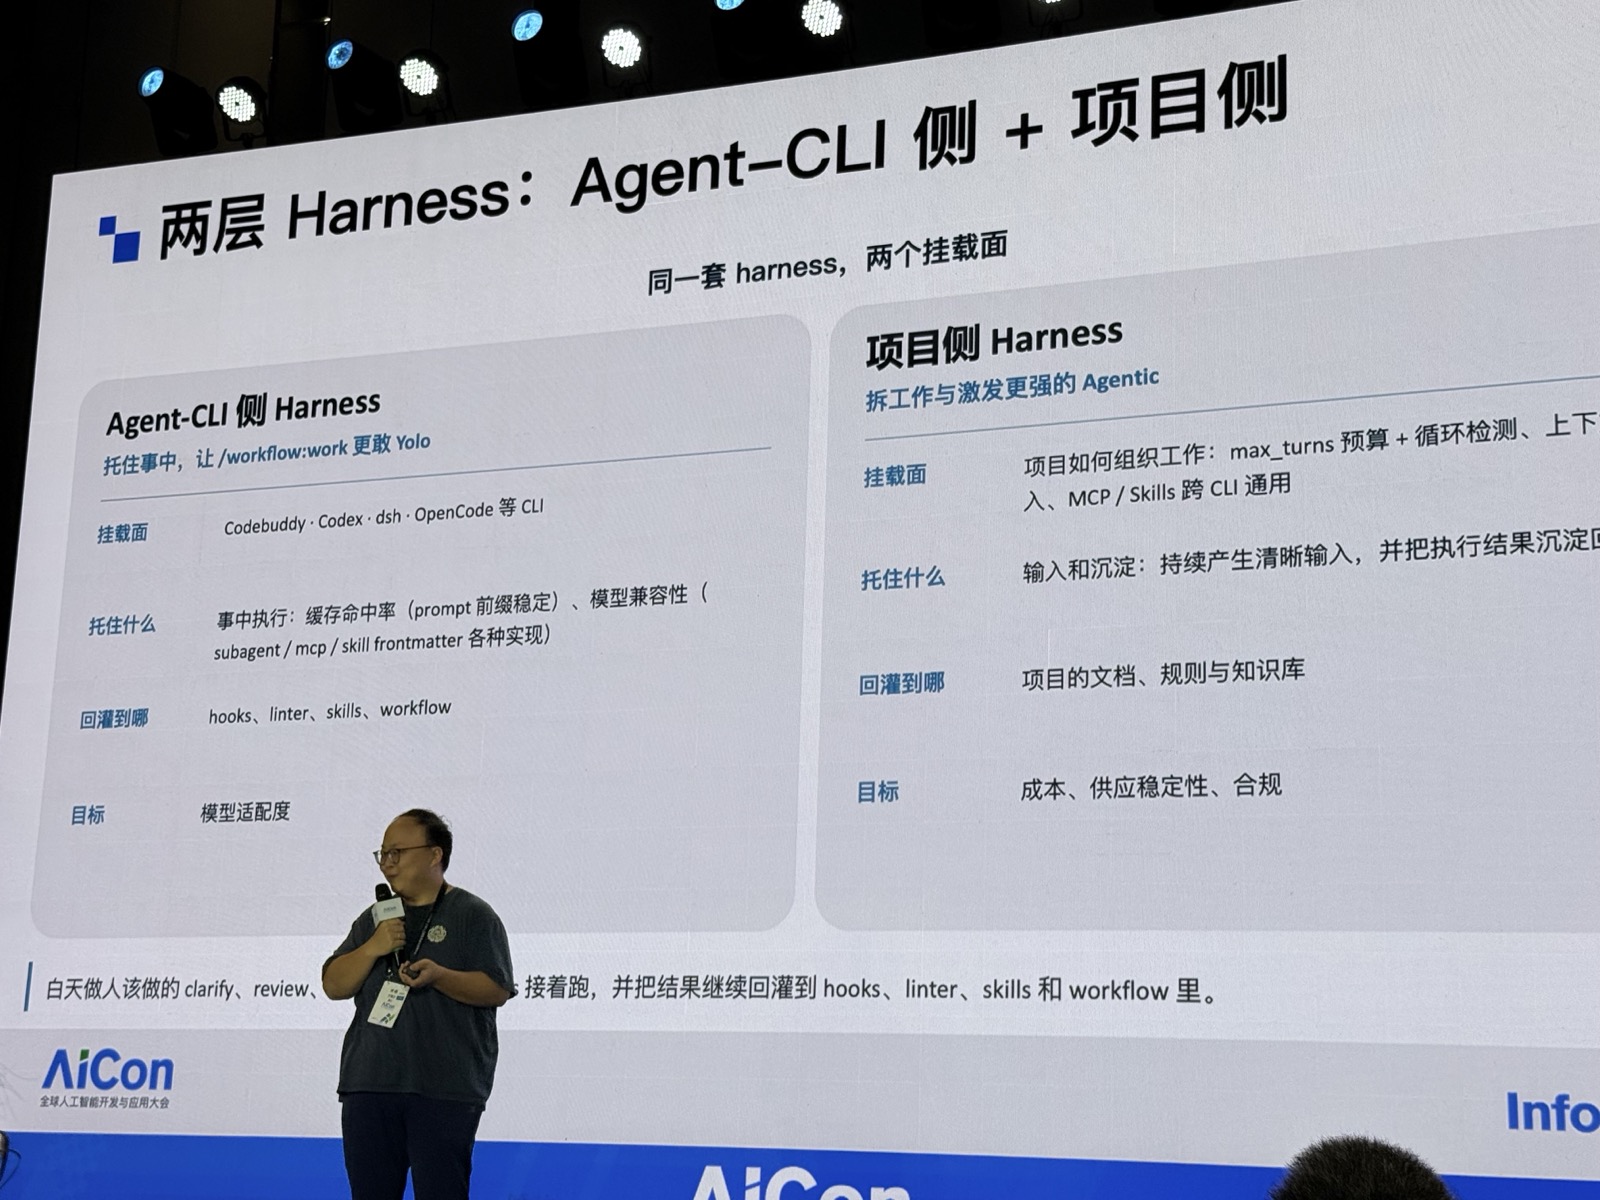
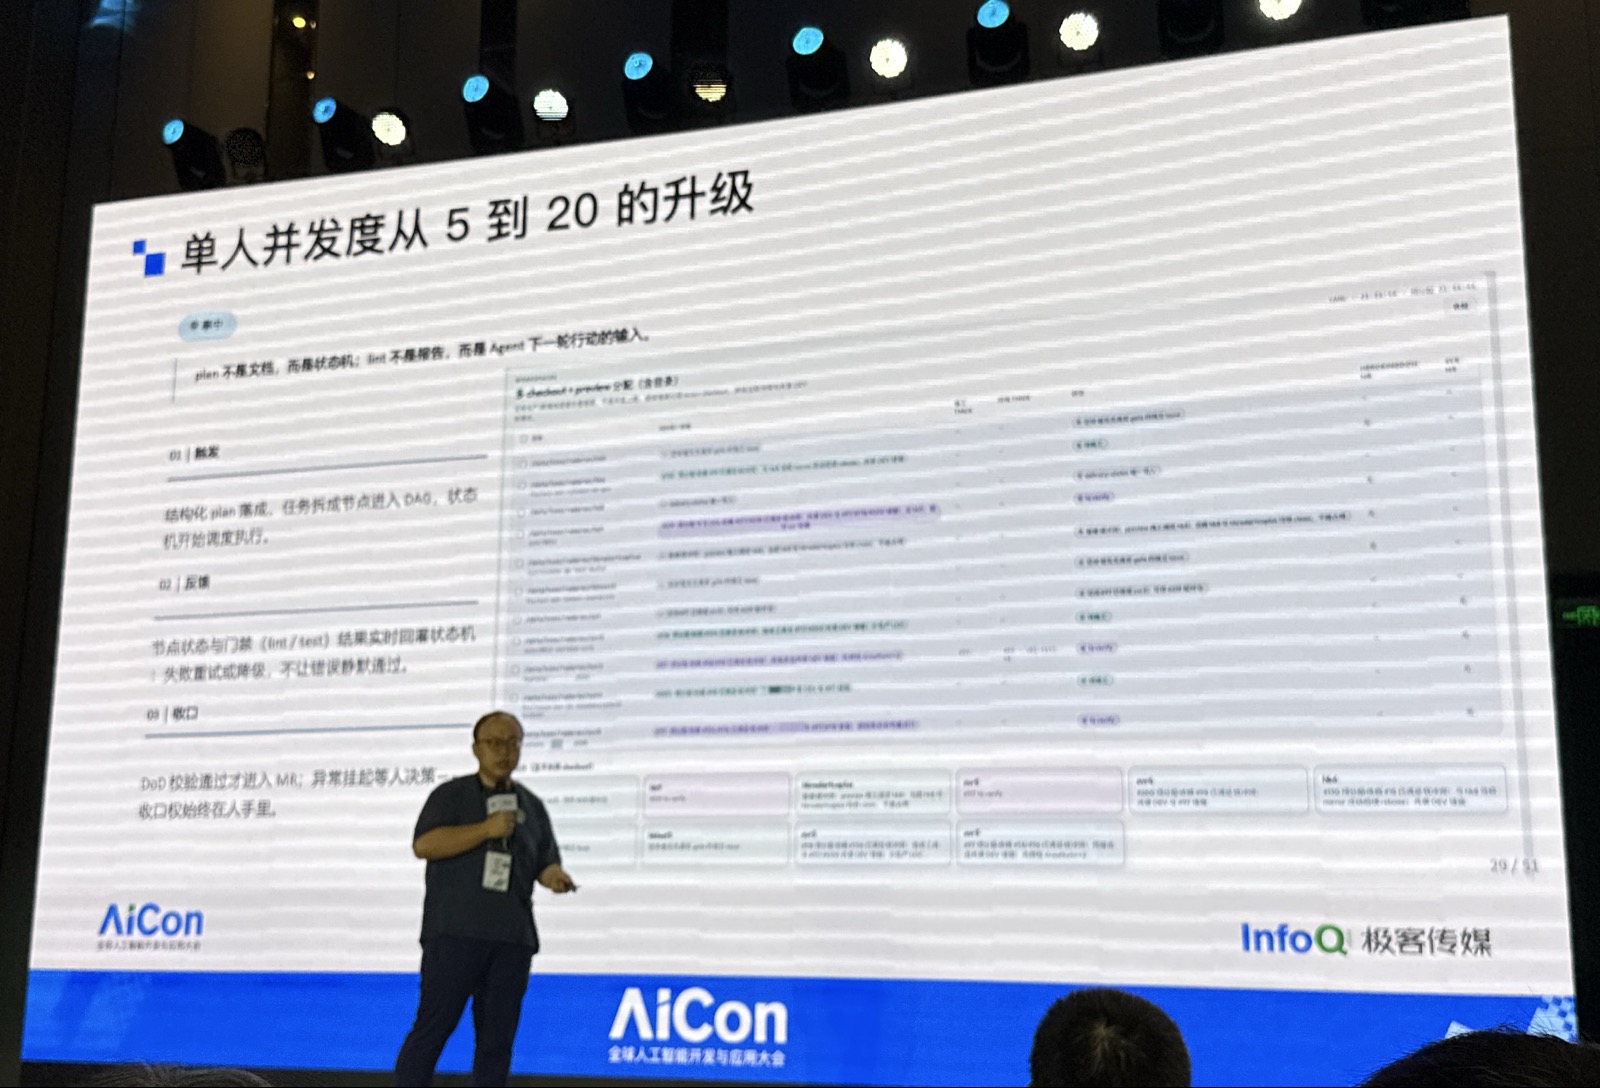
分享者觀察,個人可管理的併發工作量已從約 5 個提升到十幾、二十個;關鍵不是單純增加手段,而是讓工作結構更清晰。對於平行工作,傳統多分支/多工作區方式容易在整合核心時出現衝突與重複;隨著 Agent 能力提升,也開始嘗試讓 Agent 在同一工作區處理相關檔案並自行修復衝突,以減少人工介入。
審查大型變更時,系統可在改動量達一定程度、但文件不足時自動補充文件,讓 reviewer 先理解「這段程式碼要做什麼」,再進入實作細節。此做法也有助於保持文件與程式碼的同步。
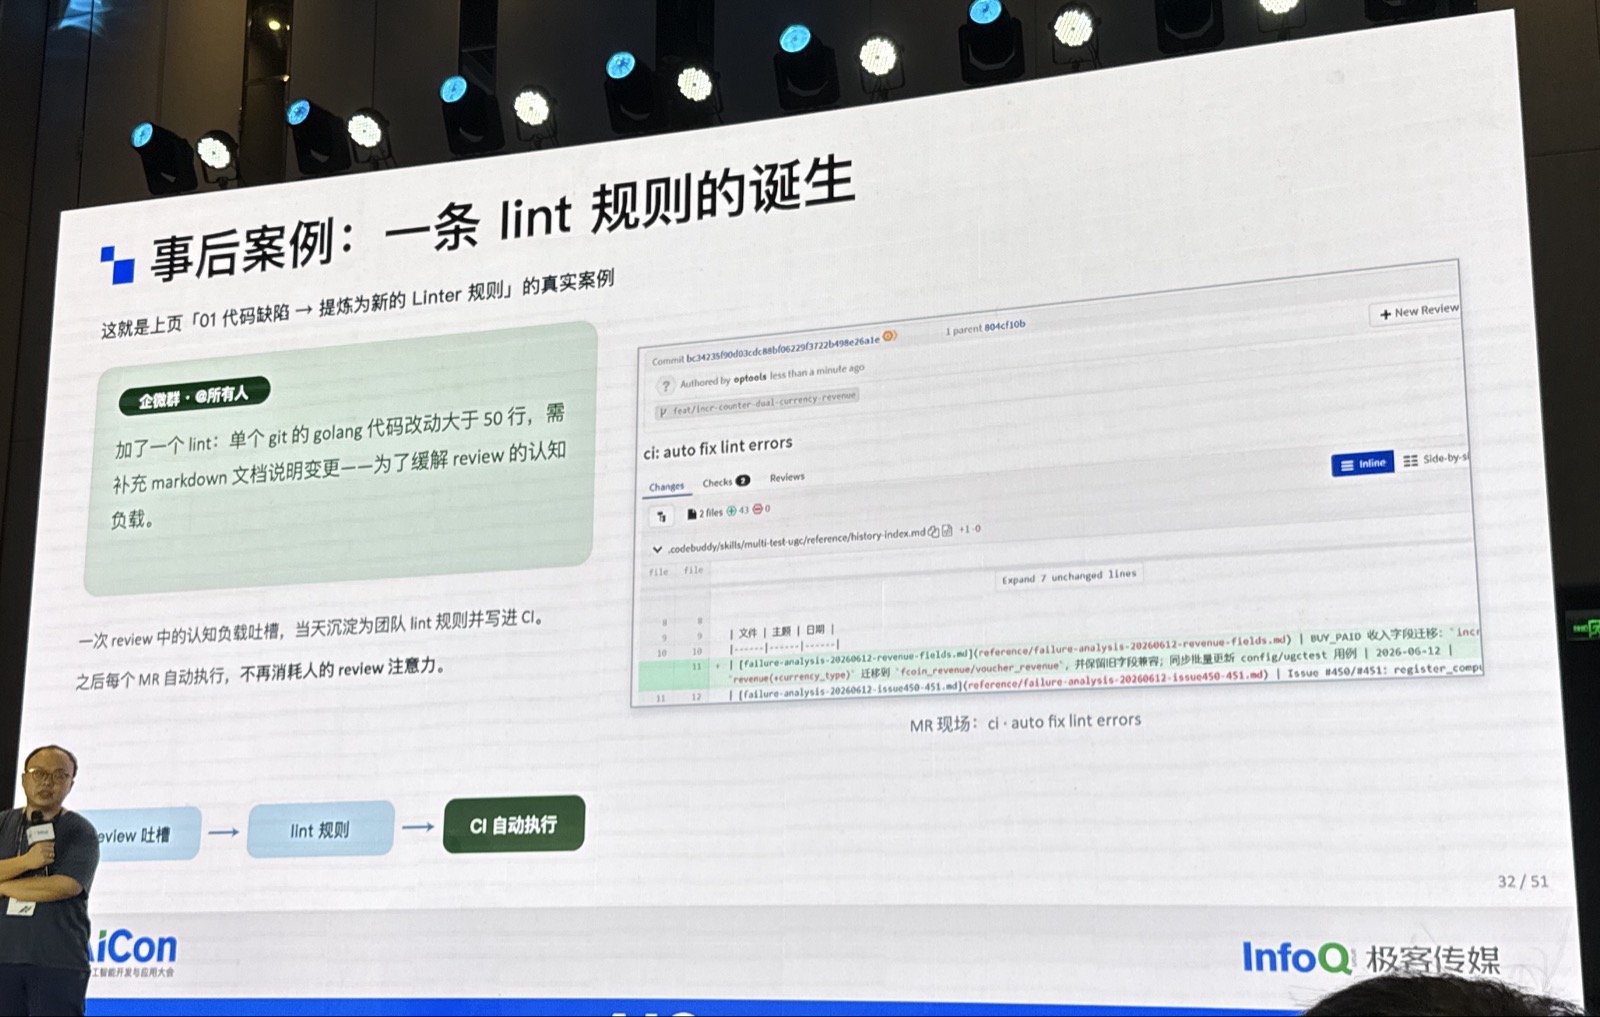
Loop 必須有指標,但不宜只看單點產量。分享者提出以觀測指標檢視:MR 評論數是否隨記憶回灌而下降、重複評論占比是否降低,以及是否能持續減少相同錯誤。目標不是讓評論絕對歸零,而是追求「不二過」。
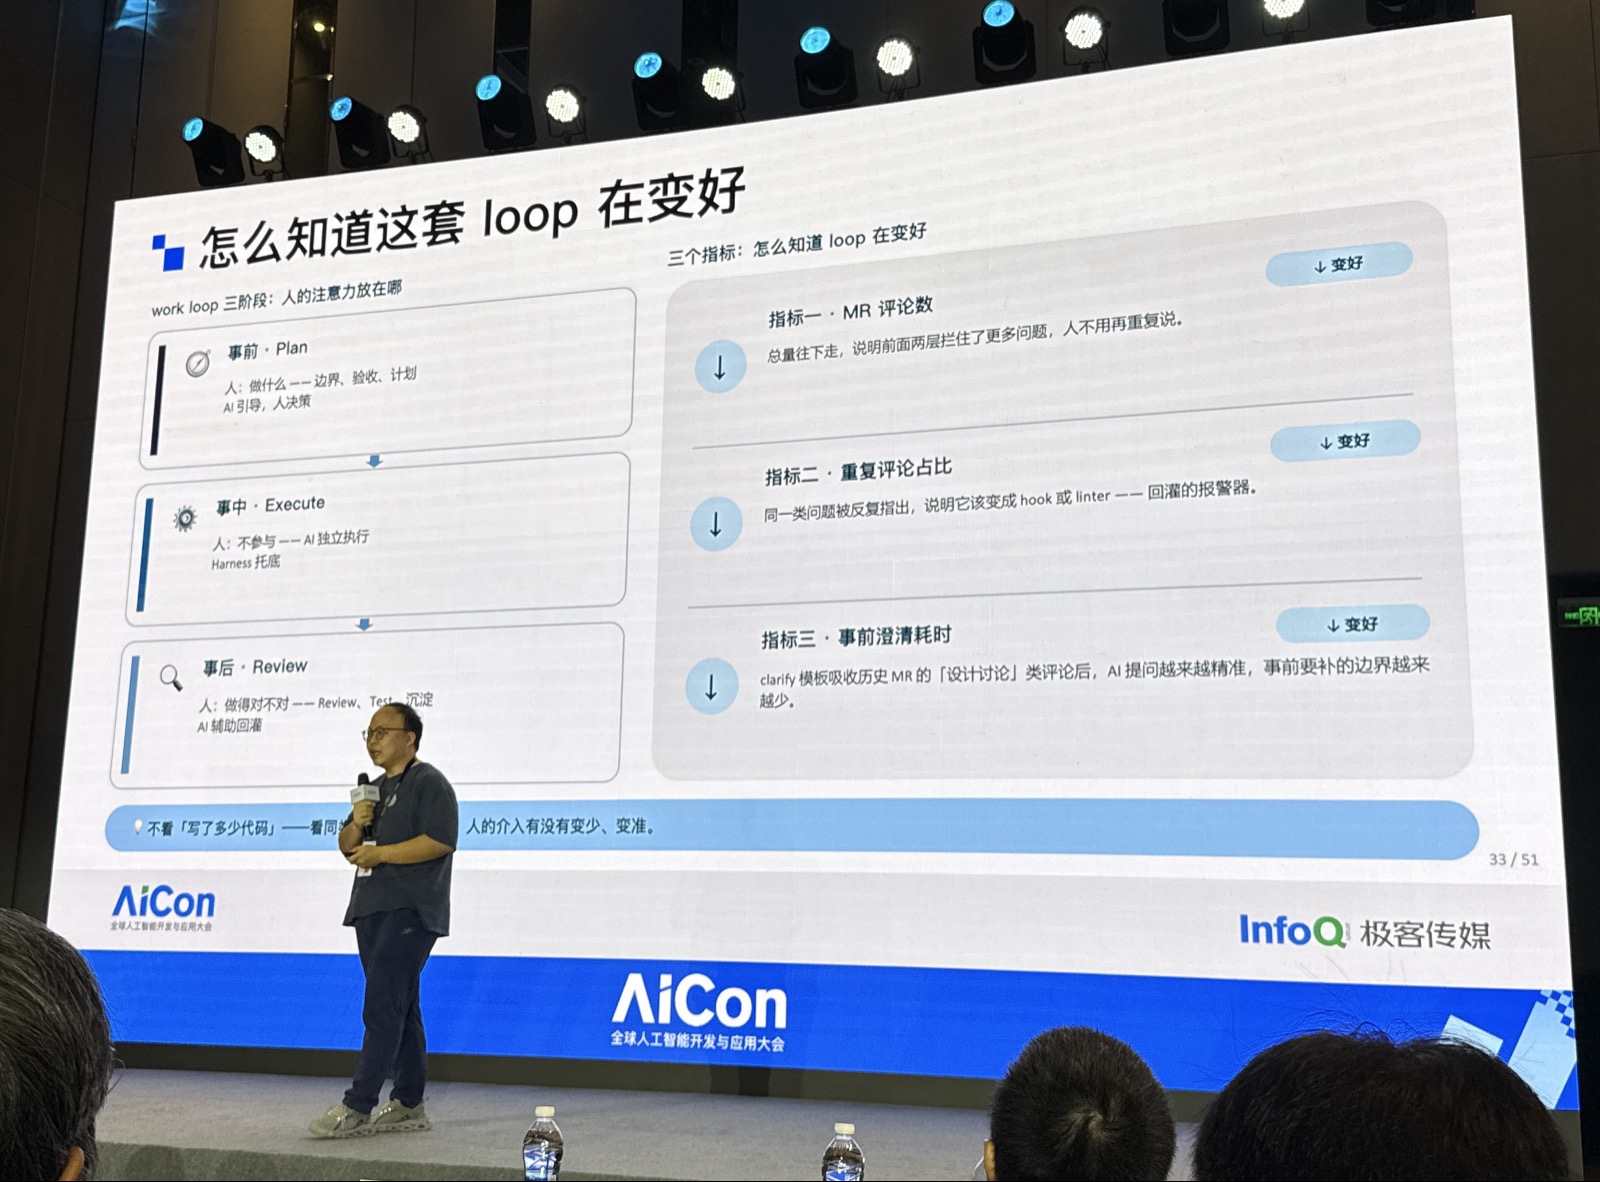
「我們人其實就只在事前做一個選擇題,事後做一個 review 的評論。」
— 分享者
從個人 Loop 到 Graph Loop:讓能力跨需求流動
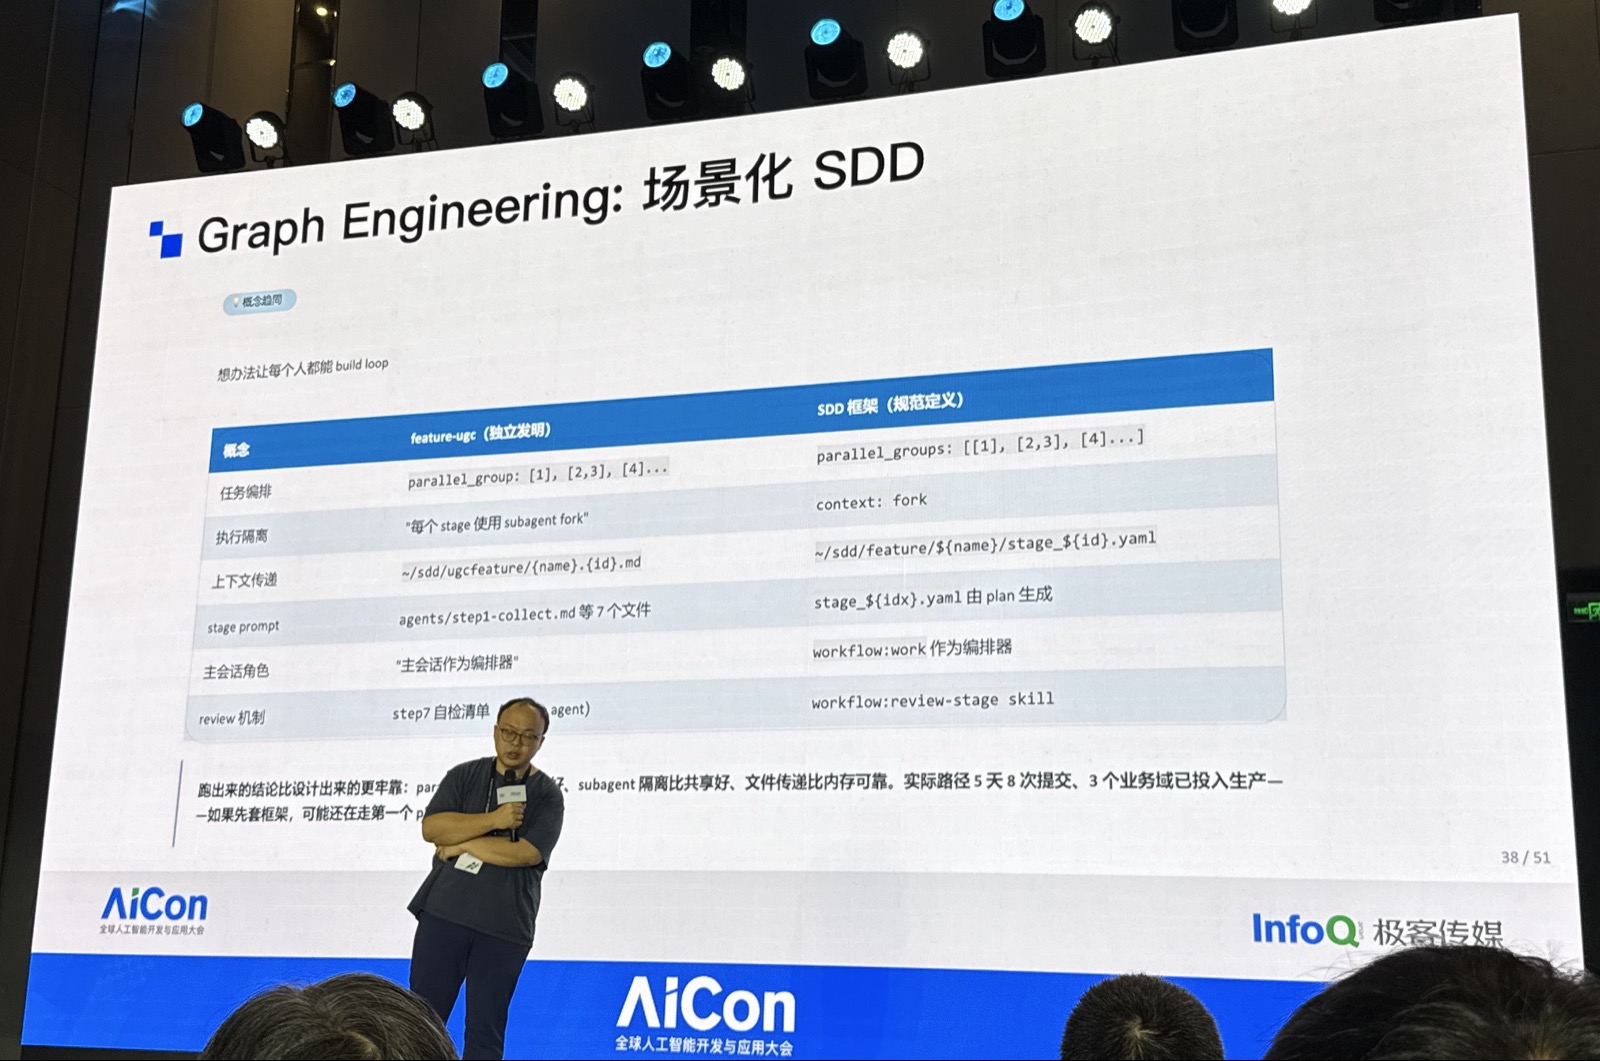
當每個需求都擁有自己的工作台與迴路後,任務之間、團隊成員之間會出現依賴關係。個人 Loop 即使能修正局部衝突,也未必提升團隊總體產出;因此需要 <keywords>Graph Loop</keywords> 進行編排,將需求、能力與依賴關係納入更大的協作結構。
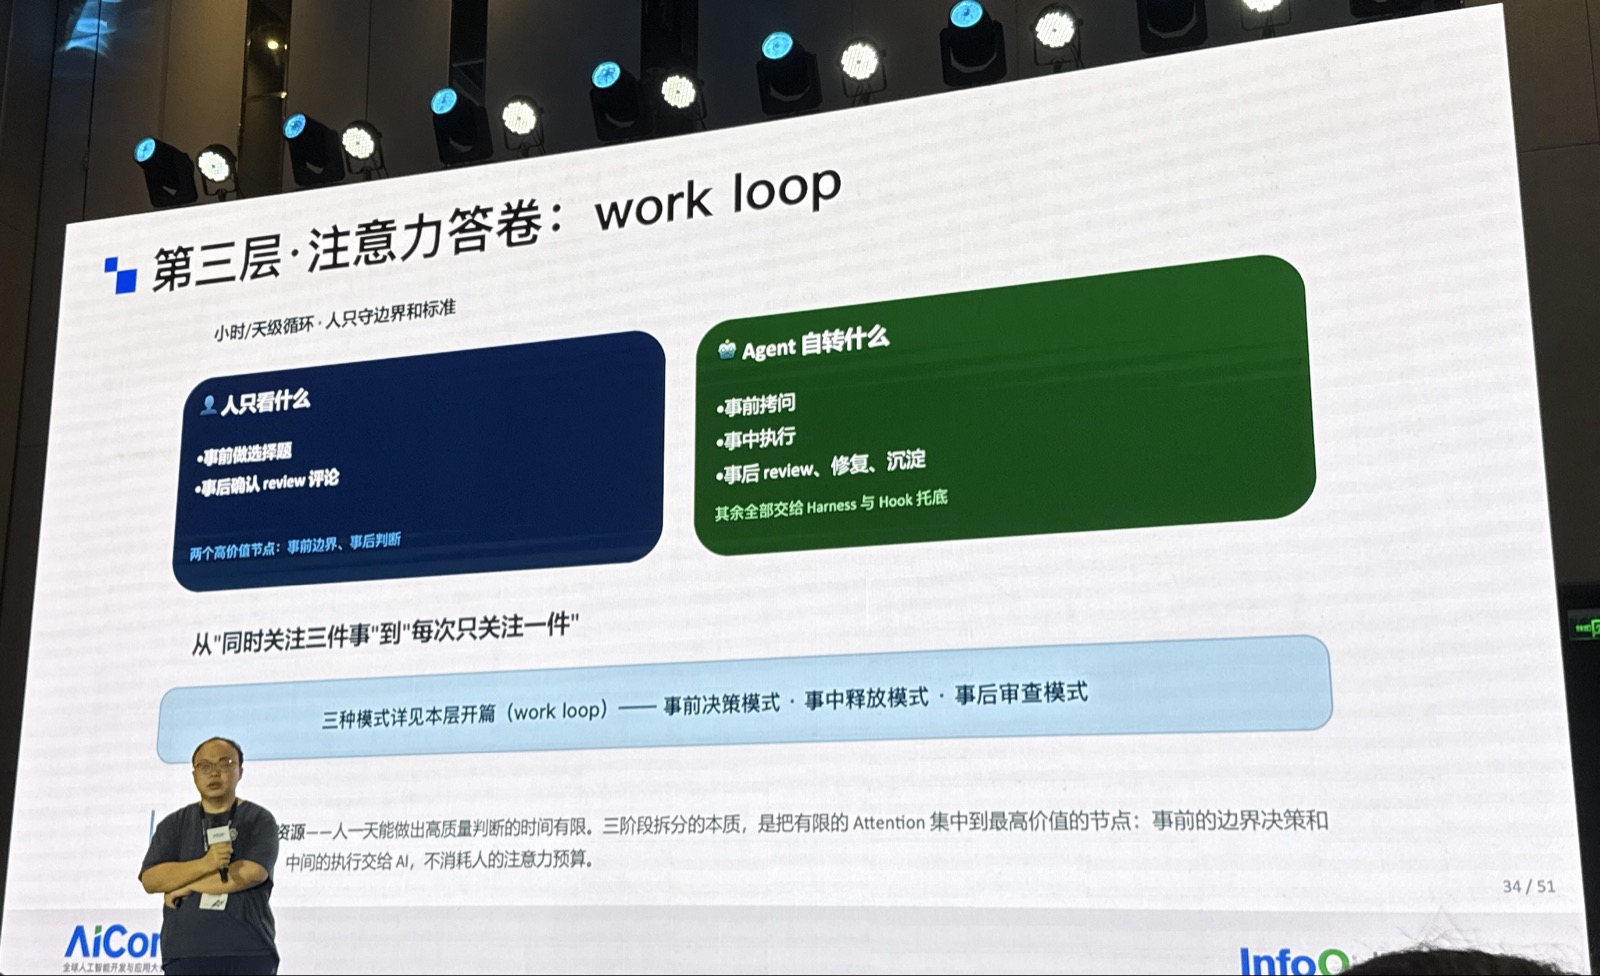
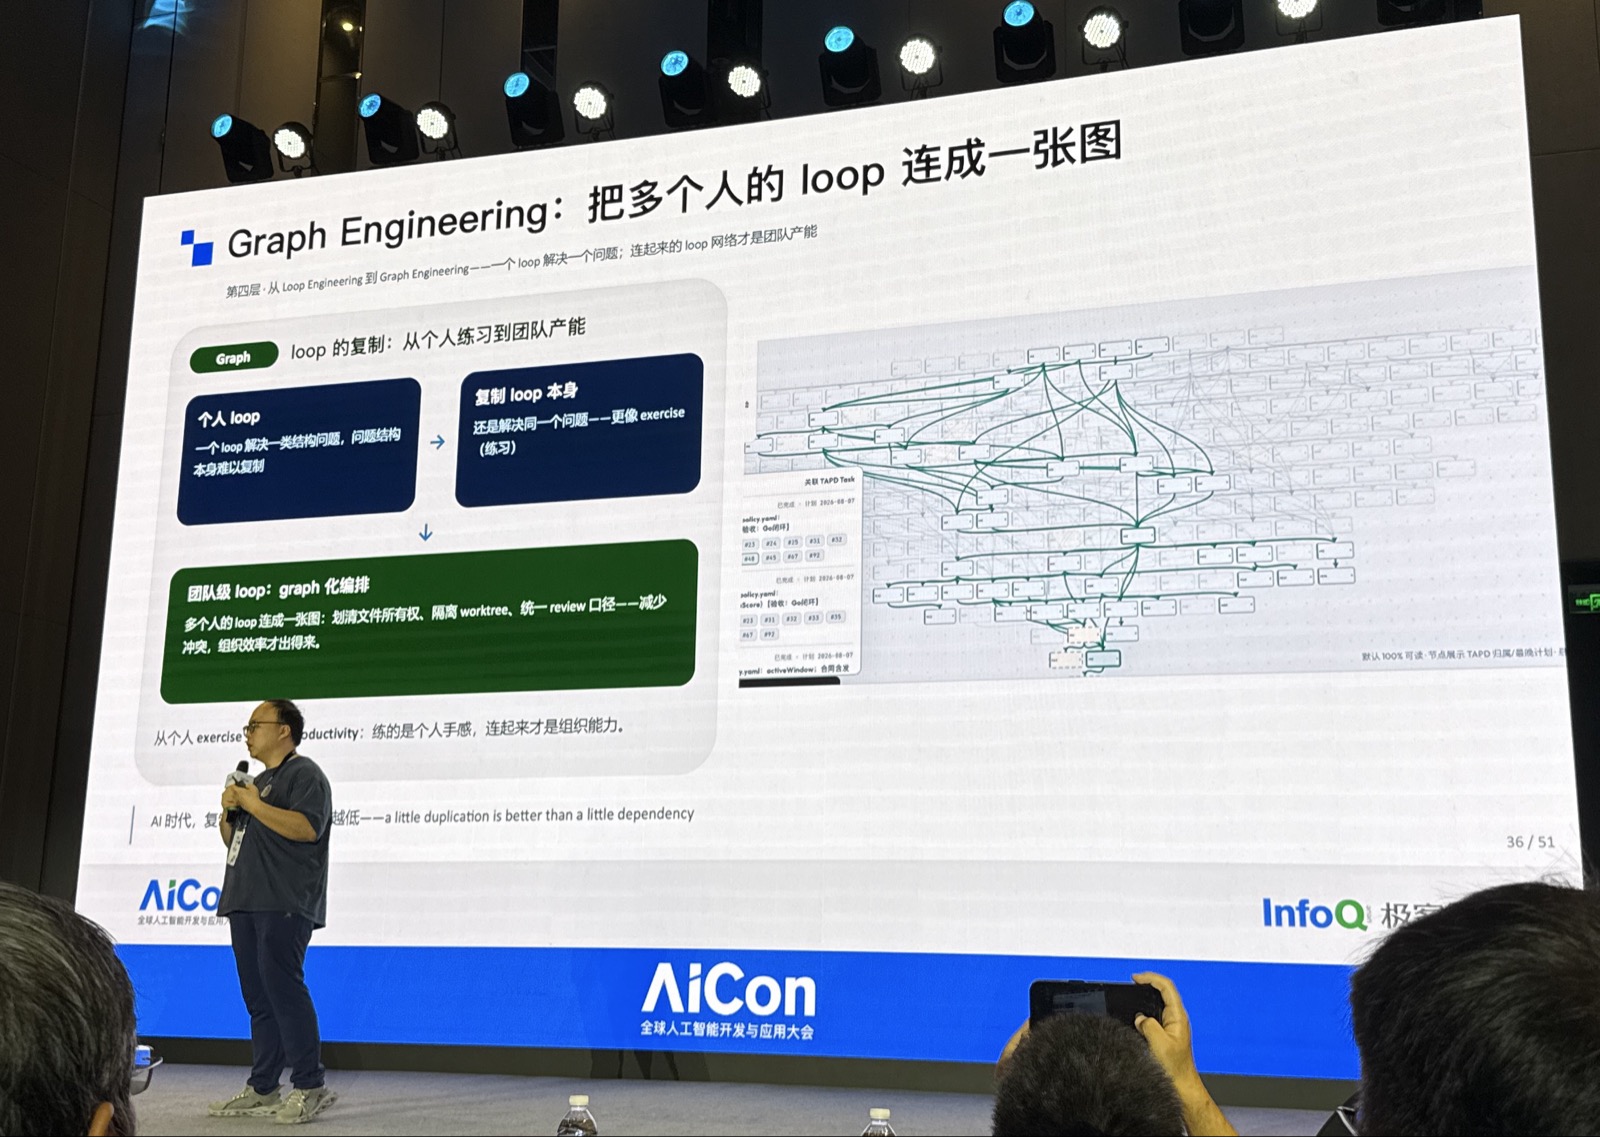
可行方向是將 Loop 能力模組化、插件化,使不同工作台能按需接線,而不是強迫完全複製。分享者亦提出情境化 SDD:不只由少數人維護一套通用框架,而是讓每個需求都有成本較低、可參與且能回灌底層能力的規格驅動流程。
實務踩坑與風險:Open Loop 必須設界
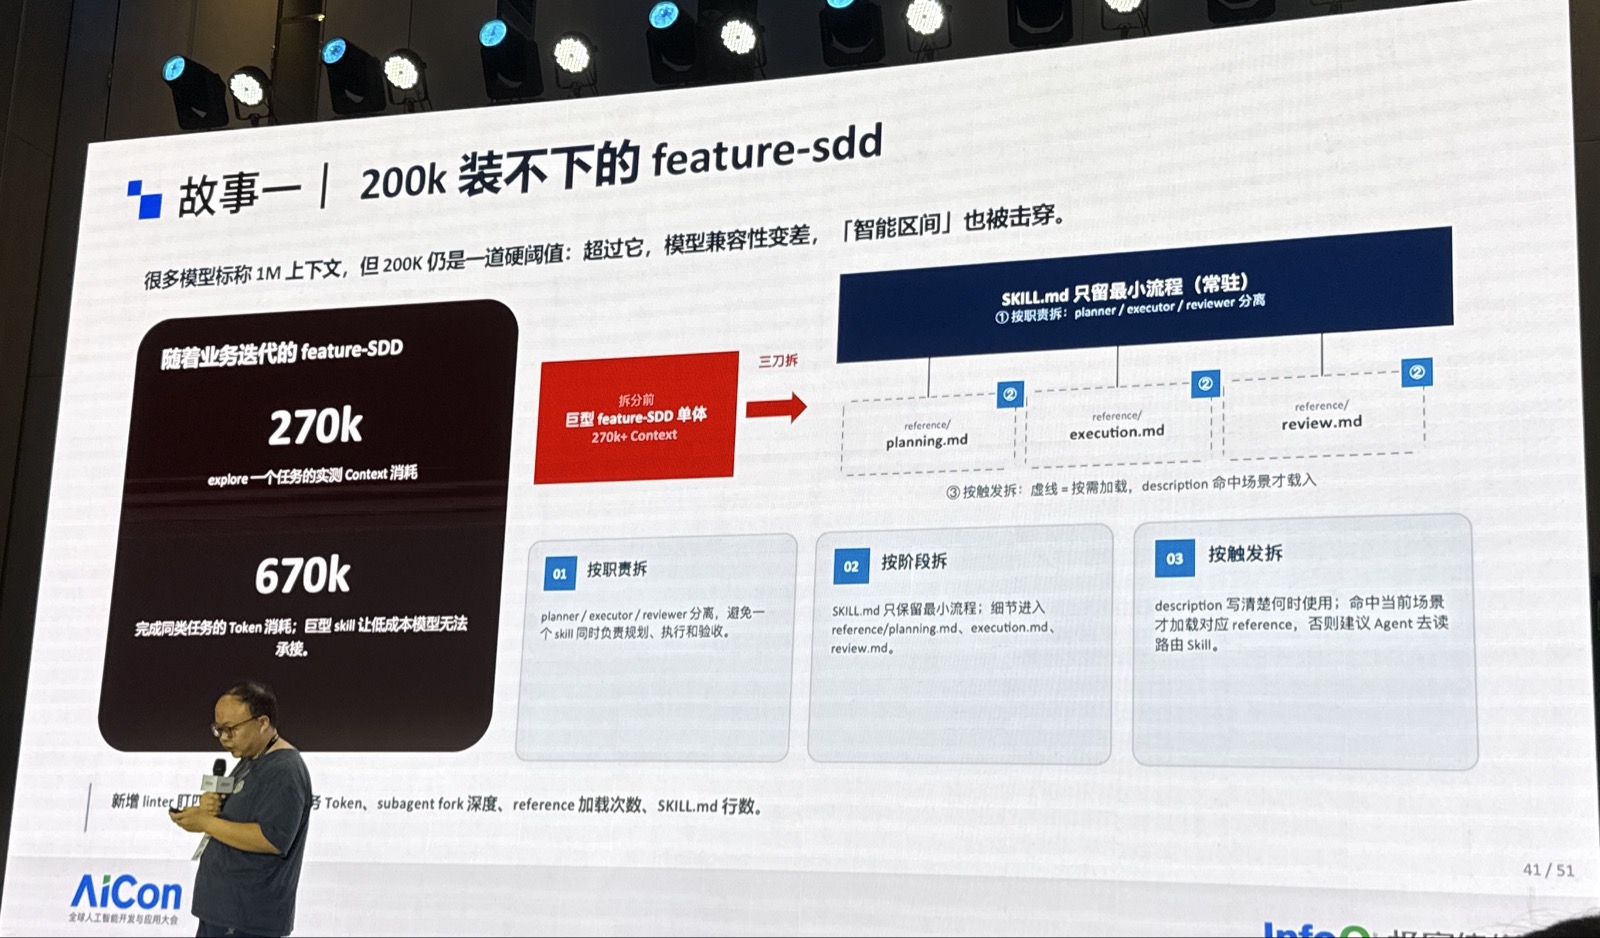
分享者提醒,Open Loop 若缺乏邊界,會把局部優化放大成成本與複雜度風險。第一類問題是各自回灌的 SDD 與多個 MCP 接入後,內容持續膨脹;案例中,需求所需上下文曾由約 600K,透過分層路由與索引管理降至約 100K。
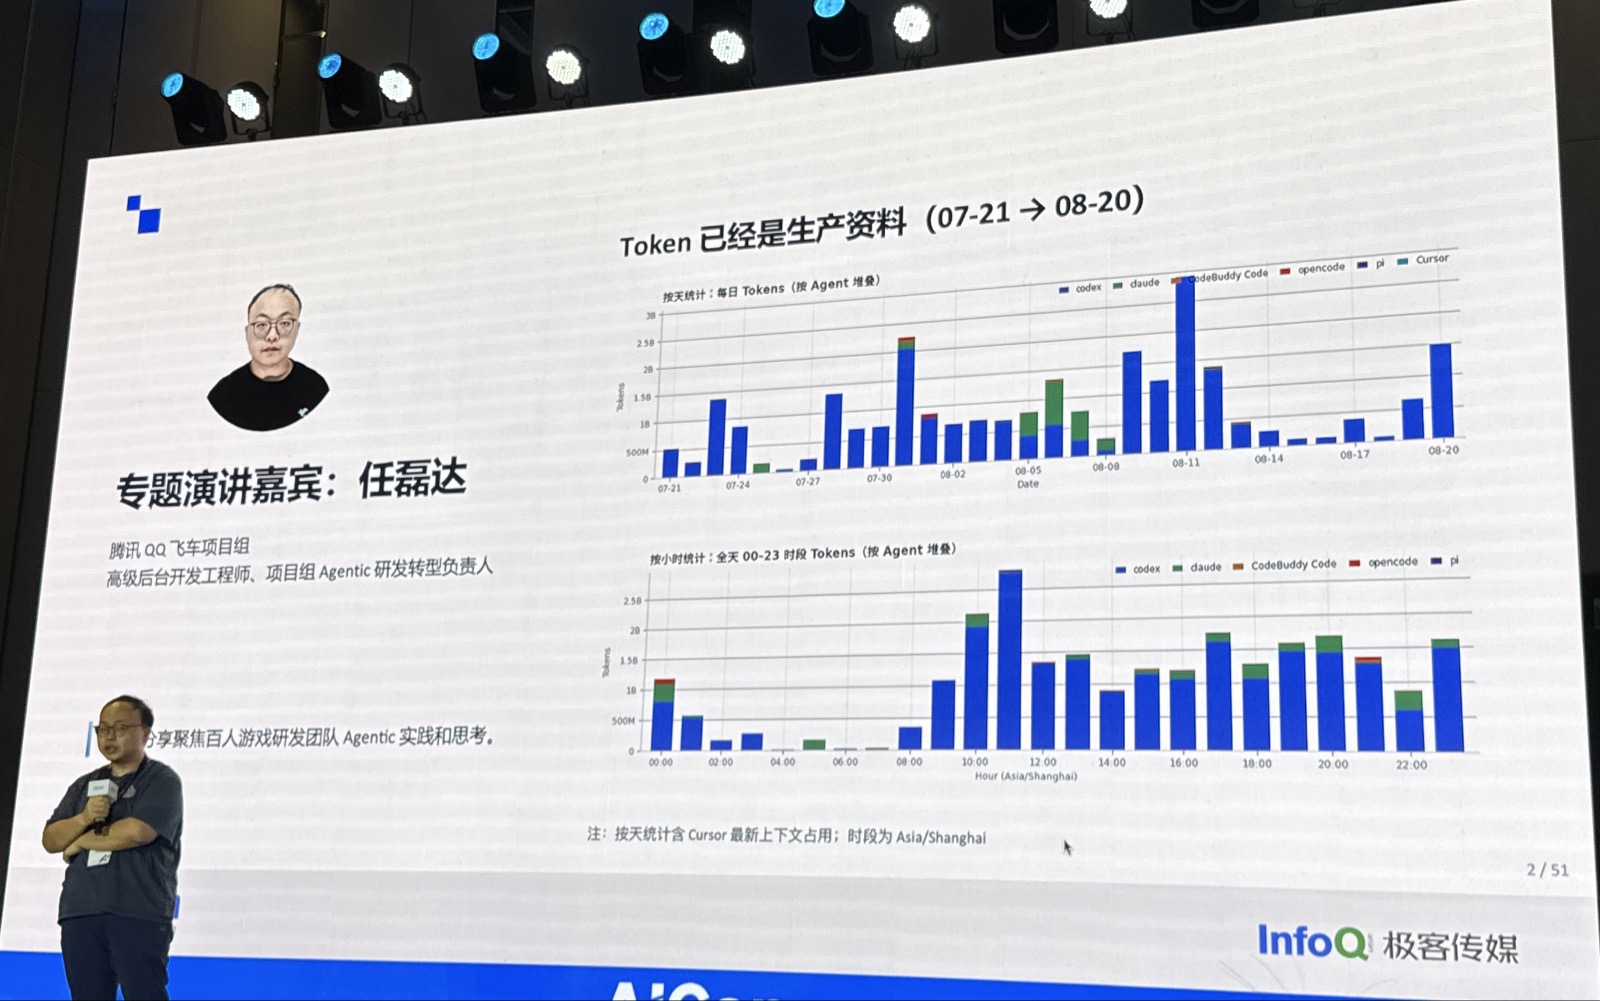
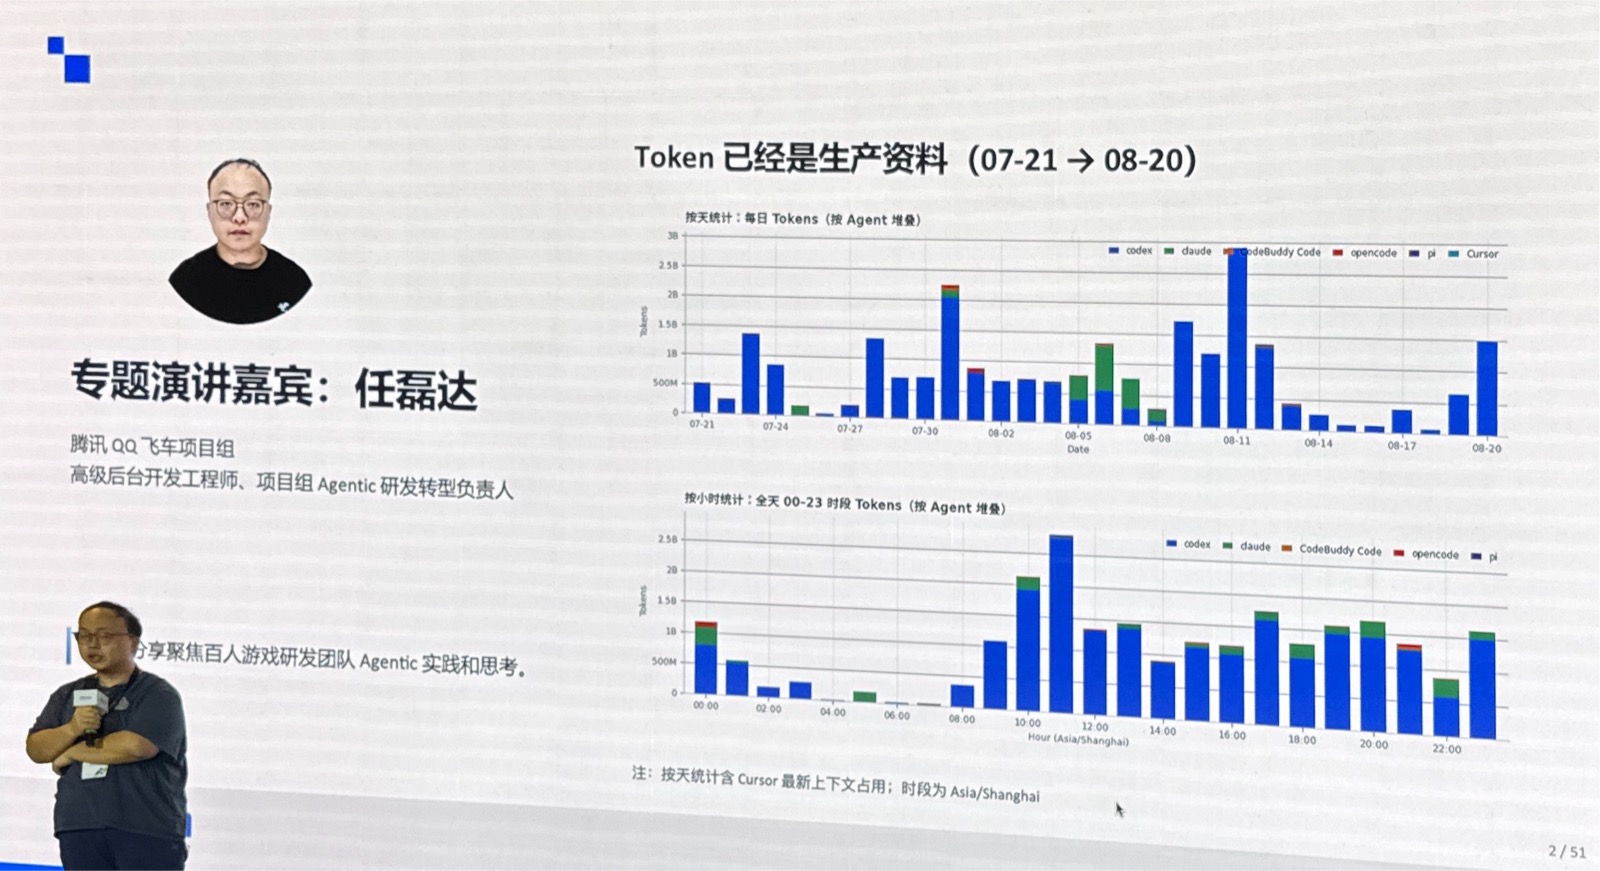
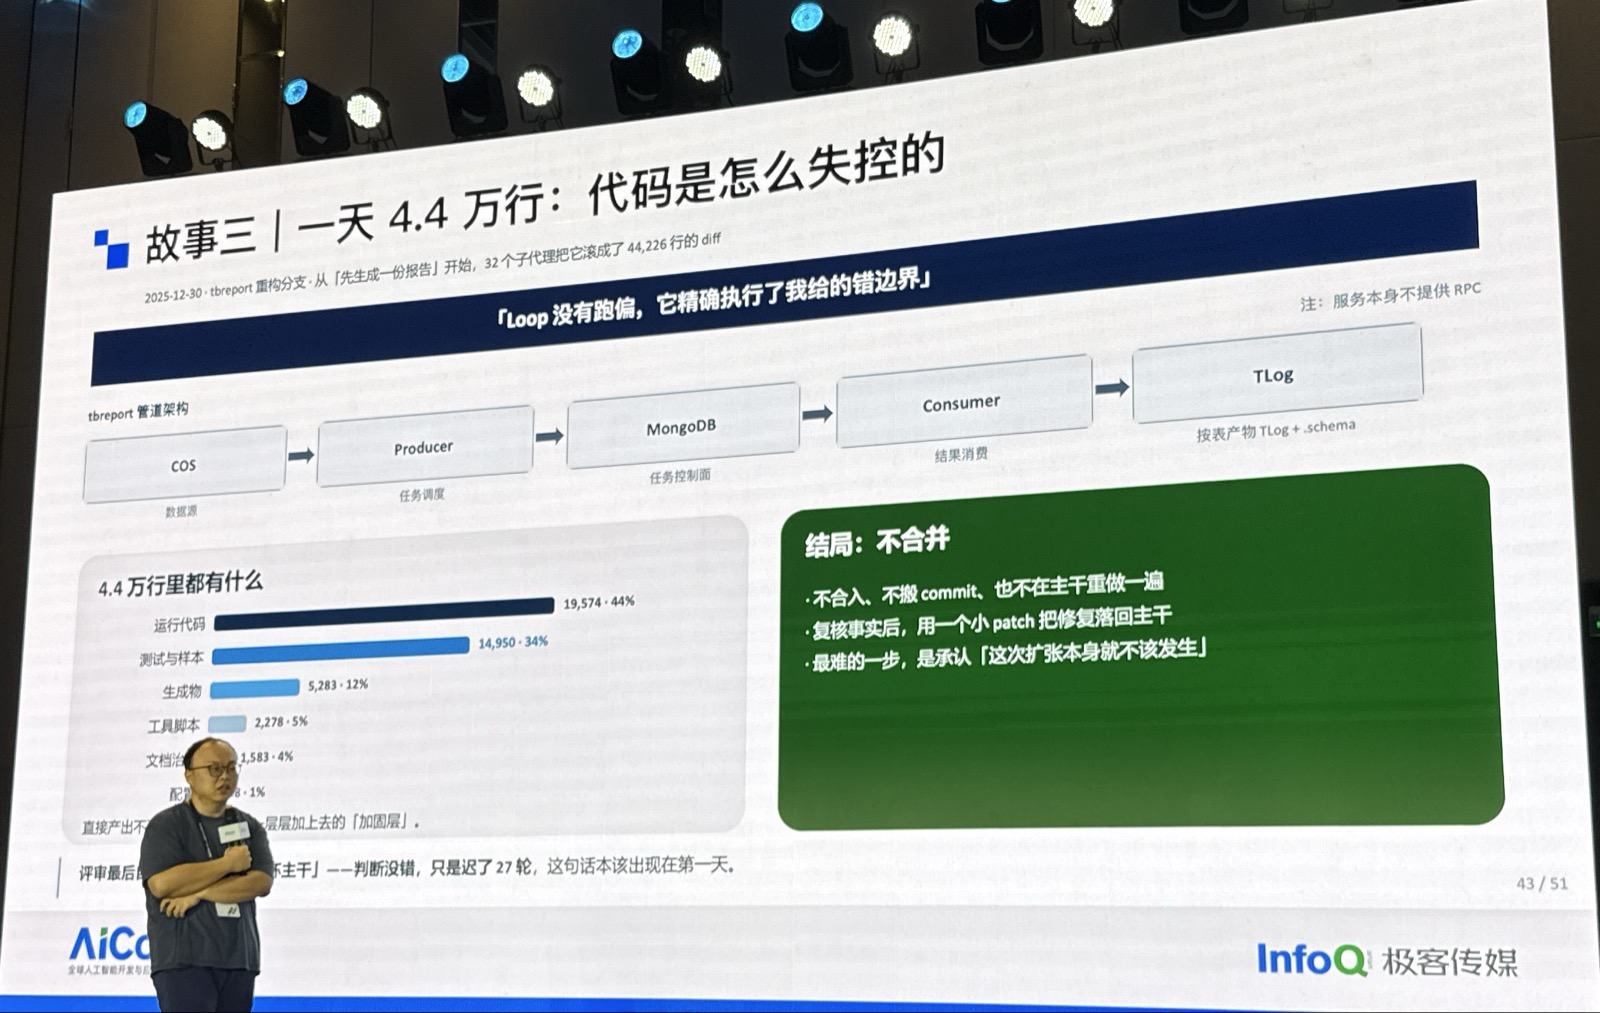
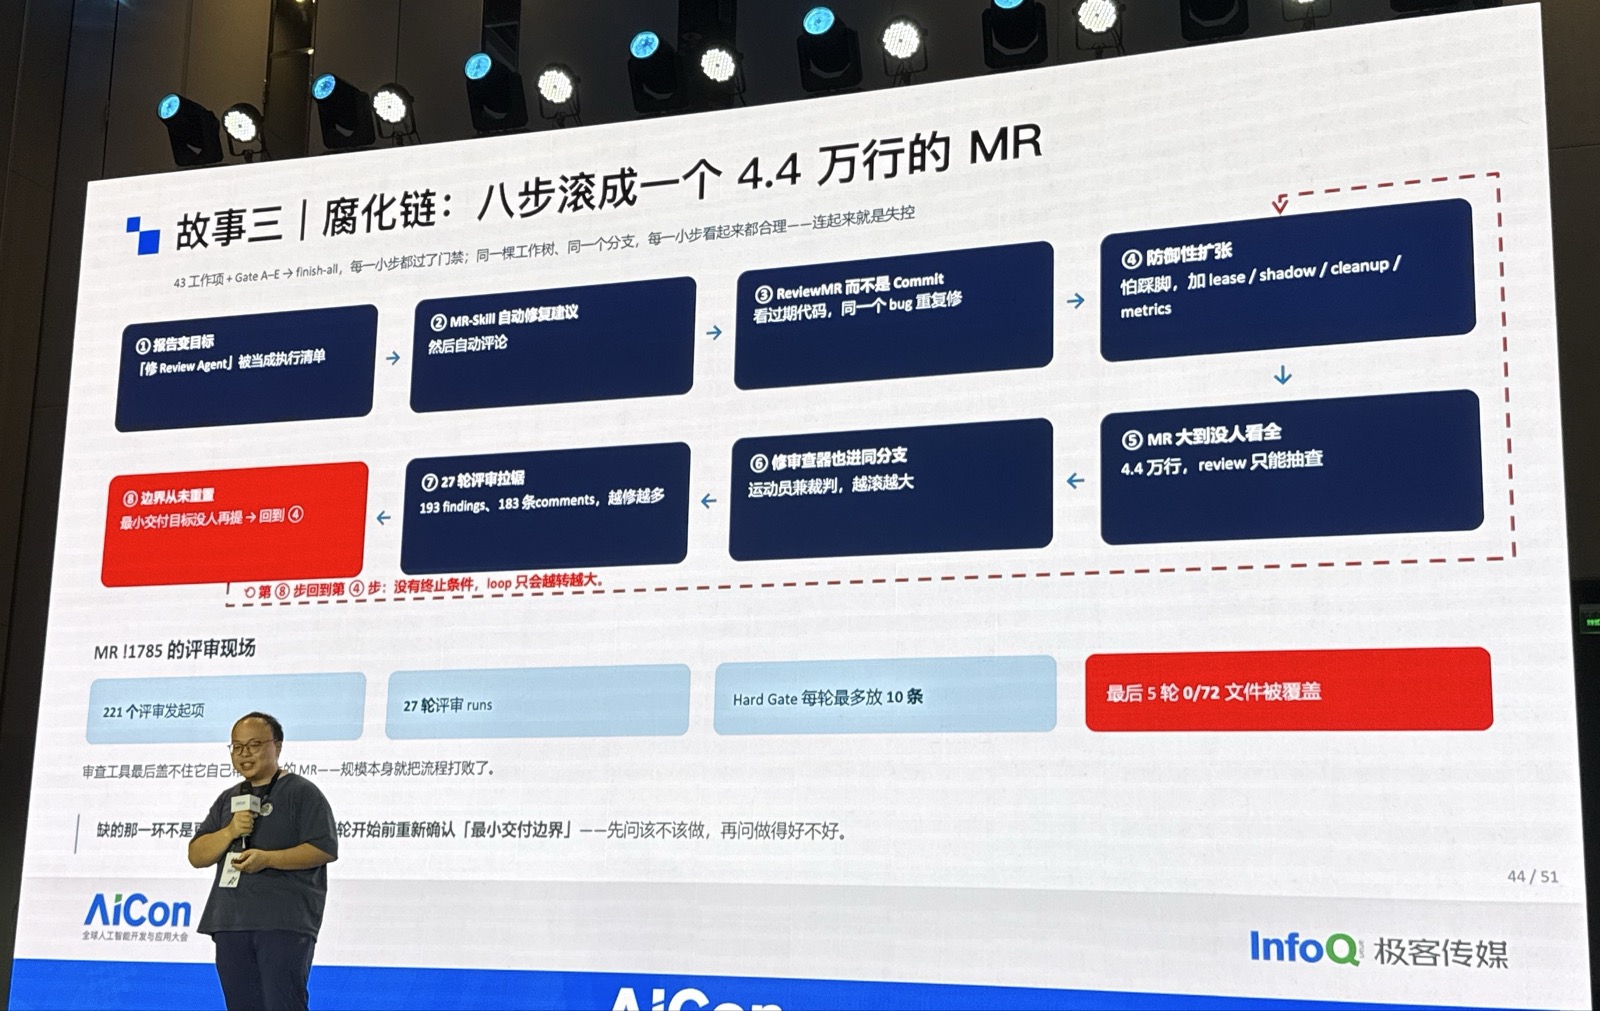
第二類問題是過度使用 Sub-Agent。早期因概念新鮮,幾乎每件事都加入 Sub-Agent 與 fork;後續檢視發現,部分日子的 token 用量異常達數億至十億級,原因是子 Agent 過多造成遞迴循環。第三類問題是 review 建議誘發防禦性程式碼膨脹:簡單資料轉換需求因持續加碼基礎設施、元件與防禦性設計,最終需要關閉迴路止血。
- 先判斷設計的是無界循環,還是具停止條件的 Closed Loop。
- 限制 Sub-Agent 數量、遞迴深度與 token 預算,避免 fork 擴散。
- 將審查建議與實際風險連結,避免「為了修建議而修建議」。
- 上下文、文件、規格與記憶都需要分層管理,不能無限回灌。
展望:以可信結構支撐夜間迭代與團隊信任
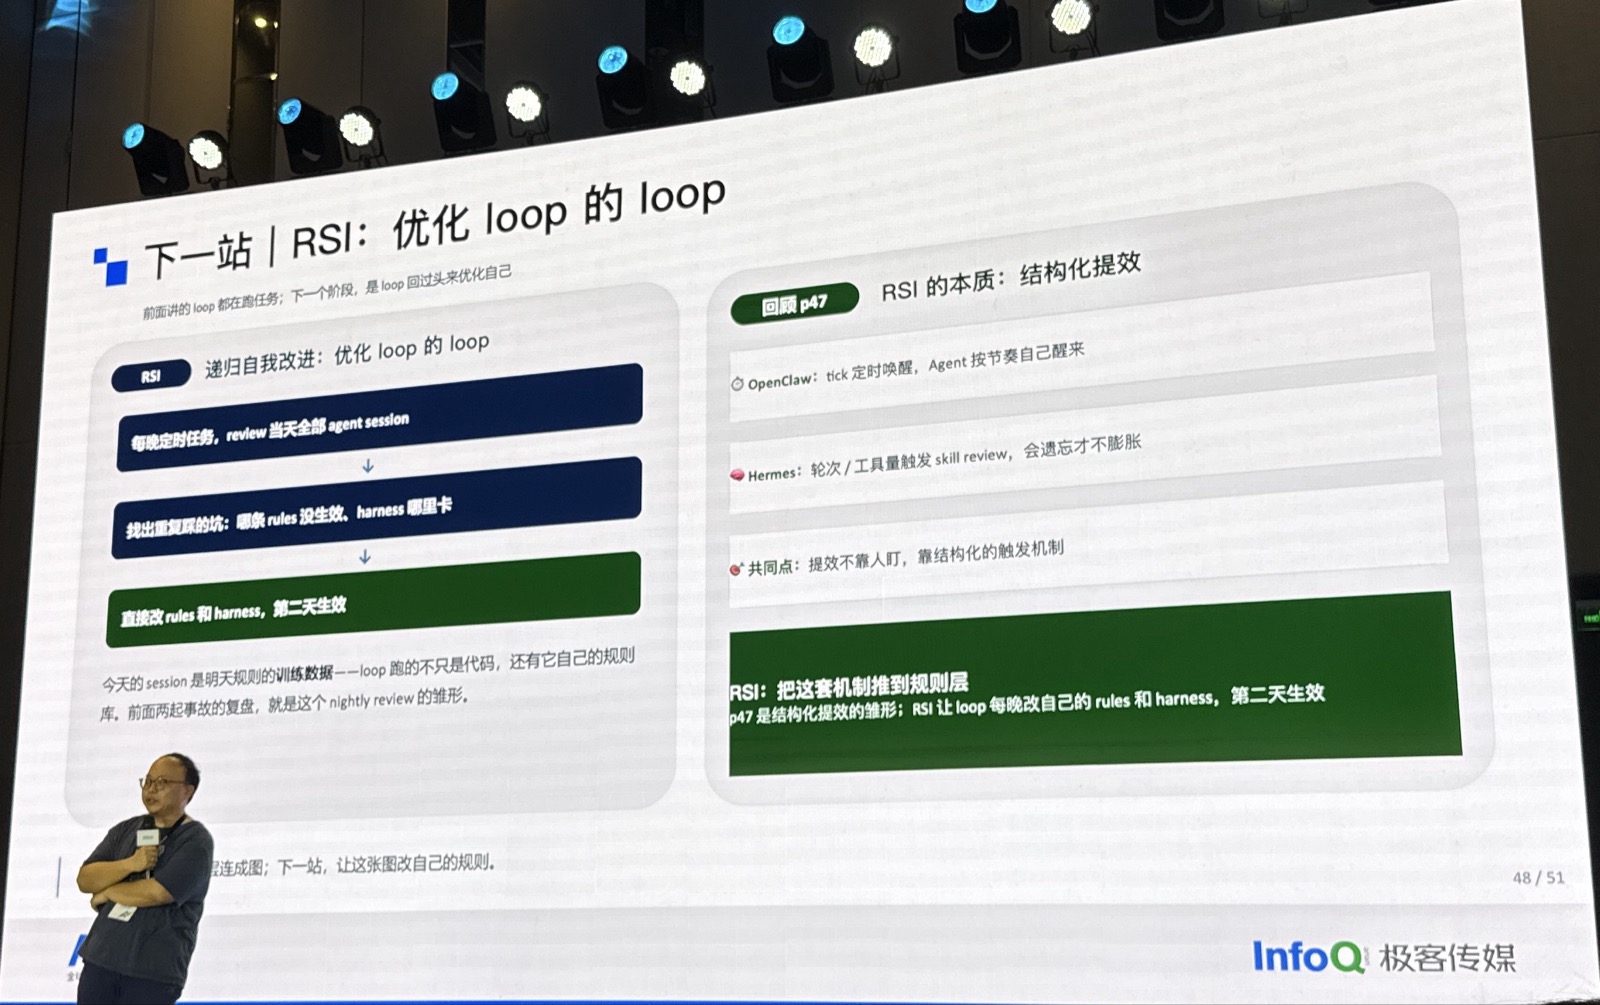
對於夜間 Loop,分享者認為可參考定時觸發、結構化程式碼與中斷機制:例如每日定時回顧當天的審查 session、找出重複踩坑並嘗試修正。重點不是抽象地追求「自我進化」,而是持續提升工程基礎設施,使既有模型能在可信結構內累積改進。
重點回顧
- Loop Engineering 的目標,是將 Agent 的不確定性轉為可交付、可驗證的迭代成果。
- Custom Linter、CI 自癒與規則觸發 review 是建立基礎可信度的第一步。
- 最佳的人機分工是:事前做結構化決策,事中讓 Agent 自主執行,事後集中審查與回灌。
- 評估重點應放在重複錯誤是否下降、評論是否更有效,而非只追求覆蓋率或 token 效率。
- 個人 Loop 必須透過 Graph Loop、插件化與情境化 SDD,才能擴展為團隊能力。
- 所有 Open Loop 都要有邊界、預算與停止條件;否則容易演變成上下文膨脹、遞迴與防禦性複雜度。